30秒でわかる答え
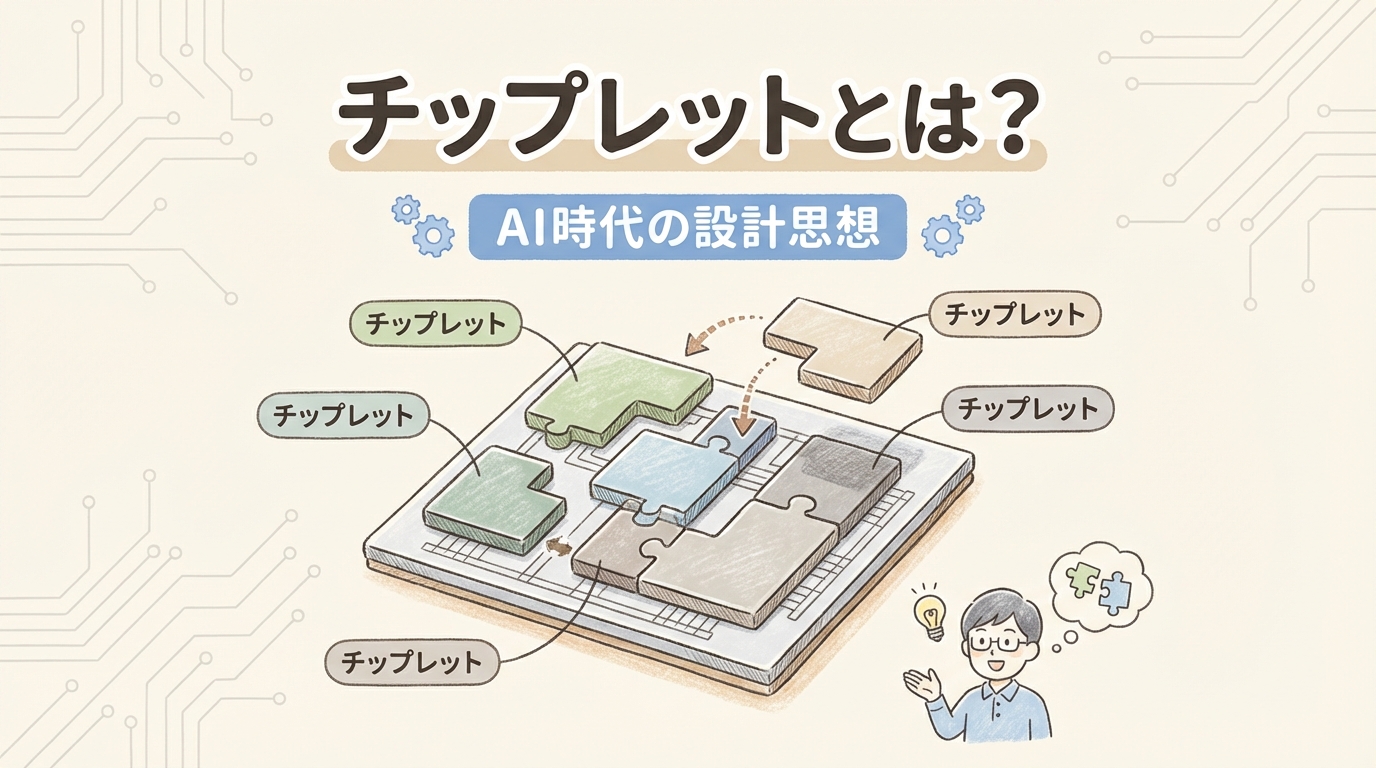
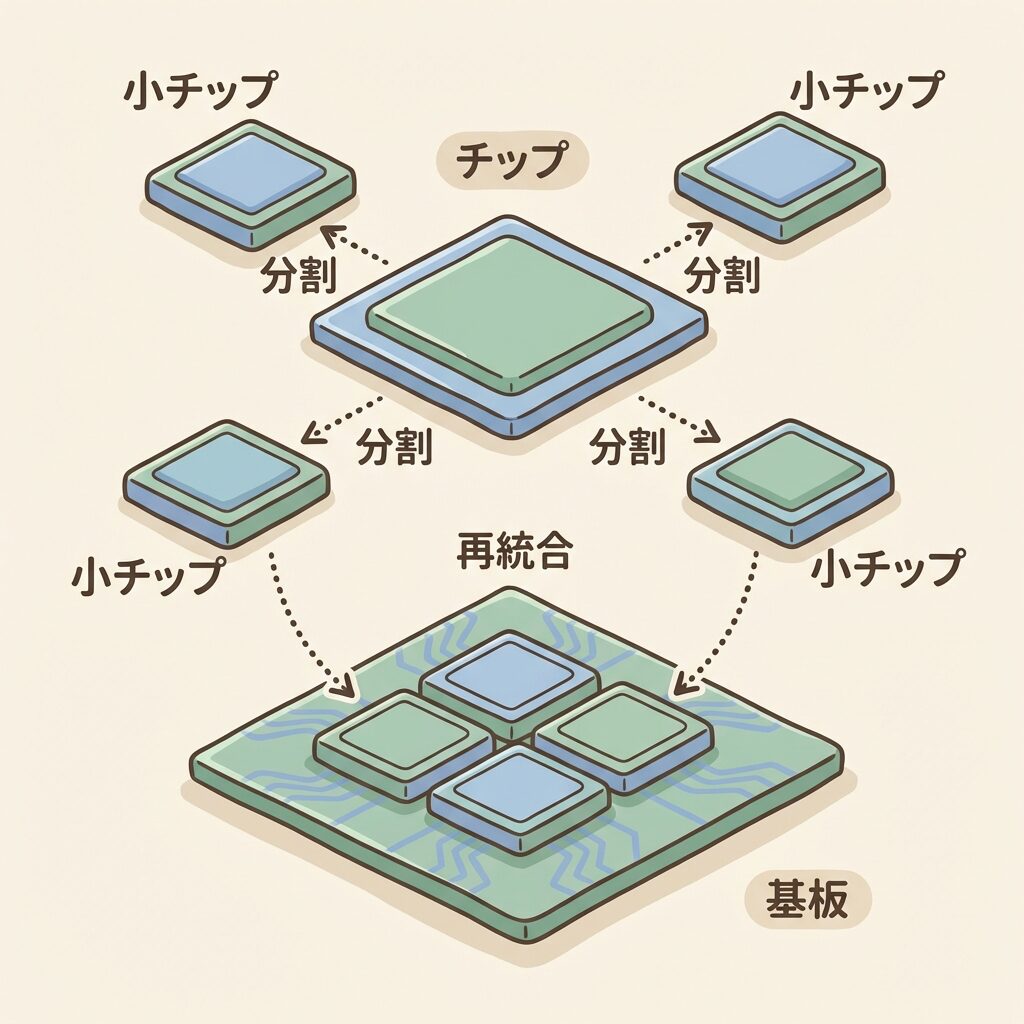
チップレットとは、1つの大きなチップを機能ごとの小さなチップ(ダイ)に分けて作り、先端パッケージの中でつなぎ直して1つの半導体として働かせる設計の方法です。
大きなチップほど不良が混ざりやすく、良品の割合(歩留まり)が下がります。小さく分けると良品をとりやすく、計算の部分だけ最新の製造技術で作るといった組み合わせもできます。AMDのCPUや、NVIDIAのBlackwell世代のGPUが代表例です。
こんな悩みはありませんか?
「チップレット」って最近よく聞くけど、結局なんなの?
モノリシックとチップレットの違いを聞かれても説明できない
なぜAMDやNVIDIAがチップレットに移行しているのか、構造的に理解したい
CoWoSや先端パッケージとの関係がわからない
投資やキャリアを考える上で、チップレットの重要性を判断できない
この記事でわかること
チップレットの定義を30秒で理解 ──「分割して再統合する」設計思想
モノリシックとの違い を「歩留まり」の仕組みから構造的に理解チップレットの4つのメリットと3つの課題 を図解
AMD・NVIDIAの採用事例 で「なぜ今主流なのか」を体感
UCIe規格 ──チップレットの「USB規格」が産業を変える理由先端パッケージ(CoWoS等)との「表裏一体」 の関係
学生・投資家にとっての意味と次の行動
先に結論
チップレットとは、1つの巨大なチップを機能ごとに小さなダイ(チップ片)に分割し、先端パッケージ技術で再統合する設計手法 です。「1枚の巨大チップ」を作るモノリシック設計と比べて、歩留まり(良品率)の向上・コスト削減・異なるプロセスの混載が可能になります。AMDはEPYC/RyzenでCPUチップレット設計の先駆者となり、NVIDIAもBlackwell B200で2つのGPUダイをCoWoS-Lで統合する「チップレットGPU」に進化しました。チップレットの市場規模は2025年の約520億ドルから2030年に約1,570億ドル へ成長する見通しです(出典:MarketsandMarkets )。チップレットは「設計思想」、それを実現するCoWoSなどは「実装技術」──両者はセットで初めて意味を持ちます 。
「チップレット」という言葉、AIや半導体のニュースで急に見かけるようになりましたよね。でも「結局何が新しいの?」「モノリシックとどう違うの?」と聞かれると、うまく説明できない──そんな方は少なくありません。
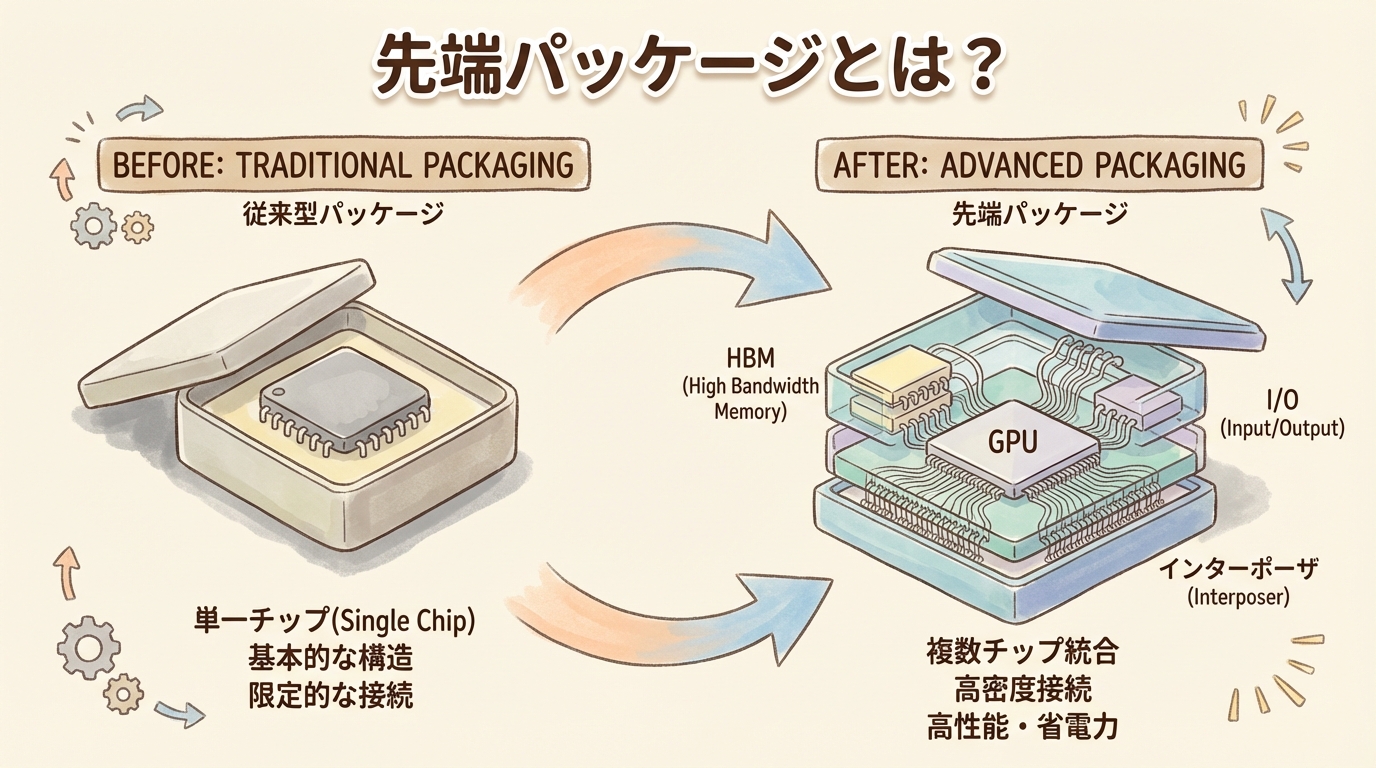
この記事では、チップレットとは何か・なぜ今主流になったのかを、構造とデータ で初心者でもわかるように解説します。前回の記事「先端パッケージとは? 」で全体地図を掴んだ方にとって、この記事は「チップレットという設計思想」に焦点を当てた深掘り編 です。
チップレットとは?──まず定義を30秒で理解する
「機能ごとに分割して、パッケージで再統合する」設計手法
チップレット(chiplet)とは、特定の機能(演算・メモリ制御・入出力など)を担う小さな半導体ダイ(チップ片) のことです。そして「チップレット設計」とは、1つの巨大チップを作る代わりに、機能ごとに分割した小さなチップレットを先端パッケージ技術で1つのパッケージに再統合する 設計アプローチを指します。
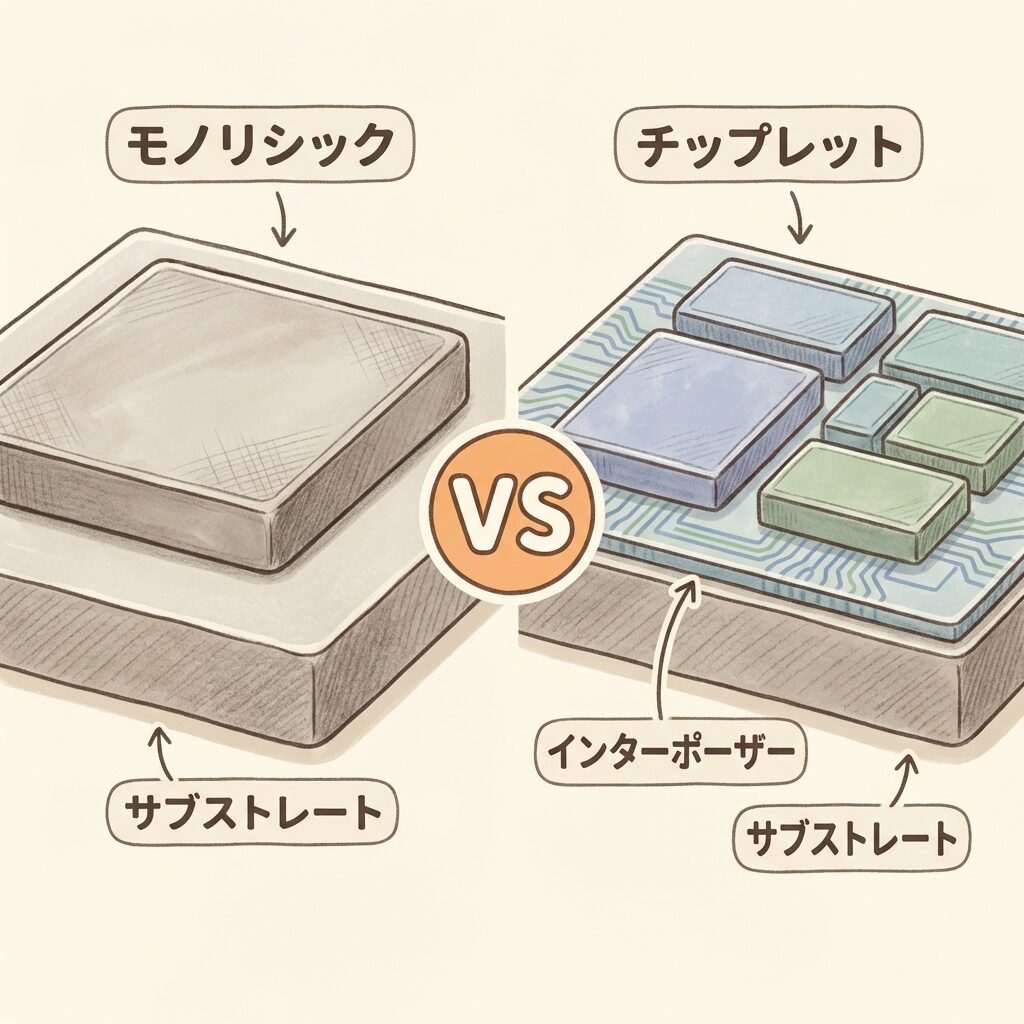
従来の「モノリシック(一枚岩)設計」では、CPU・GPU・メモリ制御・I/Oなどすべての機能を1枚の大きなシリコンダイに詰め込んでいました。チップレット設計はこの発想を逆転させ、「小さく作って、あとで組み合わせる」 ことで性能・コスト・柔軟性を同時に改善します。
たとえるなら…
モノリシック設計は「1枚の巨大なピザ 」。サイズが大きくなるほど焼きムラ(不良)が出やすく、1箇所でも焦げたら全部やり直し。チップレット設計は「小さなピザを何枚か焼いて、大きなプレートに並べる 」方式。1枚が焦げても、その1枚だけ作り直せばOK。味の異なるピザ(異なるプロセスで作ったチップ)を組み合わせることもできます。
用語メモ:ダイ(Die)
シリコンウェハーから切り出された、回路が形成された1片のシリコンチップのこと。「チップ」とほぼ同義。チップレットとは、特定機能に特化した小さなダイを指す。
チップレット
実装技術
CoWoS・EMIB等で
産業インパクト
歩留まり改善・コスト削減
チップレットの構造──部品ごとの役割 「チップレット 構造」と調べる方のために、チップレットで作るAI半導体の中身を、部品ごとに分けて整理しました。
部品 役割 ポイント
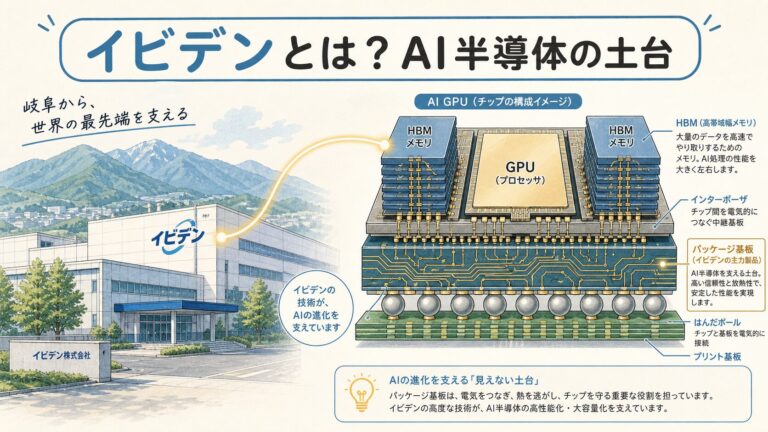
計算のチップ(コンピュートダイ) 計算を担う中心のチップ 最新の微細な製造技術で作ることが多い 入出力のチップ(I/Oダイ) 外部やメモリとのやりとりを担う 1世代前の製造技術でも作れるので、費用を抑えやすい HBM 計算のチップの横に置く高速のメモリ メモリの会社が作って持ち込む インターポーザー・ブリッジ チップどうしを細かい配線でつなぐ土台や橋 CoWoSの中間基板やEMIBのブリッジなど パッケージ基板 全体を載せて、プリント基板につなぐ土台 ABFなどの材料を使う UCIe(接続の規格) チップどうしのつなぎ方の共通ルール 違う会社のチップを組み合わせやすくする
モノリシック vs チップレット──何が違うのか
「1枚の巨大チップ」と「小さなダイの組み合わせ」
チップレットを理解するには、まず従来の「モノリシック設計」との違いを明確にすることが最短ルートです。比較カードで整理しましょう。
モノリシック設計(従来型)
1枚の巨大ダイ にすべての機能を集積すべて同じプロセスノード で製造(例:全部3nm)
ダイが大きいほど歩留まりが急低下
レチクルサイズ(約800mm²)が物理的上限
チップ内部の通信は超高速・低遅延
チップレット設計(現在の主流)
機能ごとに小さなダイに分割 して製造
各チップレットを最適なプロセス で製造可能(GPU→3nm、I/O→7nm等)
小さいダイは歩留まりが高い (コスト削減)
先端パッケージで再統合しレチクル制限を超越
チップレット間通信にインターコネクトが必要(遅延の課題)
用語メモ:モノリシック(Monolithic)
「一枚岩」を意味するギリシャ語が語源。半導体では、すべての回路機能を1枚の連続したシリコンダイに集積する設計を指す。NVIDIA H100 GPUダイ(約814mm²)は、モノリシック設計の代表例。
用語メモ:プロセスノード
半導体の製造技術の世代を示す数値(例:7nm、5nm、3nm)。数字が小さいほどトランジスタが微細で、性能が高い反面、製造コストも高い。チップレット設計では、高性能が必要な部分だけ最先端プロセスを使い、それ以外は成熟プロセスで製造できる。
比較項目
モノリシック
チップレット
ダイ構成
1枚の巨大ダイ
複数の小さなダイ
プロセス選択
全機能が同一プロセス
機能ごとに最適化可能
歩留まり
大型ダイほど低下
小型ダイで高い
チップ間遅延
なし(内部接続)
あり(インターコネクト経由)
サイズ上限
レチクルサイズ(~800mm²)
パッケージ技術次第で拡張可
設計柔軟性
低い(全体を再設計)
高い(一部だけ変更可能)
代表例
NVIDIA H100 GPUダイ
AMD EPYC(CPU+IOD)
なぜチップレットのほうが安くなるのか──「歩留まり」の構造
ダイが大きいほど「不良品」が増える数学的な理由
チップレットが注目される最大の理由は「コスト」──そしてコストの鍵を握るのが歩留まり(Yield) です。ここを構造的に理解しましょう。
用語メモ:歩留まり(Yield)
製造した半導体チップのうち、正常に動作する「良品」の割合。歩留まりが高い=良品率が高い=コストが低い。半導体製造の経済性を決める最も重要な指標の1つ。
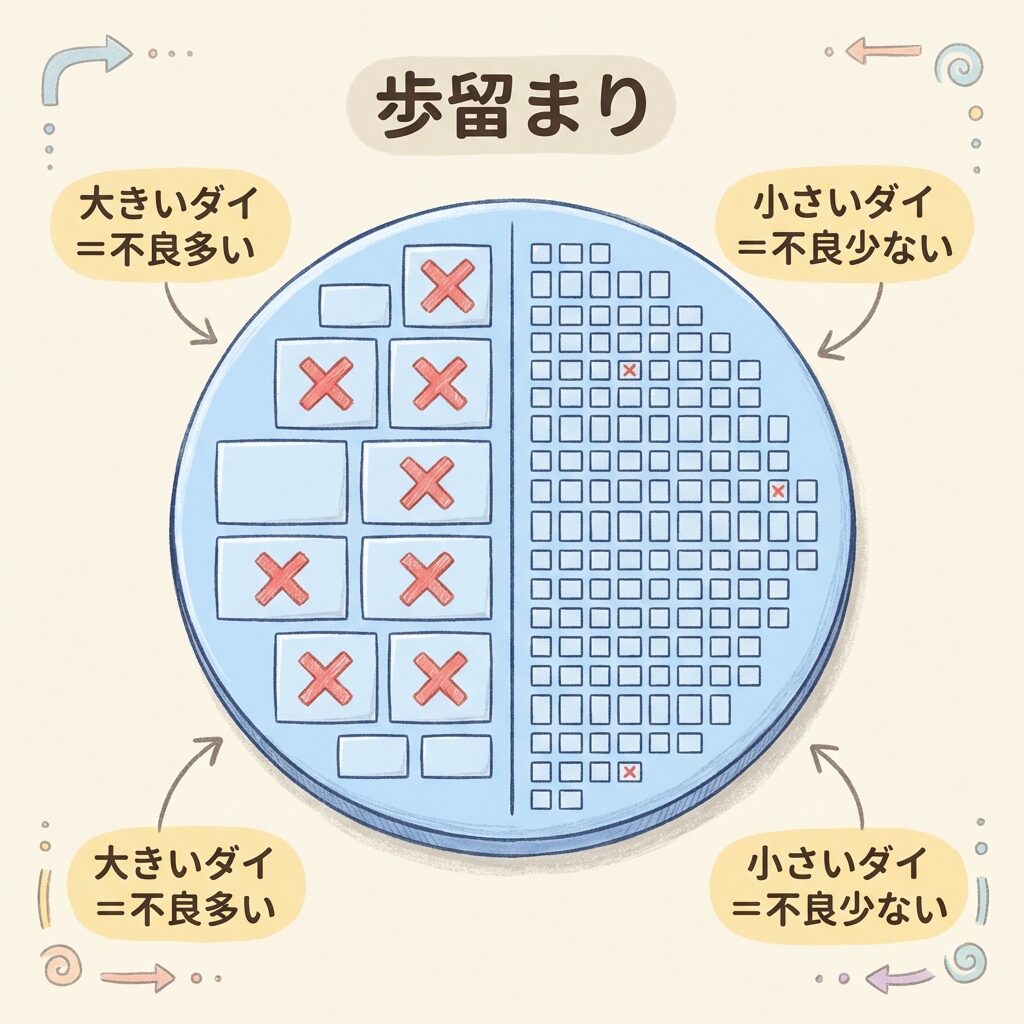
シリコンウェハー上には、製造中にどうしても微小な欠陥が発生します。この欠陥がダイの上に1つでも乗れば、そのダイは不良品です。ここでダイの面積が大きいほど、欠陥に「当たる」確率が高くなる ──これが歩留まりの本質です。
たとえるなら…
雨の中を走ることを想像してください。大きな傘 (大きなダイ)ほど雨粒(欠陥)に当たりやすい。小さな傘 (小さなチップレット)なら、雨粒が当たる確率はずっと低い。4つの小さな傘を組み合わせれば大きな面積をカバーできますが、1つの傘に雨粒が当たっても、残り3つは無事です。
モノリシック(800mm²ダイ)
ウェハー上に大きなダイを並べる。→ 欠陥がダイに1つでも乗れば全体が不良
チップレット(100mm²×8個)
同じ総面積でも、小さなダイに分割して製造。→ 個々のダイの歩留まりが高い
歩留まりの差をもう少し具体的な数字で見てみましょう。半導体の歩留まりは一般にポアソン分布モデル(Y = e-DA 、D=欠陥密度、A=ダイ面積)で近似されます。欠陥密度が同じなら、ダイ面積が2倍になると歩留まりは2乗的に低下 します(参考:東北マイクロテック )。
~50%
800mm²ダイの歩留まり
~90%
100mm²ダイの歩留まり
2倍以上
AMD試算のコスト削減幅
ポイント
AMDは、16コアのRyzen 9 3950Xにおいてチップレットアーキテクチャによりモノリシック設計に対して2倍以上のコスト優位性 があると公表しています(出典:Overclock3D / AMD )。チップレットの経済的メリットは理論だけでなく、実際の製品で実証済みです。
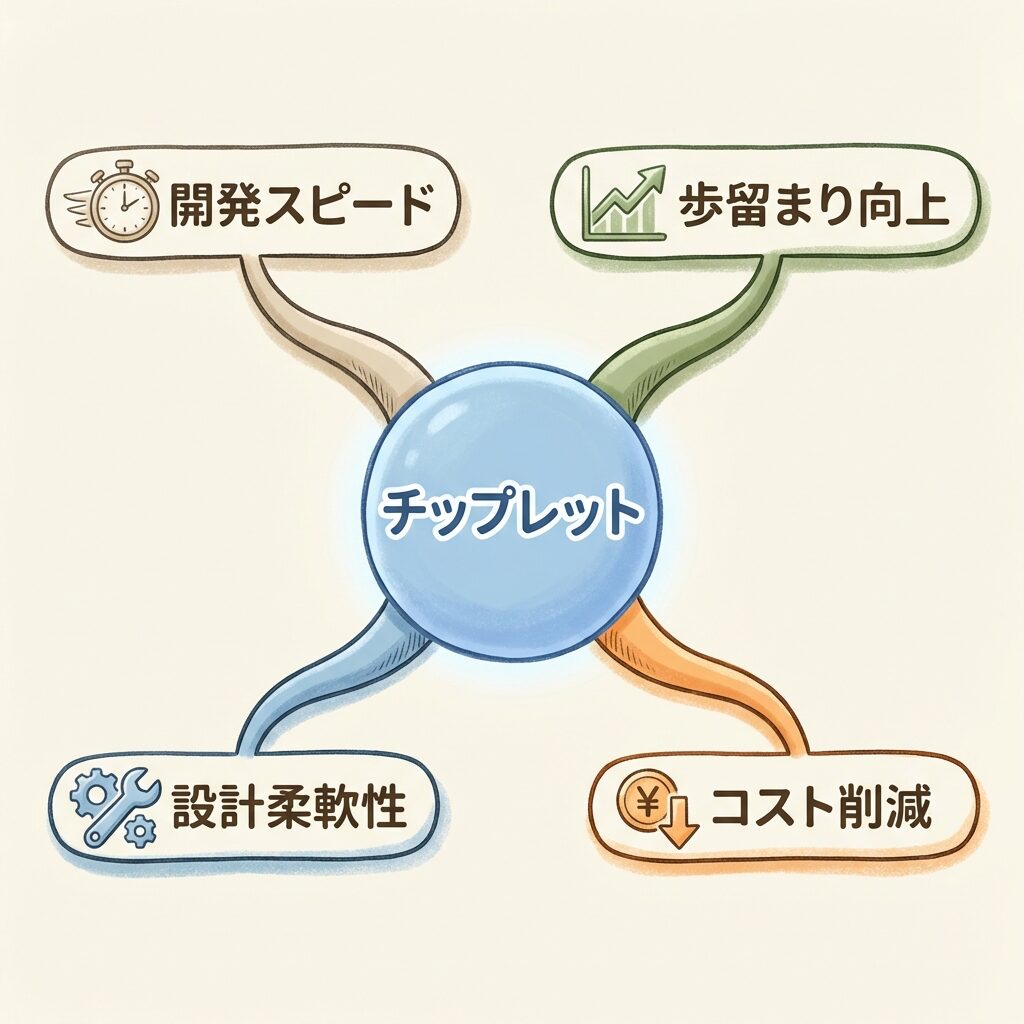
チップレットの4つのメリット──「なぜ今、主流なのか」
歩留まり・コスト・柔軟性・スピードの4軸で優位
① 歩留まり向上
小さなダイは欠陥に当たる確率が低い。不良ダイだけ廃棄でき、全体の良品率が上がる。
② コスト削減
高性能が必要な部分だけ最先端プロセスを使い、I/O等は安い成熟プロセスで製造できる。
③ 設計柔軟性
機能ごとのチップレットを「レゴブロック」のように組み換え可能。1つだけアップグレードも可。
⏱️
④ 開発スピード
既存チップレットを再利用可能。全体を再設計する必要がなく、製品投入が早くなる。
特に②の「プロセスの混載」は、モノリシックでは不可能だった大きな利点です。たとえばAMDのEPYCプロセッサでは、CPUコアのチップレット(CCD)は最先端の5nmプロセス で製造し、I/Oダイ(IOD)はコストの安い6nmプロセス で製造しています。すべてを5nmで作る必要がないため、大幅なコスト削減が可能になります(参考:西進商事 )。
用語メモ:ヘテロジニアスインテグレーション(異種チップ統合)
異なるプロセスノード・異なる機能・異なるメーカーのチップレットを1つのパッケージに統合する技術思想。チップレット設計の本質であり、「最適な場所に最適な技術を」という考え方。
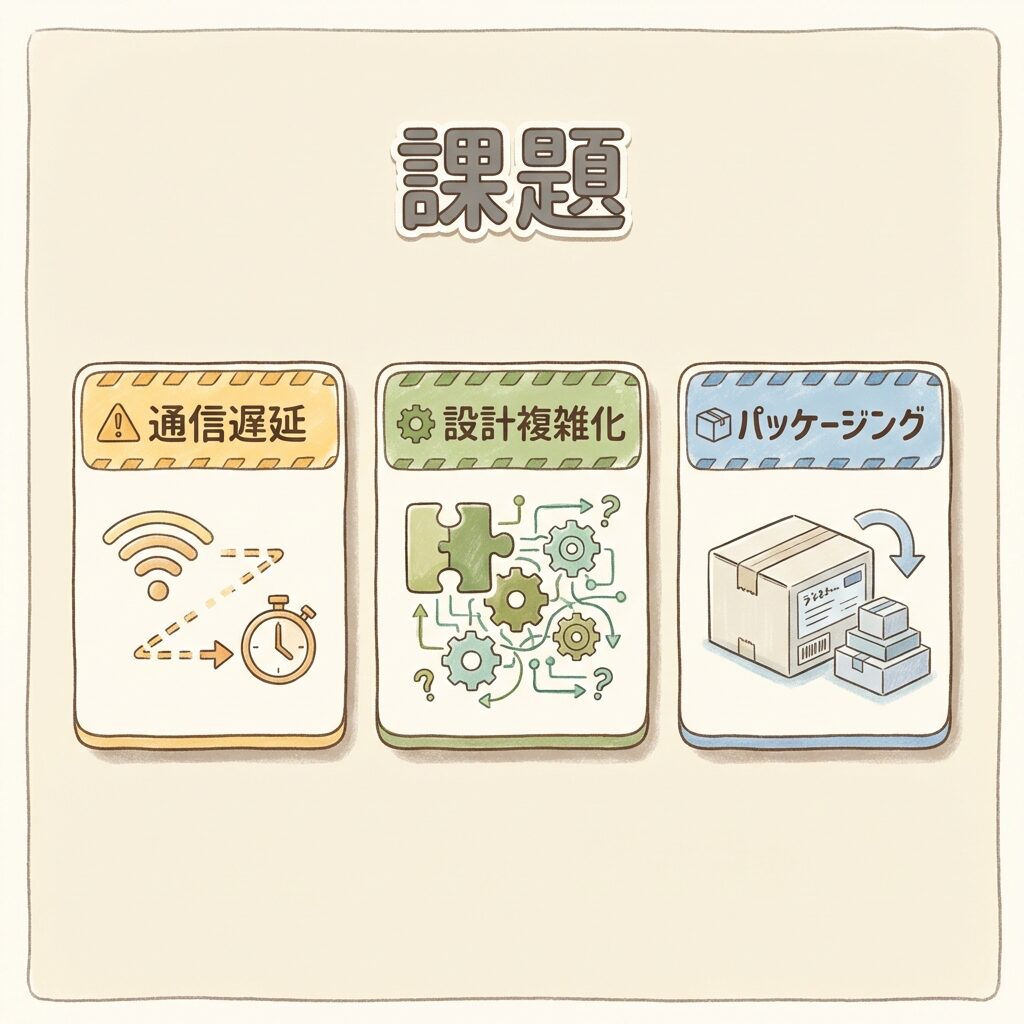
チップレットの3つの課題──万能ではない理由
インターコネクト・設計複雑性・パッケージング
チップレットにはメリットだけでなく、乗り越えるべき課題もあります。「チップレットが万能」と思い込むのは危険です。3つの構造的課題を整理します。
課題 1
チップレット間の通信遅延と消費電力
課題 2
設計と検証の複雑化
課題 3
先端パッケージングが必須
よくある誤解 「チップレットにすれば必ず安くなる」と思われがちですが、先端パッケージの製造コスト(CoWoS等)はチップレット設計に追加のコストをもたらします。チップレットのコストメリットが上回るのは、ダイサイズが十分に大きく、歩留まりの改善効果がパッケージングの追加コストを超える 場合です。小型チップではモノリシックのほうが安くなることもあります。
採用事例で理解する──AMD・NVIDIAはなぜチップレットに移行したのか
AMDの先駆者的チップレット戦略
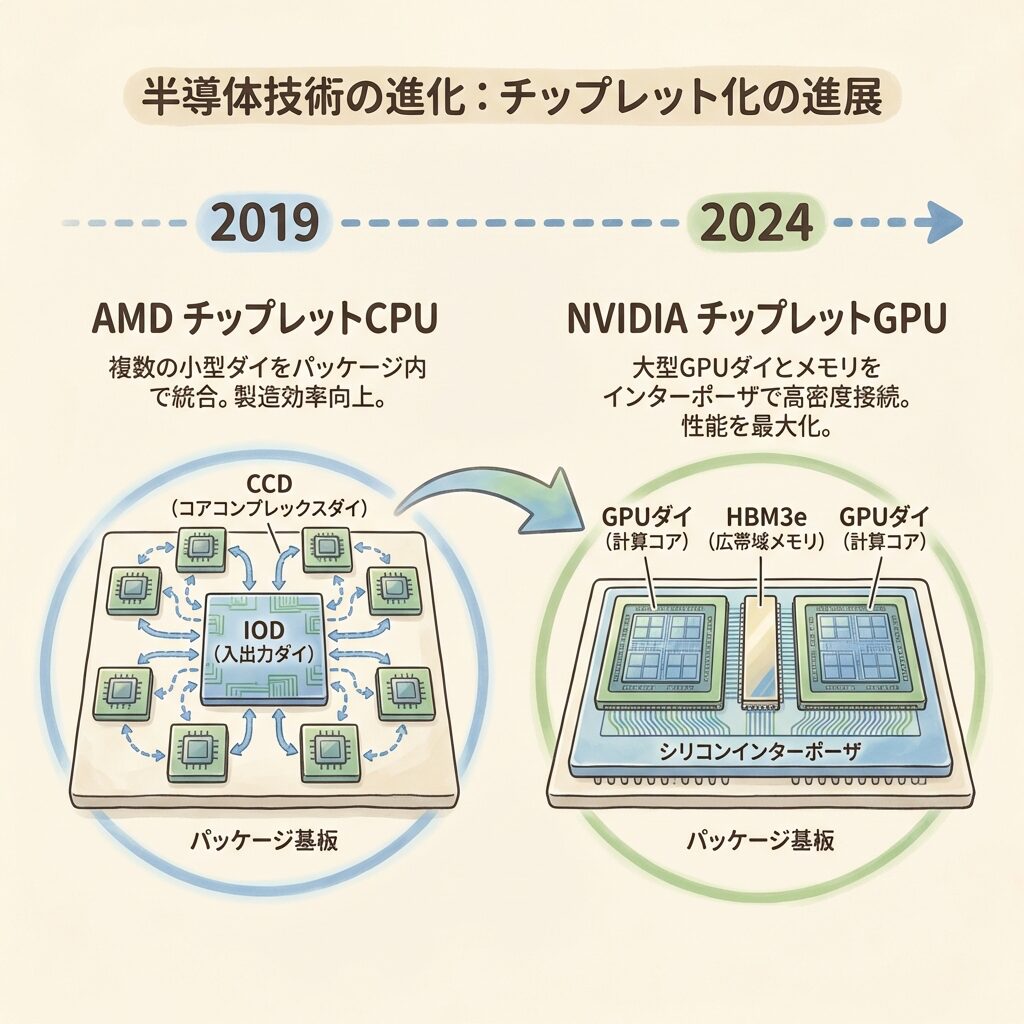
チップレット設計を世界に証明したのはAMD です。2019年のEPYC Rome(第2世代EPYC)で、CPUにチップレットアーキテクチャを本格導入しました。
AMD EPYC Rome / Genoa のチップレット構成
CCD8コア
CCD8コア
CCD8コア
CCD8コア
IOD(I/Oダイ)メモリ制御・PCIe・Infinity Fabric │ 6nm
CCD8コア
CCD8コア
CCD8コア
CCD8コア
CCD(5nm)×最大8個 + IOD(6nm)×1個 = 最大64コアCPU
AMDの戦略は明快です。CPUコアの「計算エンジン」は最先端の5nmで性能を追求 し、メモリ制御やPCIeなどのI/O機能は、性能がそれほど要求されないため安い6nmで製造 する。これにより、すべてを5nmで作るモノリシック設計と比べて大幅なコスト削減を実現しました(出典:AMD EPYC Architecture White Paper )。
NVIDIAのチップレットGPU──Blackwell B200
NVIDIAはH100まではモノリシック設計を貫いてきましたが、Blackwell世代(B200)でついにチップレット設計に移行 しました。B200は2つのGPUダイを10TB/sの超高速インターコネクトで接続し、「1つのGPU」として動作します(出典:NVIDIA公式 )。
2020年 ── A100
モノリシックGPUダイ(826mm²)+ CoWoS-S + HBM2E×5スタック
2022年 ── H100
モノリシックGPUダイ(814mm²)+ CoWoS-S + HBM3×5スタック。レチクルサイズぎりぎり。
2024年 ── B200(Blackwell)チップレット化
2つのGPUダイ (各ダイ約800mm²級)を10TB/sインターコネクトで接続。2,080億トランジスタ。CoWoS-L + HBM3E×8スタック。モノリシックの限界を超えた最初のNVIDIA GPU。
2026年〜 ── Vera Rubin(次世代)
さらにHBMスタック数の増加が予想され、CoWoS-Lの5.5〜9レチクル対応への拡張とともに進化する見通し。
ポイント NVIDIAがB200でチップレットに移行した最大の理由は、レチクルサイズの壁 です。H100のダイ(814mm²)はすでにレチクル限界ぎりぎりでした。さらに性能を上げるには、1枚のダイでは物理的に収まらない──だから2つのダイに「分割」し、CoWoS-Lで再統合したのです。
UCIe──チップレットの「USB規格」が産業を変える
異なるメーカーのチップレットを「つなぐ」共通言語
チップレット設計の普及を阻む最大の壁の1つが、「各社のチップレットをどうつなぐか」という問題です。AMDのチップレットにNVIDIAのメモリを組み合わせたい──でも、接続規格がバラバラでは実現できません。
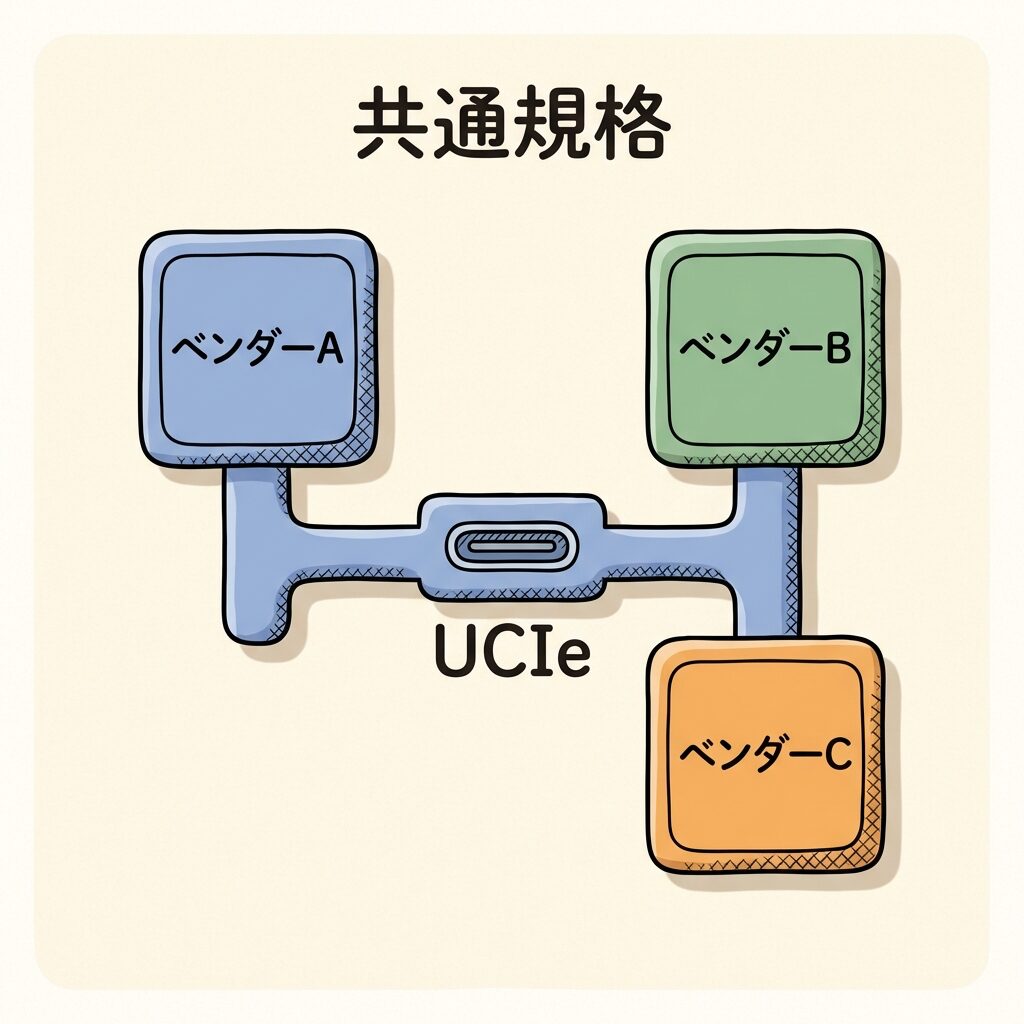
この問題を解決するために生まれたのがUCIe(Universal Chiplet Interconnect Express) です。2022年に Intel・AMD・Arm・TSMC・Samsung・Google・Microsoft などが参加して策定された、チップレット間通信の業界標準規格 です(出典:UCIeコンソーシアム公式 )。
たとえるなら…
UCIeは「チップレット版のUSB規格」です。USBが登場する前、プリンターやマウスはメーカーごとに違うコネクタでした。USBが「共通の差し口」を決めたことで、どのメーカーのデバイスもつなげるようになった。UCIeは同じことを、半導体パッケージの内部 で実現しようとしています。
用語メモ:UCIe(Universal Chiplet Interconnect Express)
チップレット間のダイ・ツー・ダイ通信を標準化するオープン規格。物理層(配線の仕様)・プロトコル層(通信ルール)・ソフトウェアスタックを規定。2022年にUCIe 1.0、2024年8月にUCIe 2.0がリリースされ、3D積層(縦方向接続)やテスト・管理の仕様も追加された。
UCIeの普及は、半導体産業に大きな変化をもたらす可能性があります。現在は各社が自社のチップレットを自社のパッケージ技術で統合するのが主流ですが、UCIeが普及すれば「A社のGPUチップレット+B社のI/Oチップレット+C社のメモリ制御チップレット」を自由に組み合わせる 時代が来るかもしれません。まだ完全には実現していませんが、標準化が進むことでチップレット市場の拡大が加速すると見られています。
ひとことメモ
日本では東京工業大学が「チップレット集積プラットフォーム・コンソーシアム」を設立し、自動車用先端SoC技術研究組合(ASRA)もチップレットの車載応用を推進しています。
チップレットと先端パッケージは「表裏一体」
「設計思想」を「実装技術」が支える構造
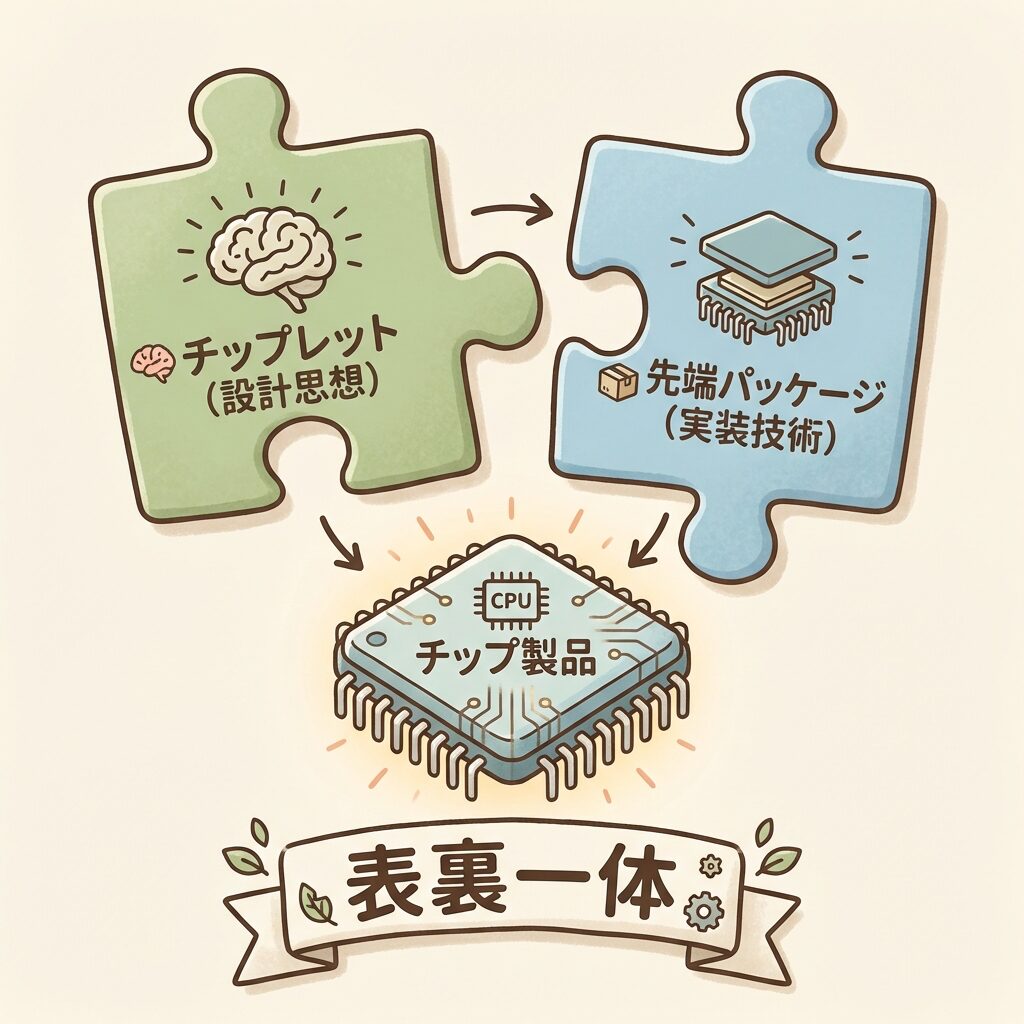
ここまで読んで「チップレットとCoWoSの違いがわからない」と感じた方もいるかもしれません。両者の関係を整理しましょう。
+
先端パッケージ
= 実装技術
=
AI時代の半導体
NVIDIA B200
チップレットは「こう設計しよう」という発想・アーキテクチャ であり、CoWoS・EMIB・SoICは「その設計を現実の製品にする」ためのパッケージ実装技術 です。チップレットだけあっても、それを統合するパッケージ技術がなければ製品にならない。逆に、パッケージ技術だけあっても、分割されたチップレットがなければ活かす対象がない。両者はセットで初めて意味を持ちます。
先端パッケージ技術
ベンダー
チップレット統合での役割
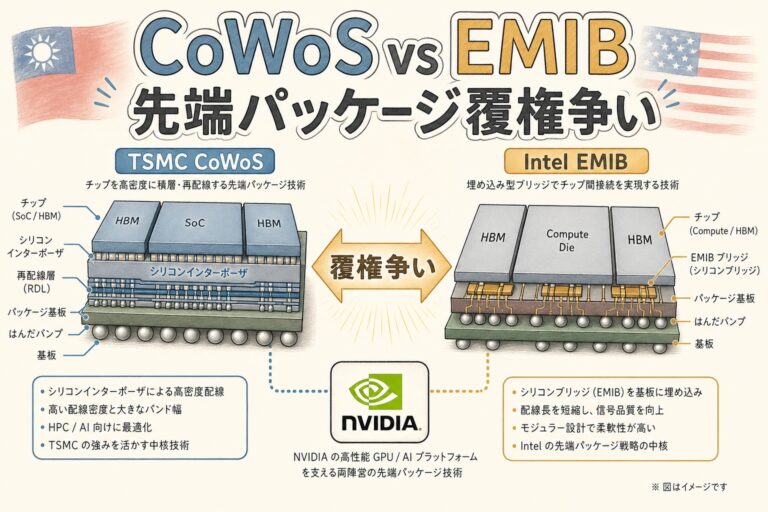
CoWoS-S / CoWoS-L
TSMC
GPU+HBMを2.5Dで横並び統合
EMIB
Intel
小型シリコンブリッジでダイ間を接続
Foveros
Intel
チップレットを3D積層で垂直統合
SoIC
TSMC
ハイブリッドボンディングで超高密度3D統合
チップレット市場:2030年に約1,570億ドル規模へ
CAGR 24.8% ── AI需要がけん引する急成長
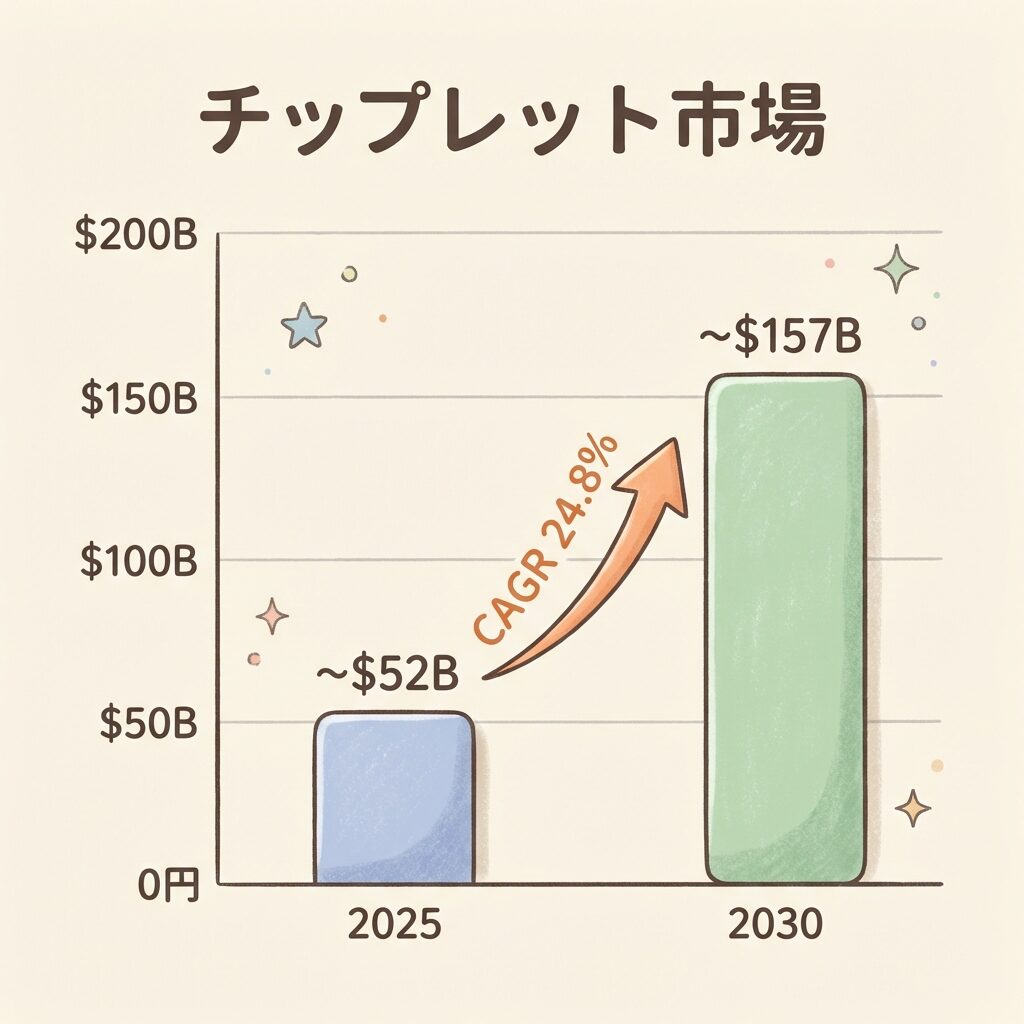
チップレット市場は、AI・HPC・データセンター需要を背景に急速に拡大しています。MarketsandMarketsの予測によると、チップレット市場は2025年の約519億ドルから2030年に約1,572億ドル へ、CAGR(年平均成長率)24.8% で成長する見通しです(出典:MarketsandMarkets / PR Newswire )。
この成長をけん引しているのは、NVIDIA GPU・AMD EPYC・IntelのXeonプロセッサなど、AI・HPCワークロードで使われるチップレット設計の製品群 です。チップレットの相互接続規格(UCIe)の標準化、AI GPUのHBMスタック数増加に伴うパッケージの大型化、そしてデータセンター投資の拡大が複合的に市場を押し上げています。
あなたにとっての意味
投資家: チップレット市場の成長は、NVIDIA・AMDだけでなく、パッケージ基板(イビデン・新光電気)、実装装置(ディスコ・東京エレクトロン)、素材(レゾナック・味の素ファインテクノ)にも構造的な追い風。学生: CAGR 24.8%の成長市場は、就職・研究テーマ選びの有力な指標。EDA・パッケージ設計・材料科学のスキルが今後ますます求められる。
よくある誤解を整理する
よくある誤解
実際はこう
「チップレットにすれば必ず安くなる」
先端パッケージの追加コストがかかるため、ダイサイズが十分に大きく歩留まり改善が追加コストを上回る場合 にのみコストメリットが出る。小型チップではモノリシックのほうが安いこともある。
「チップレット=先端パッケージ」
チップレットは設計思想 であり、先端パッケージは実装技術 。両者は表裏一体だが同じものではない。チップレットを実現する「手段」が先端パッケージ。
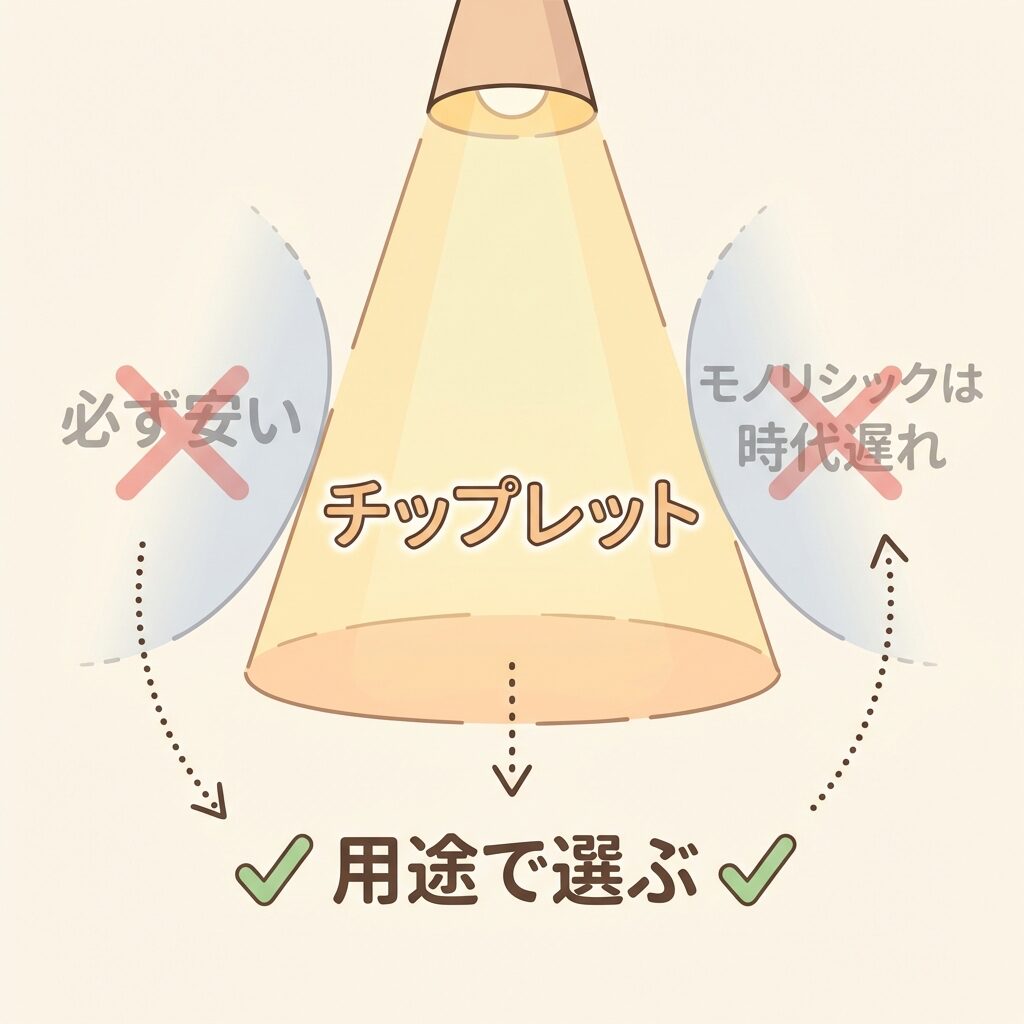
「モノリシックは時代遅れ」
小型・高速・低遅延が求められるチップでは、モノリシック設計が最適な場合もある。Apple M4や一部のスマホSoCは依然としてモノリシック。チップレットとモノリシックは「優劣」ではなく「用途の違い」。
「UCIeで異メーカーのチップレットを自由に組み合わせられる」
UCIeは標準規格を整備中だが、現時点では各社が自社内でチップレットを統合するのが主流 。異メーカー間の「レゴのような自由な組み合わせ」はまだ発展途上。
「チップレットは最近の技術」
マルチチップモジュール(MCM)の概念自体は数十年前から存在。AMDが2019年にEPYC Romeで商用化し注目されたが、発想自体は新しくない。変わったのは先端パッケージ技術が追いついたこと。
この記事のテーマを、本でもっと深く PR(アフィリエイト広告)
チップレットの背景にある半導体の製造と業界の全体像を知りたい方に。本書(SBクリエイティブ)は、前工程・後工程・材料の章に加え、AI向け半導体の進化や最新動向も、図解で紹介しています。
よくある質問(FAQ)
Q. チップレットとは何ですか?
A. 1つの大きなチップを機能ごとの小さなチップに分けて作り、パッケージの中でつなぎ直す設計の方法です。
Q. チップレットとモノリシックの違いは?
A. モノリシックは全部の機能を1枚の大きなチップに作る方法、チップレットは小さなチップに分けてつなぎ直す方法です。
¥1,980 (2026/10/05 21:02時点 | Amazon調べ)
ポチップ
S
シラス
電験三種・QC検定1級 / メーカーでパワエレ設計・品質保証 実務10年
メーカーで回路設計と生産技術(品質改善)に携わってきた経験をもとに、AIインフラを支える半導体・電力・冷却の仕組みを、図解でやさしく解説しています。
テーマ別に、もっと深く学ぶ 気になるところから読んでも大丈夫です。どの記事も、はじめての方にもわかるように図解で書いています。
HBM・先端パッケージをもっと深く
つまずきやすい「違い」を解決
あわせて知りたい、隣のテーマ




コメント