
AIの計算では、GPUがいくら速くても、メモリからデータが届かなければ手が止まります。HBMは「近くに置き、たくさんの線で運ぶ」ための形です。だからNVIDIAのH100から次のRubinまで、AI向けのGPUの横には必ずHBMが並んでいます。
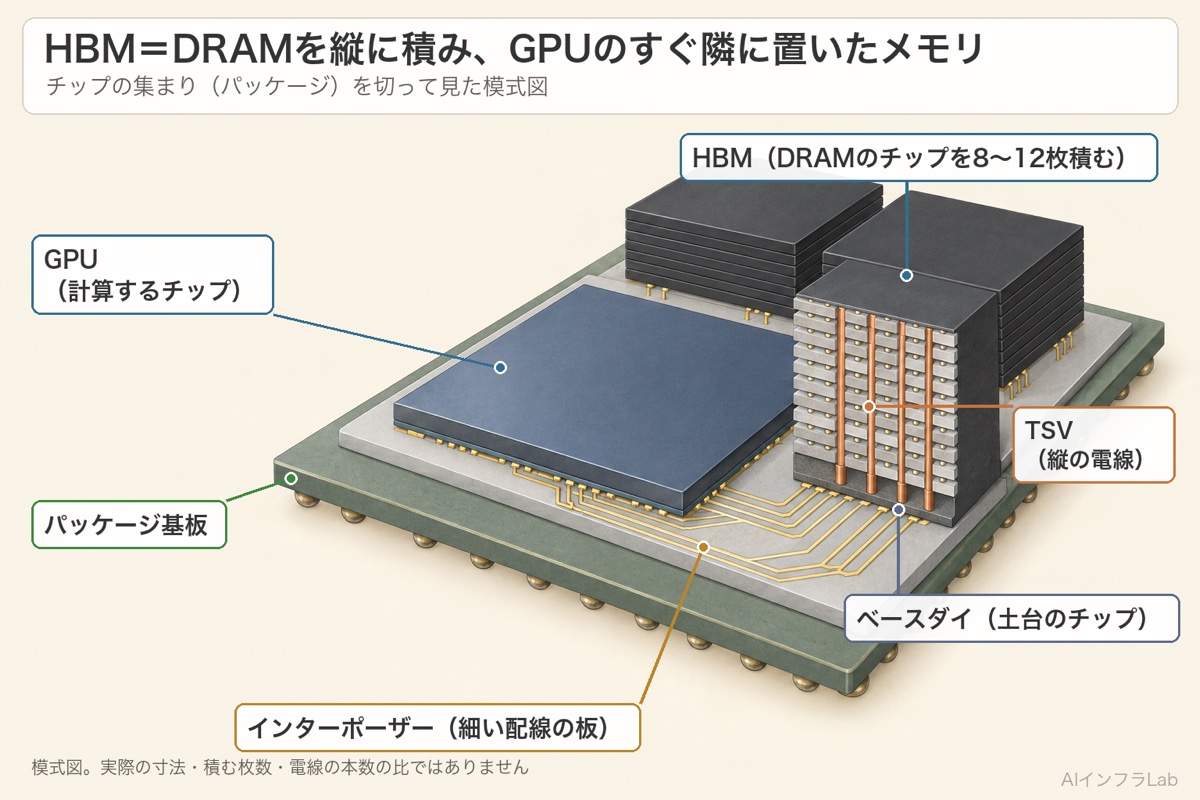
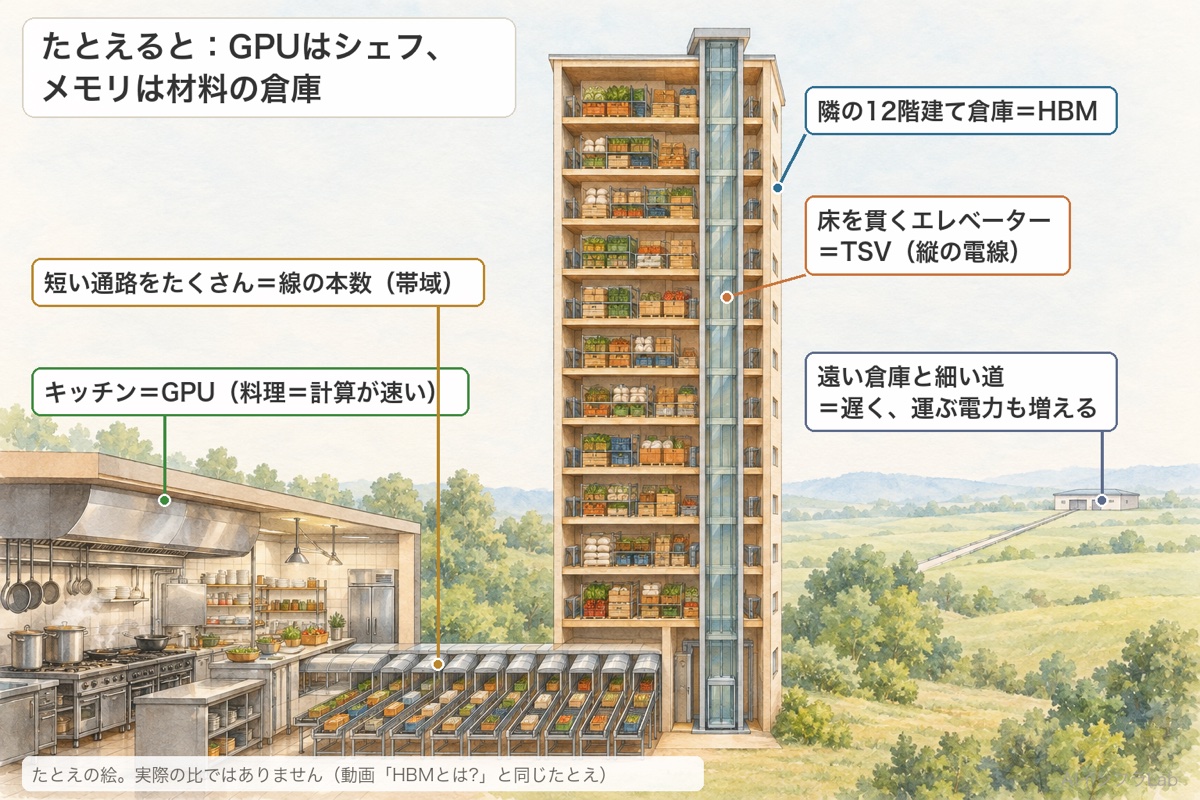
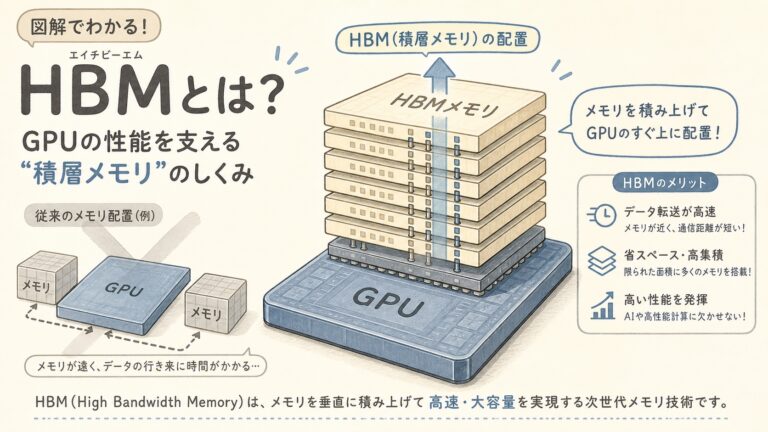
この記事を書き直したのは、「hbm gpu」「gpu hbm」と、GPUとの関係から探しに来る人が多かったからです。そこで最初に、HBMがGPUのどこにあり、中がどうなっているかを1枚の図で見せます。たとえは、YouTubeの動画と同じ「シェフと倉庫」を使います。
HBMとは?読み方と意味
HBMの読み方は「エイチ・ビー・エム」です。High Bandwidth Memory(ハイ・バンドウィドス・メモリー)の頭文字で、日本語では高帯域幅メモリ、または広帯域メモリと訳されます。
HBMは部品の種類の名前で、決まりは半導体の業界団体JEDEC(ジェデック)が規格として出しています。後ろに付くHBM3・HBM3E・HBM4は、世代の名前。
ひとつ注意があります。電気製品の品質の仕事でHBMと言えば、静電気の試験の人体モデル(Human Body Model)の略でもあります。人の指から部品へ静電気が飛ぶ場面をまねた試験の名前で、この記事のメモリとは別物。「HBM キャリブレーション」「HBM 試験」で探しているなら、そちらの話です。
なぜGPUにHBMが必要か(メモリの壁)
GPUは計算が速すぎて、メモリからデータが届くのを待ってしまうからです。この待ちはメモリの壁(メモリウォール)と呼ばれます。HBMは、運ぶ線の本数を増やし、線を短くして、この待ちを減らします。
AIは答えを1文字出すたびに、モデルの大きな数字の表(重み)をメモリから読み直します。計算そのものより、表を運ぶ時間で止まりやすい。ここがAIのメモリの使い方の特徴です。
運べる量は「線の本数×1本の速さ」
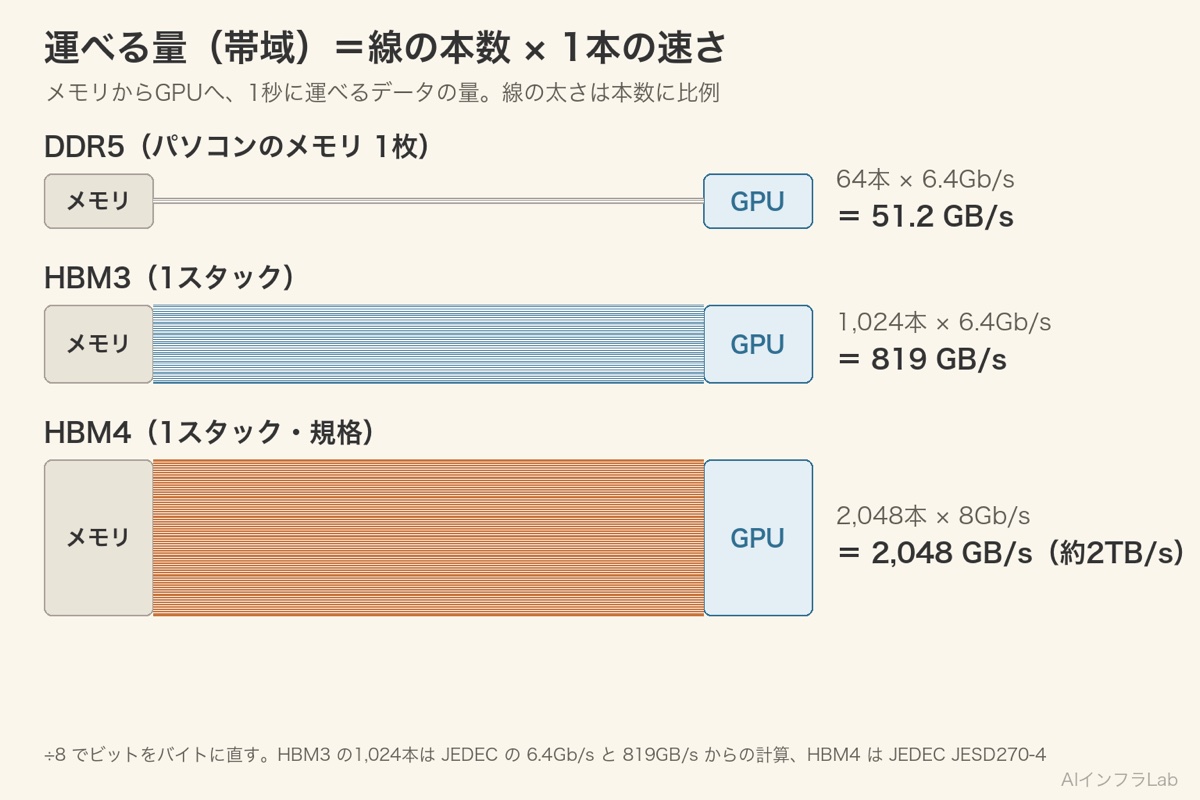
メモリからGPUへ1秒に運べる量(帯域。メモリの速度のこと)は、線の本数×1本の速さで決まります。速さを上げるほど信号は崩れやすくなります。そこでHBMは、本数を増やす道を選びました。
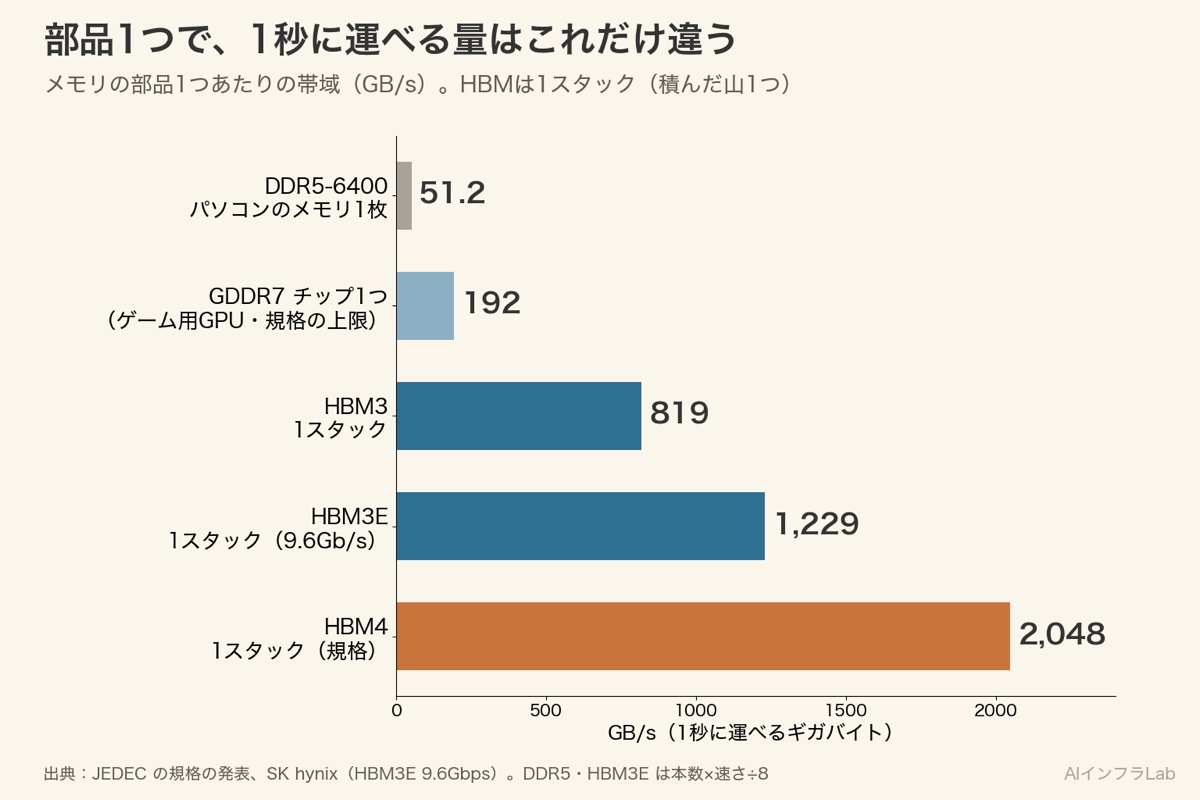
JEDECの発表では、HBM3は1本あたり6.4Gb/s、1つで819GB/sです。発表文には線の本数が書いていなかったので、筆者は2つの数字から計算しました。819.2GB/sを8倍してビットに直し、6.4で割ると1,024本。パソコンのメモリ(DDR5-6400)1枚の64本の16倍です。
線は短いほど良い、という点も大事です。電源の設計者の目では、線は小さなコンデンサに見えます。1と0を切り替えるたびに線を充電し、放電する。そのたびに電力が熱になり、線が長いほど信号の角も丸くなる。HBMをGPUの隣に置くのは、速さのためであり、電力と熱を減らすためでもあります。
HBMの仕組みと構造:縦に積みTSVでつなぐ
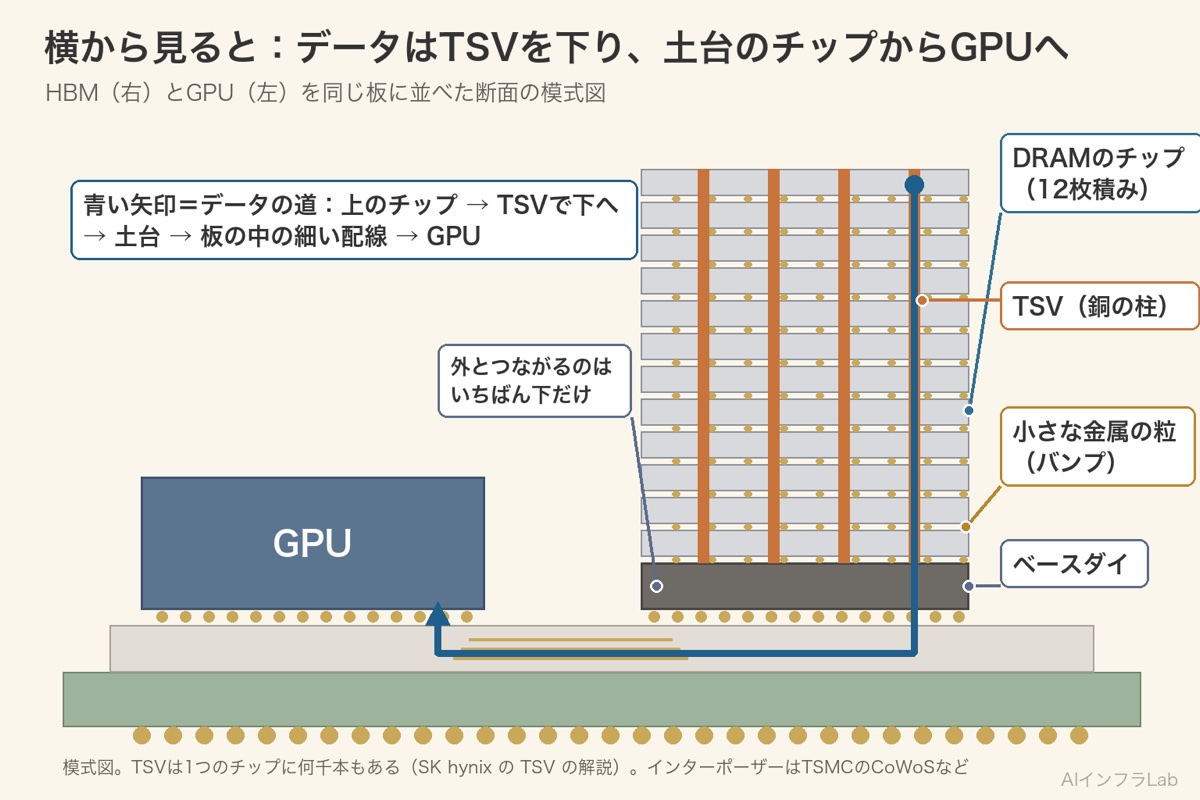
HBMは、薄く削ったDRAMのチップを8枚・12枚と積み、チップを貫く縦の電線TSVで上下をつないだ部品です。いちばん下には土台のチップ(ベースダイ)があり、外とつながるのはこの土台だけです。
① 縦に積む。GPUの隣は狭いので、横に並べず上へ積みます。積んだ山1つを「スタック」と呼びます。
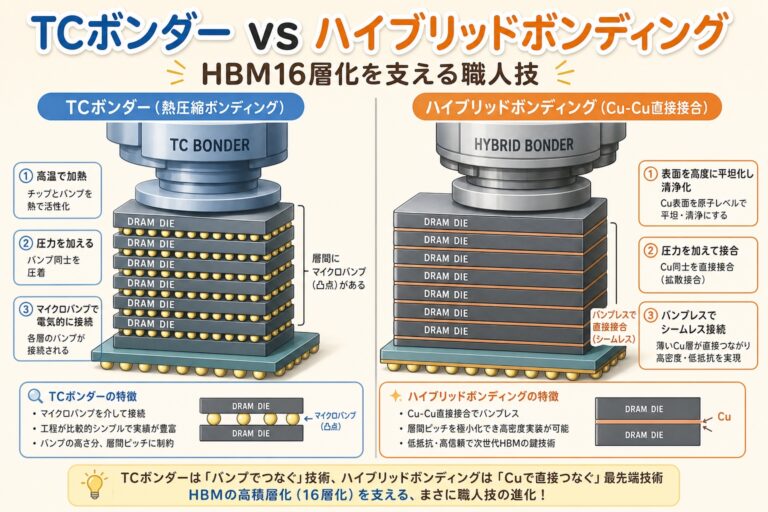
② TSVで貫く。チップに細く深い穴を開け、銅を埋め、裏を削って薄くすると、銅の柱の先が裏に出ます。これを積むと、上と下の柱が小さな金属の粒(バンプ)でつながります。SK hynixの解説では、TSVは1つのチップに数千本あります。
この続きと一緒に読まれている記事
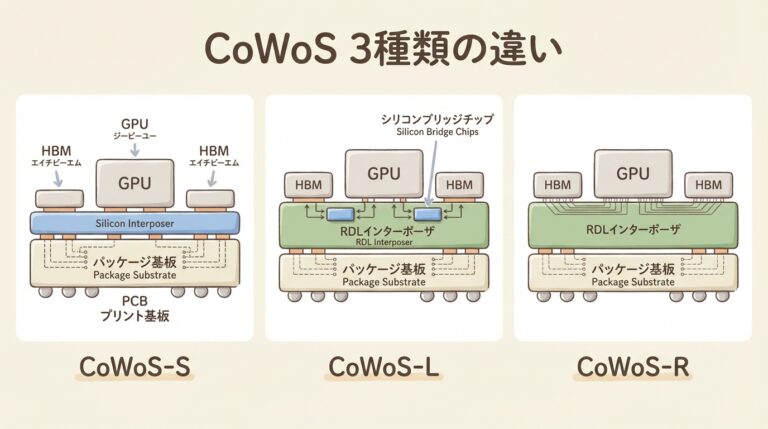
③ GPUの隣に置く。スタックとGPUは、インターポーザーという細い配線の板の上に並べて載せます。代表はTSMCのCoWoSです。
上のチップのデータは、TSVを通って土台まで降り、板の中の短い配線でGPUへ出ていきます。工程の細かい順番は記事末の「HBMの製造工程」、裏を削る工程はバックグラインド、積んで固める2つの方法はMR-MUFとTC-NCFの違いで図にしています。
12枚積みでも、厚さは8枚積みと同じ
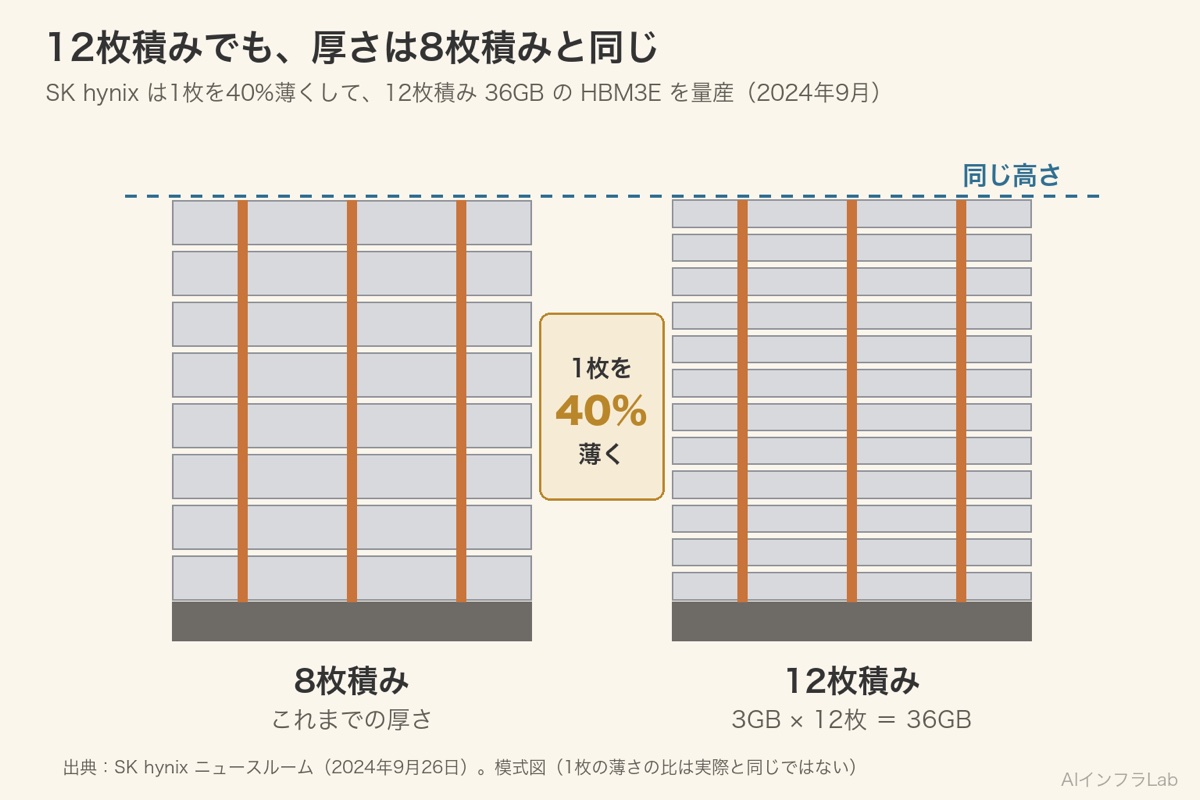
SK hynixは2024年9月、DRAMのチップを12枚積んだHBM3E(36GB)の量産を始めました。3GBのチップが12枚で36GBです。
驚くのは厚さです。1枚1枚をそれまでより40%薄くして、8枚積みと同じ厚さに収めました。薄くするほどTSVの柱も短くなります。積む技術は、薄くする技術でもあるわけです。この製品の1本の速さは9.6Gbpsです。
この節の「縦に積む・TSVで貫く・GPUの隣に置く」を、動く図で順に見せる動画です。線の本数と速さから帯域を数える練習も入っています。
GPUとHBMの関係:どこに載っている?
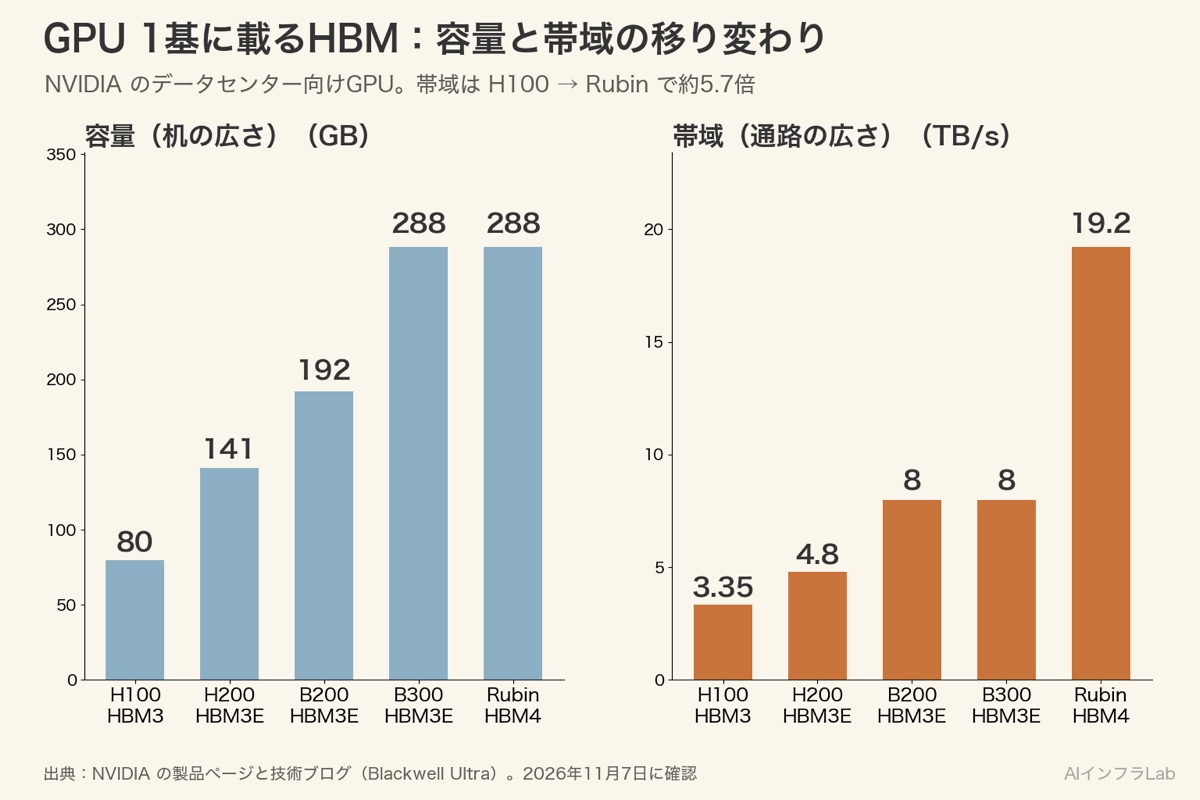
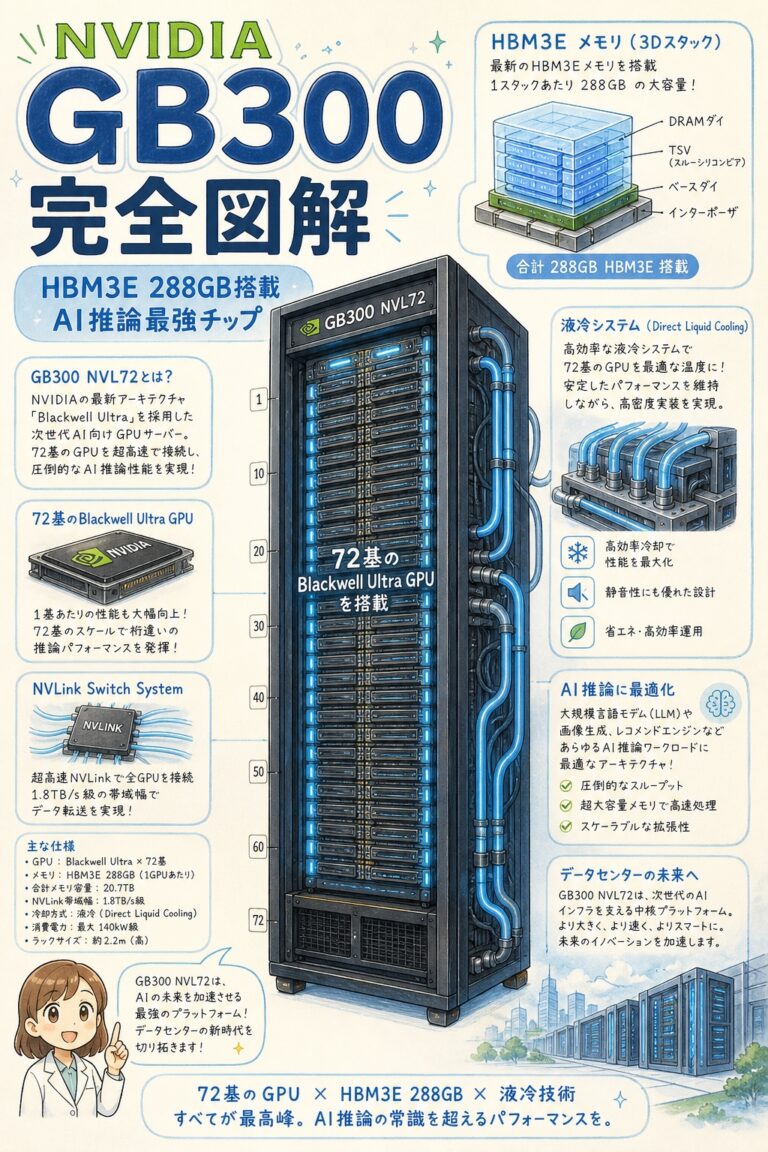
HBMは、GPUのチップのすぐ横、同じ板(インターポーザー)の上に並んでいます。たとえばNVIDIAのH100(SXM)は、HBM3のスタックが5つで合計80GBです。
ゲーム用のグラフィックボード(グラボ)は、GDDRというメモリをGPUのまわりの基板に並べています。GPUのメモリはVRAMとも呼ばれ、AI向けはそのVRAMにHBMを使う、と言い換えられます。組み立て方はCoWoSとは、板そのものはインターポーザーとはで詳しく書いています。
DRAM・GDDR・HBMの違い
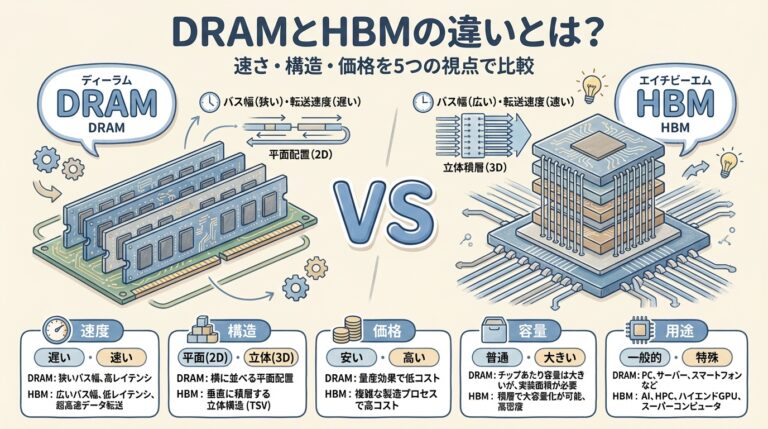
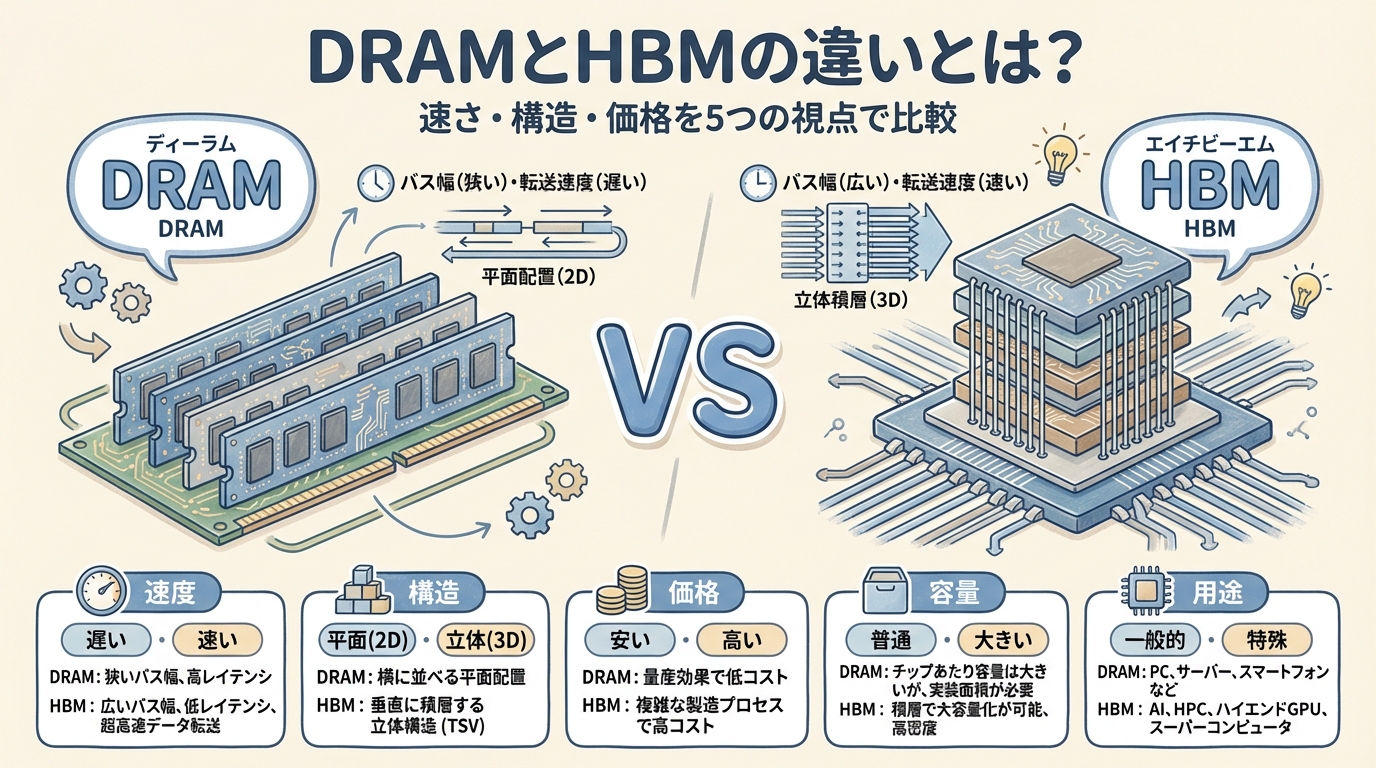
3つとも中身はDRAMの仲間です。違うのは置き方と線の本数。DDRはパソコンやサーバー、GDDRはゲーム用のGPU、HBMはAI向けのGPUの隣に積んで置きます。
DDR5は6400の速さのモジュール1枚(64本)の計算、GDDR7はJEDECの規格の上限、HBM3EはSK hynixの9.6Gbps×1,024本の計算です。部品1つで比べると、HBMは桁が1つ違います。
「ロジックとHBMの違い」で探す人もいます。ロジックはGPUやCPUのように計算するチップ、HBMはデータを置くメモリで、役割が別です。DRAMとHBMの値段や作り方の違いはDRAMとHBMの違い、DRAMとSSDの中身(NAND)の違いはDRAMとNANDの違いで比べています。
HBM3EとHBM4の違い・世代の流れ
最新の規格はHBM4です。JEDECが2025年4月に公表し、GPUとつなぐ線の本数が1,024本から2,048本に倍増、1スタックで最大2TB/sになりました。SK hynixは、2026年10〜12月期にHBM4の出荷量と売上がHBM3Eを上回る見込みだとしています。
最初の世代(HBM1と呼ばれることもあります)はAMDとSK hynixが組んで実用化し、AMDのゲーム用GPUに初めて載りました。そこからHBM2、HBM3と世代を重ね、AI向けGPUの標準のメモリになっています。
GPU 1基に載るHBMは、世代ごとに次のように増えてきました(NVIDIAの製品ページ・技術ブログ。2026年11月7日に確認)。
調べていて迷ったのは、資料によって帯域が「HBM 1つ」の値なのか「GPU 1基」の値なのかが混ざっている点です。この記事は表を分けました。もう1つ、RubinのGPU 1基の帯域は、NVIDIAの製品ページで22TB/sから19.2TB/sに書き換わっていました(2026年9月ごろ。容量の288GBは同じ)。変わった理由の説明は見つからなかったので、ここでは今の値だけを載せます。
HBM4の作り方と各社の量産はHBM4とは、その次のHBM4Eで始まる特注品の流れはHBM4Eとカスタムの意味で整理しています。HBMの代わりにLPDDRを使う場面(SOCAMM)は、記事末のカードから読めます。
HBMのメーカーは3社(日本企業の役割)
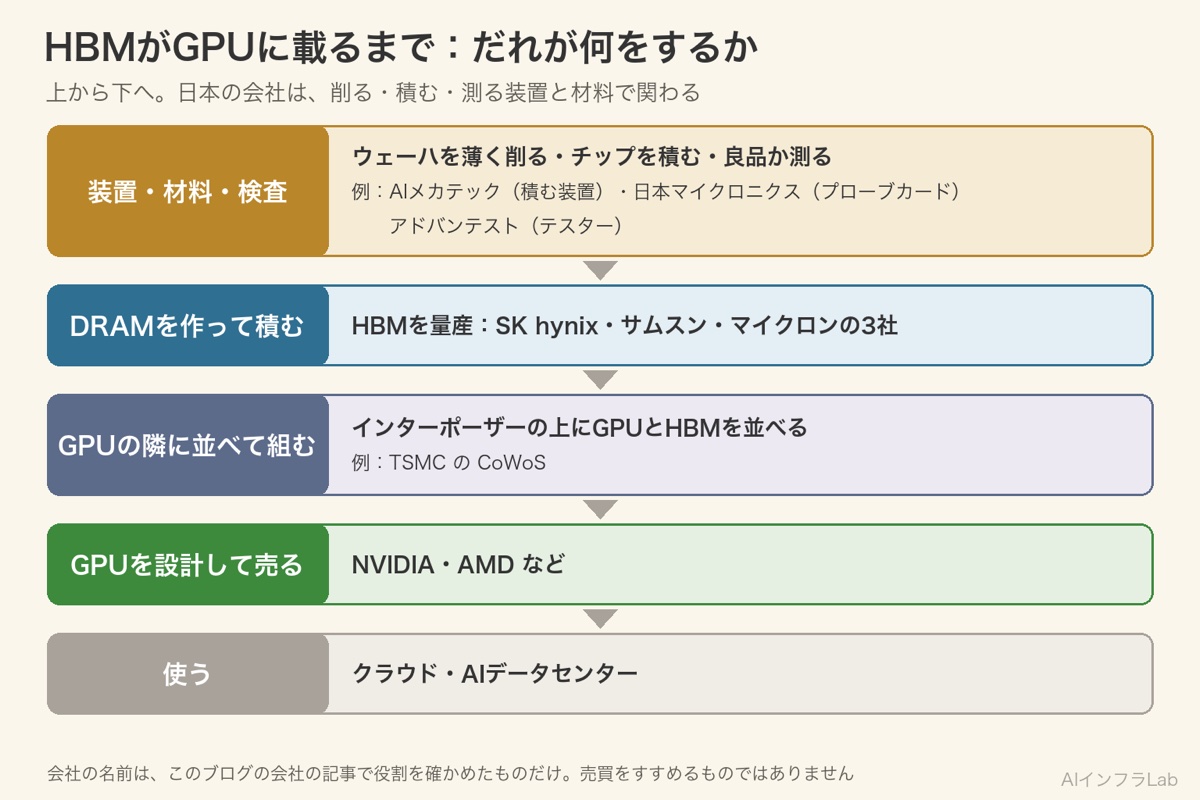
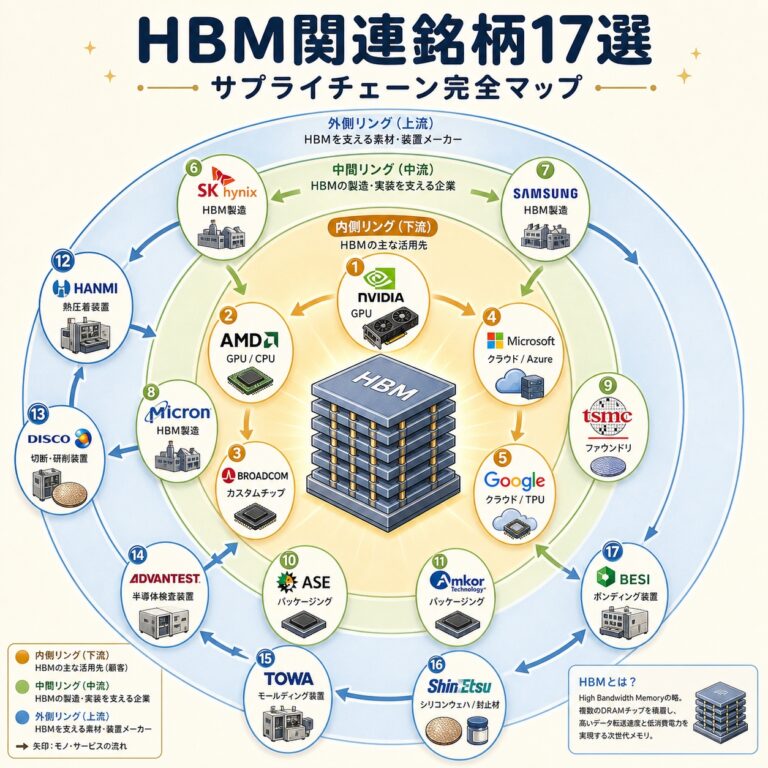
HBMを量産しているのはSK hynix(韓国)・サムスン電子(韓国)・マイクロン(米国)の3社です。日本の会社は、チップを削る・積む・測る装置や材料で関わっています。
SK hynixの強さの理由はSK hynixはなぜHBMで先行するのかで、会社の数字から追っています。
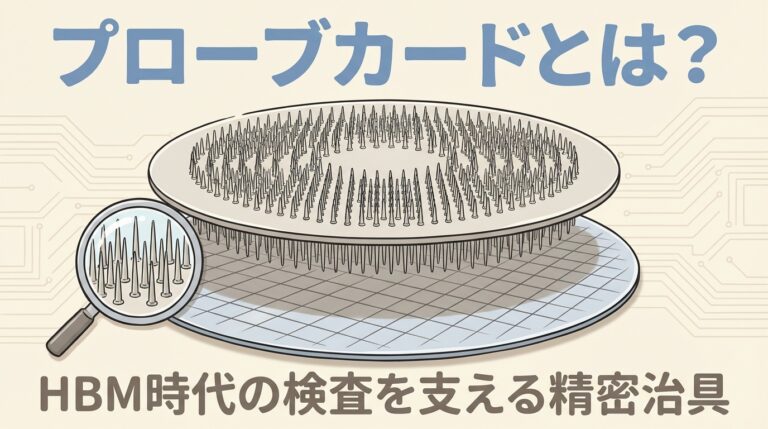
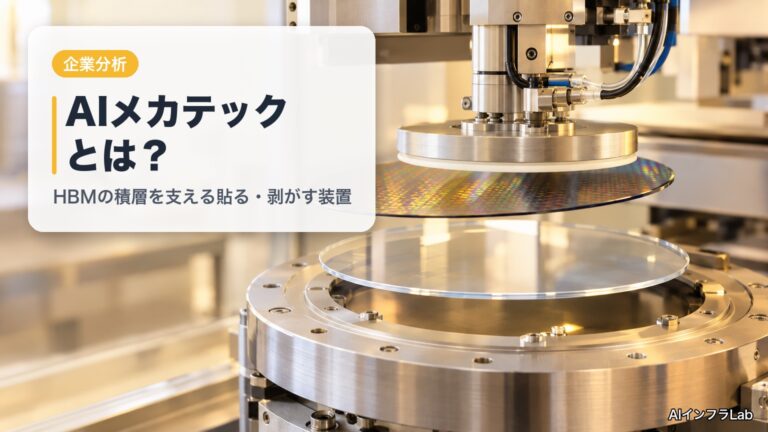
シェアは四半期ごとに動くので、この記事には数字を置かず、HBMシェアの推移(定点観測)で同じ数え方の最新値を記録しています。日本の会社は、積む装置のAIメカテック、プローブカードの日本マイクロニクスなどがあり、工程ごとの一覧は記事末の「HBM関連銘柄と日本企業の役割」にまとめました。
HBMはなぜ高い?なぜ足りない?
積む・貫く・測る手間が多く、1枚の不良で山全体が使えなくなりやすいからです。そのうえAI向けの需要が作れる量を上回っています。SK hynixは2026年10月28日の決算で、2027年と2028年の生産能力の50%以上を長期の契約で埋めたと発表しました。
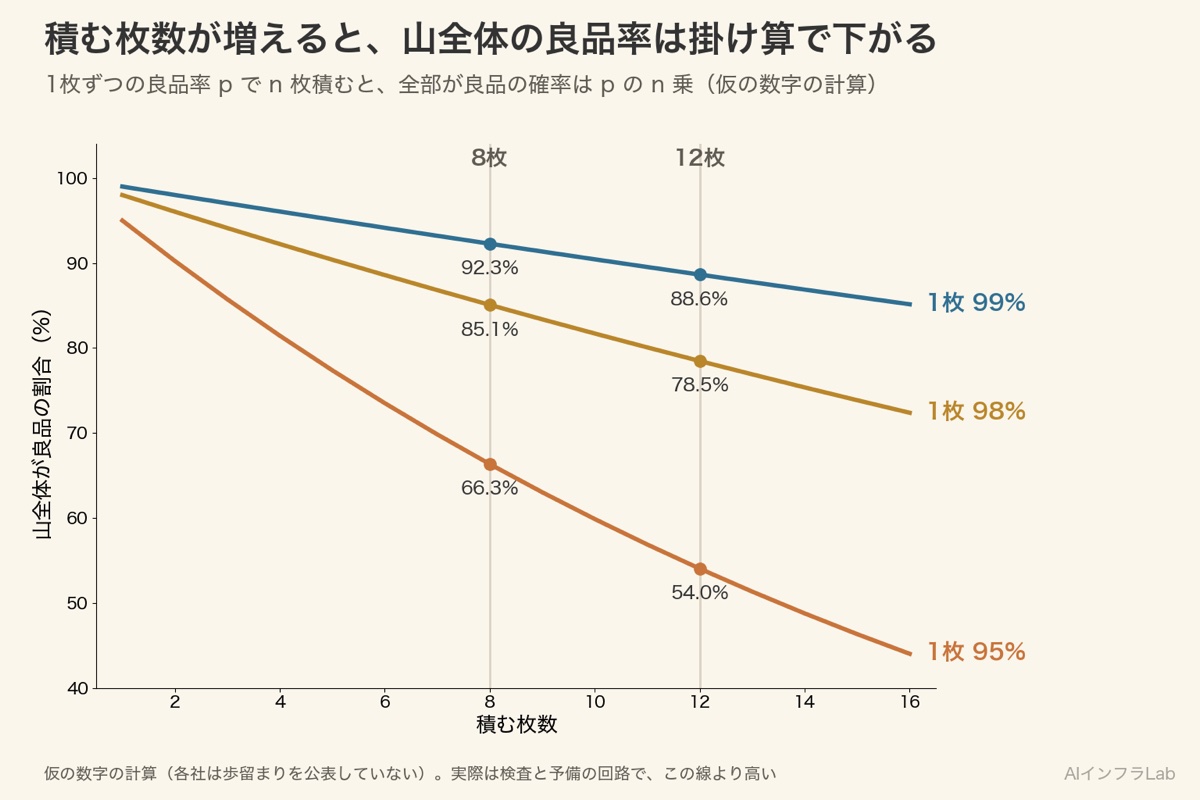
品質保証の考え方では、順につながった工程の良品率は掛け算になります。1枚の良品率が99%でも、12枚全部が良品の割合は0.99の12乗で約88.6%。98%なら約78.5%まで下がります。各社は歩留まりの数字を公表していないので、ここに書いたのは仮の数字です。
だから実際は、積む前に1枚ずつ検査して良いチップだけを選び、予備の回路で直せるように作ります。筆者がHBMの記事で検査の装置を何本も書いているのは、ここが値段と供給量を決める場所だと考えているからです(HBM検査装置とは)。
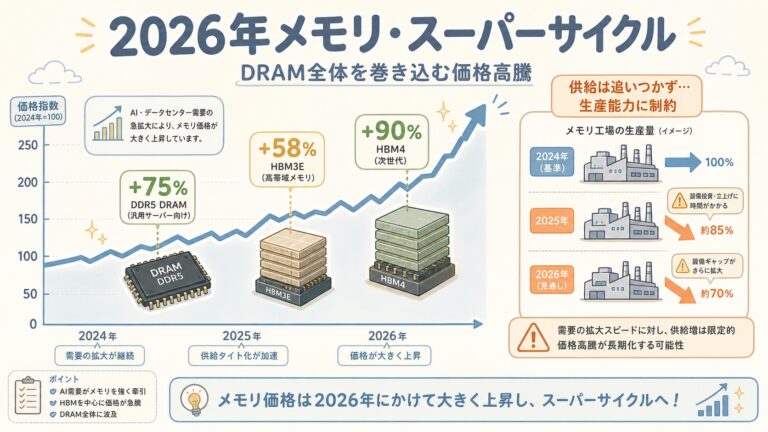
SK hynixは同じ発表で、需要が供給を上回る形は2030年まで続く見込みだとしています。HBMがDRAM全体の値段を押し上げる流れは、記事末の「メモリ・スーパーサイクル」で整理しています。
まとめ
HBMは、DRAMを縦に積んでTSVで貫き、GPUのすぐ隣に置いたメモリです。読み方はエイチ・ビー・エム。
積む理由は、GPUを待たせないために線を短く・多くしたいのに、GPUの隣は狭いから。線の本数はHBM4で2,048本まで増えました。作れるのは3社で、積むほど良品率が掛け算で下がるため、高く、足りない部品になっています。
次にGPUの写真を見たら、大きなチップの横に並ぶ黒い四角を数えてみてください。それがHBMのスタックです。
よくある質問


次に読むべき記事
ここまでで「HBM」の全体像がつかめました。次は、つながりの深い記事で理解を一歩ずつ広げていきましょう。
テーマ別に、もっと深く学ぶ
気になるところから読んでも大丈夫です。どの記事も、はじめての方にもわかるように図解で書いています。
コメント