「CoWoS(コワース)」という言葉、AIや半導体のニュースで急に目にするようになりましたよね。でも、こんなふうに感じていませんか?
こんな悩みはありませんか?
CoWoSって何の略? 読み方すらわからない
「先端パッケージ技術」と聞いても、何がどう先端なのかピンとこない
GPUとHBMを「つなぐ」技術らしいけど、なぜそれが重要なの?
CoWoS-S、CoWoS-L、CoWoS-Rの3種類があるらしいが、違いがわからない
NVIDIAやTSMCの話でよく出てくるけど、投資やキャリアにどう関係するの?
この記事でわかること
CoWoSの意味・読み方・定義 を30秒で理解
「なぜ普通のパッケージではダメなのか」をたとえ話 で納得
CoWoSの仕組み(インターポーザー・TSV・2.5D実装) を図解
CoWoS-S / CoWoS-L / CoWoS-Rの3種類の違いと使い分け
NVIDIA A100 → H100 → B200でCoWoSがどう進化したか
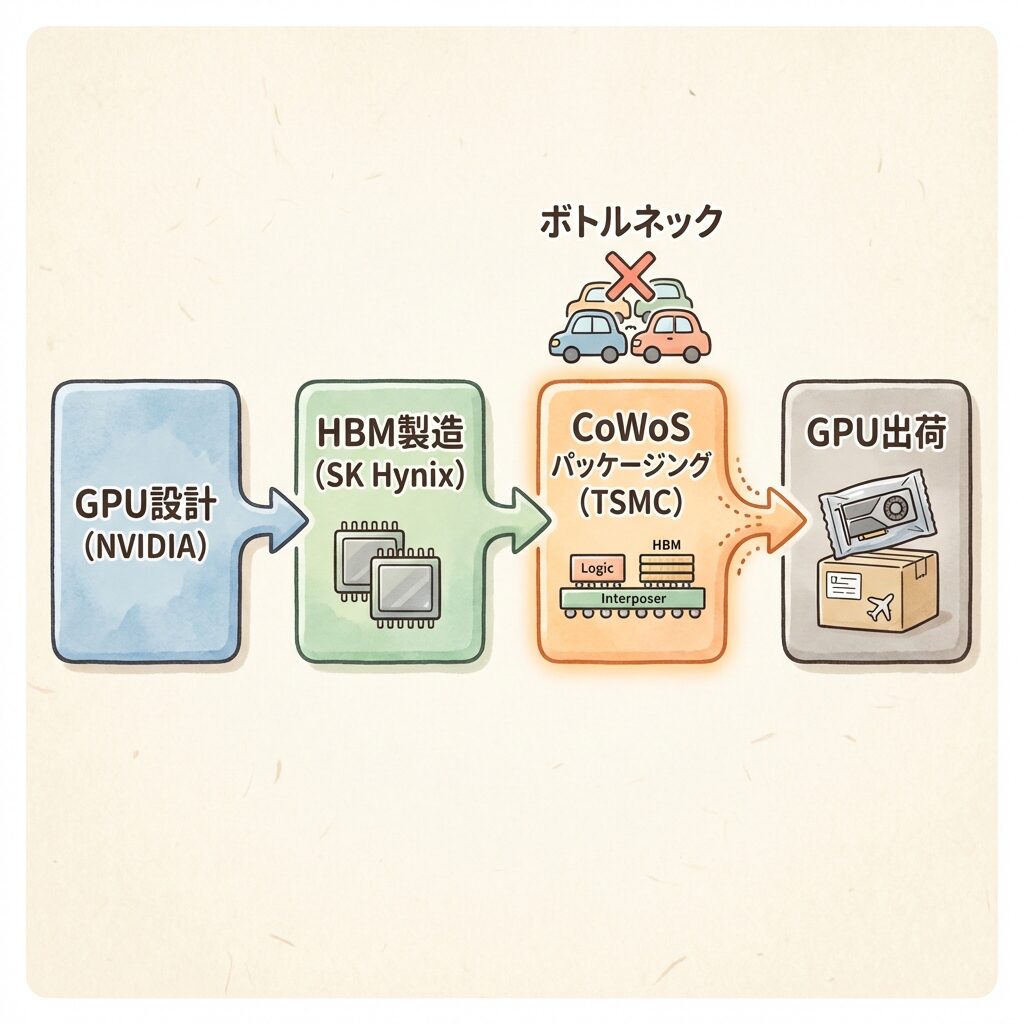
TSMCの生産能力がAI産業のボトルネック になっている構造
投資家・学生にとっての意味と行動指針
先に結論
CoWoS(Chip on Wafer on Substrate)とは、GPUとHBM(高帯域幅メモリ)を1つのパッケージに統合するための、TSMCが開発した先端パッケージ技術 です。GPUダイとHBMスタックを「シリコンインターポーザー」と呼ばれる中間基板の上に横並びに配置し、超高密度の配線で接続します。この技術がなければ、NVIDIA H100やB200のような最先端AI GPUはそもそも製品として成立しません 。現在、NVIDIAはTSMCのCoWoS生産能力の70%以上を確保 しており(出典:Introl )、CoWoSの製造キャパシティはAI半導体の供給を左右する最大のボトルネック となっています。この記事では「CoWoSとは何か」を仕組みから理解し、AI産業の構造の中でなぜこの技術が決定的に重要なのかを解説します。
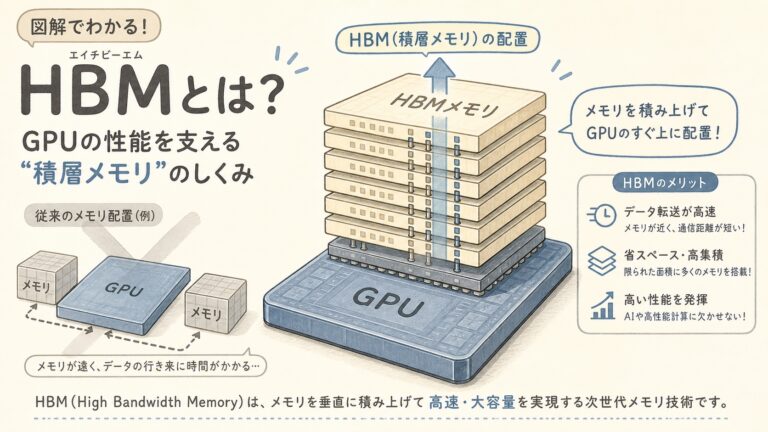
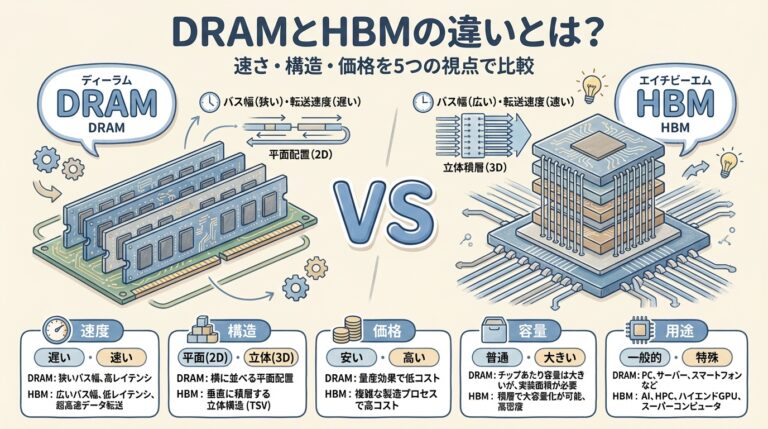
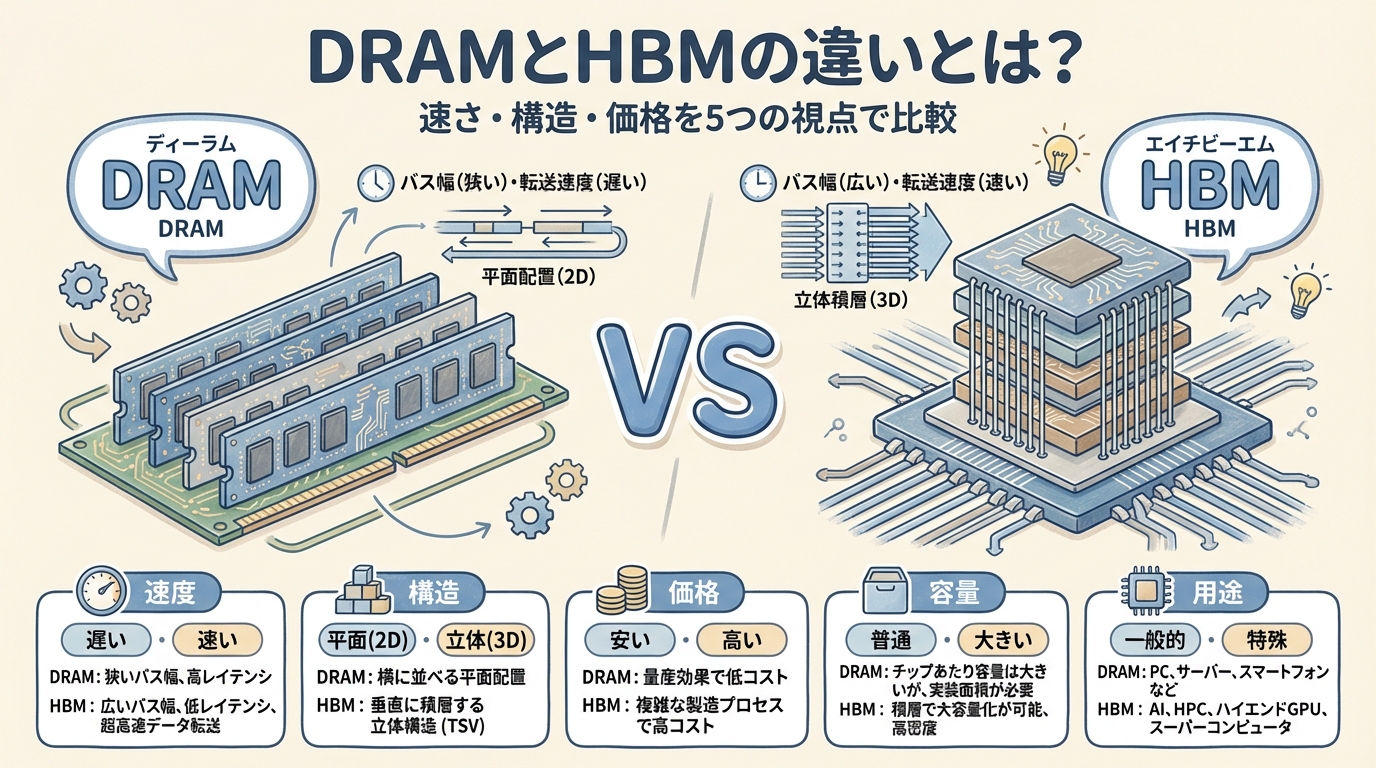
前回の記事(HBMとは? )で、GPUの性能を引き出す「超高速メモリ」HBMを解説しました。しかし、GPUとHBMは別々のチップです。この2つを「どうやって1つの製品にまとめるか」 ──その答えが、今回のテーマ「CoWoS」です。
CoWoSとは?──まず30秒で全体像をつかむ
CoWoSの読み方は「コワース」
CoWoSの読み方は「コワース」 です。日本の技術メディアでも「CoWoS(コワース)」と書かれています。英語のChip on Wafer on Substrate の頭文字をつないだ名前で、小文字の「o」は「on(〜の上に)」を表します。
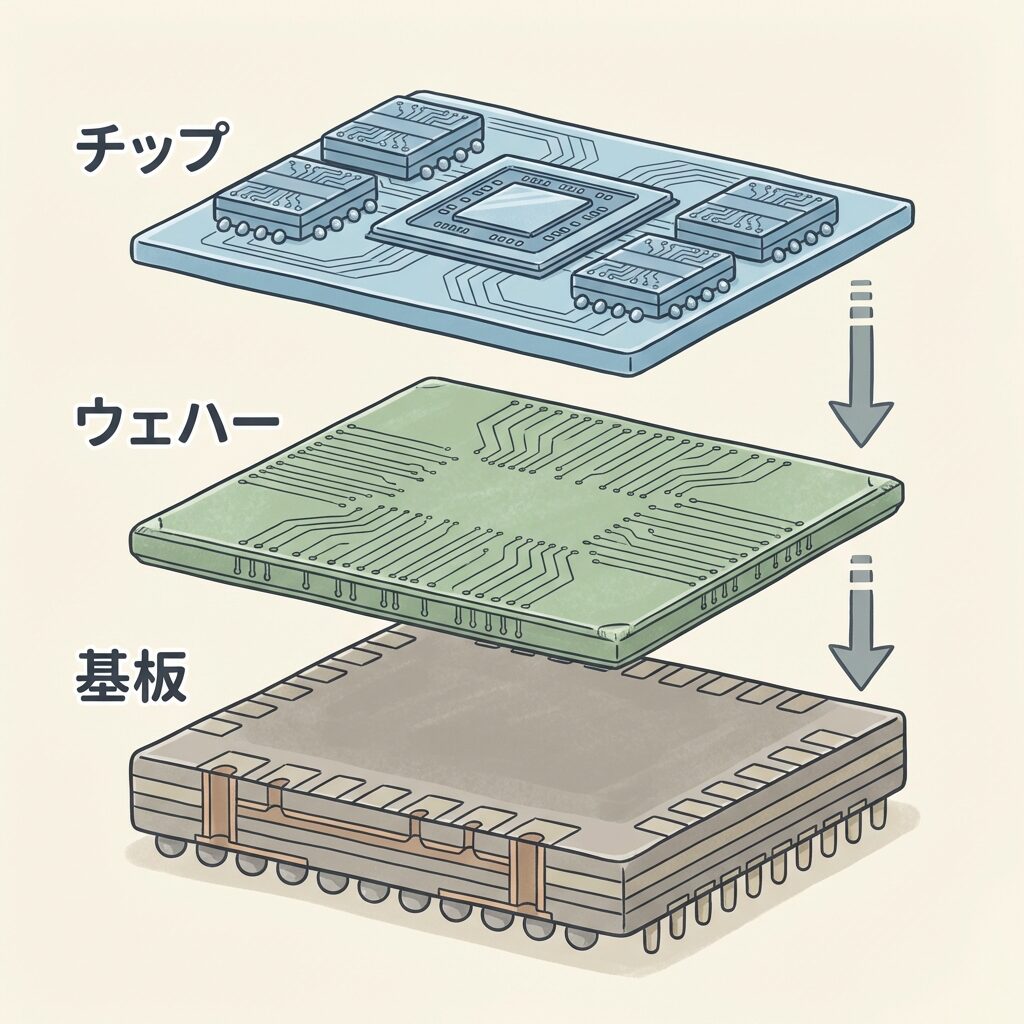
名前は、そのまま作り方を表しています。チップ(Chip)をウェハー(Wafer)=シリコンインターポーザーの上に載せ、それをさらに基板(Substrate)の上に載せる ──この3段の重ね方が「CoWoS」です。CoWoS-S・CoWoS-L・CoWoS-Rの3種類は、この真ん中の層(インターポーザー)の材料と作りの違いです(下の「CoWoSの3種類」の節で解説します)。
出典:日経クロステック「TSMCがパネルレベルパッケージ参入検討、『CoWoS』は後工程専業と連携」(2024年8月9日)
CoWoS = Chip on Wafer on Substrate(チップ・オン・ウェハー・オン・サブストレート)
CoWoS(読み方:コワース)とは、複数の半導体チップ(GPUダイやHBMスタック)を、シリコンインターポーザーと呼ばれる中間基板の上に横並びに配置し、それを1つのパッケージ基板に搭載する先端パッケージ技術 です。TSMCが2011年に開発し、2012年に量産を開始しました。
名前の意味を分解すると、こうなります。
on
on
Substrate
パッケージ基板
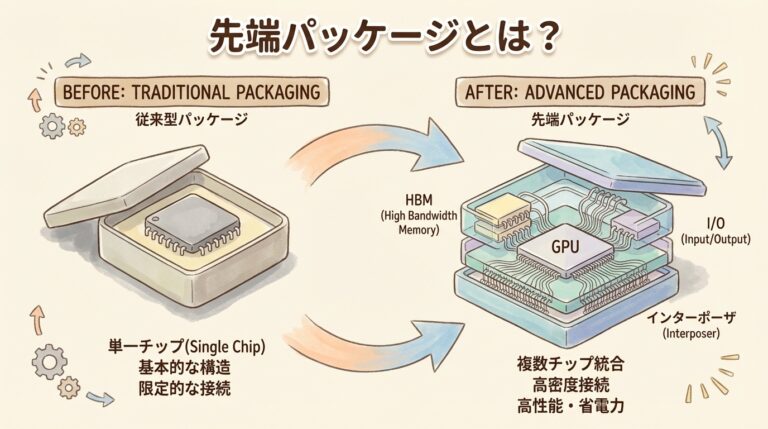
つまり「チップ → インターポーザー → 基板」という3層のサンドイッチ構造 で、複数のチップを1つのパッケージにまとめる技術です。この「2.5D実装」と呼ばれる手法は、チップを横に並べて接続する 点が特徴です(チップを縦に積み重ねるのは「3D実装」)。
用語メモ:インターポーザー
GPUとHBMなど複数のチップを同一平面上に載せるための「中間基板」。シリコン製が主流で、超微細な配線とTSV(貫通電極)を備える。チップ同士を数mm以内の超短距離で接続することで、高速・低消費電力のデータ転送を実現する。
たとえるなら…
CoWoSは「超精密な模型の台座 」のようなものです。GPUという「エンジン」と、HBMという「燃料タンク」を、台座(インターポーザー)の上にぴったり並べて、超細い配管(配線)でつなぐ。台座がなければ、エンジンと燃料タンクは遠く離れてしまい、燃料の供給が追いつかない──つまりGPUの性能が引き出せないのです。
なぜCoWoSが必要なのか?──「普通のパッケージ」では限界がある
従来のパッケージの問題点:「遠すぎる」と「狭すぎる」
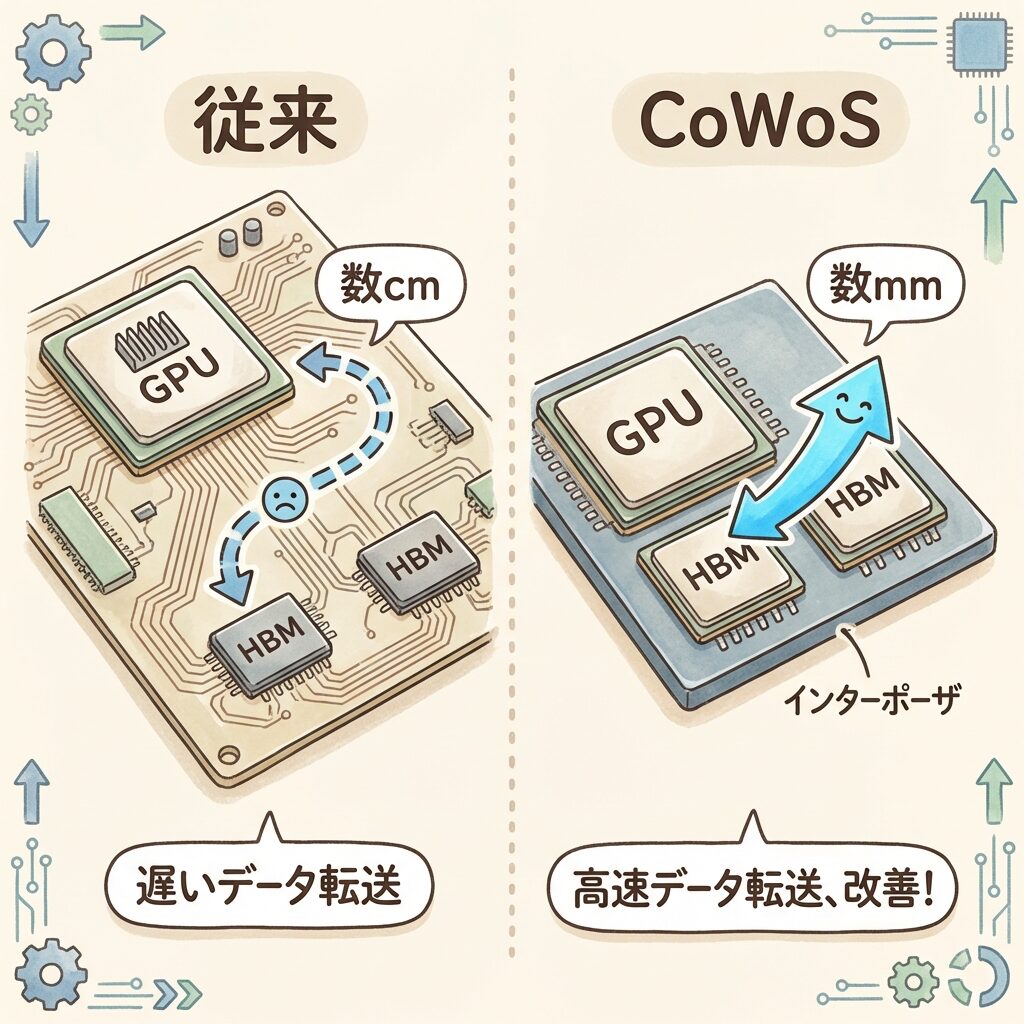
従来の半導体パッケージでは、GPUとメモリ(HBM)は別々のパッケージに入れて、マザーボード上の配線でつなぐ のが一般的でした。しかしAI時代になって、この方式には2つの致命的な問題が浮上しました。
問題① 距離が「遠すぎる」
GPUとメモリがマザーボード上で数cm離れている と、信号の伝送距離が長くなり、通信速度が落ち、消費電力も増える。AI計算で必要な「超高速データ供給」に追いつかない。
問題② 配線が「狭すぎる」
マザーボード上の配線は密度に限界がある。HBMが必要とする1,024bit以上の超広バス幅 は、マザーボードの配線ルールでは物理的に実現不可能。
CoWoSの解決策:「近づけて」「太くする」
CoWoSはこの2つの問題を、シンプルかつ根本的に解決しました。
シリコンインターポーザーの上にGPUとHBMを数mm以内の距離 で並べることで、信号の伝送距離を劇的に縮め、超高密度の配線(1,024bit以上のバス幅)を可能にしたのです。距離が縮まったことで消費電力も下がります。
ポイント CoWoSが解決したのは「チップ同士の物理的な距離と配線密度の限界 」です。AIの世界でGPU性能が上がっても、GPUとメモリの間のデータ転送が遅ければ意味がない(メモリウォール問題)。CoWoSは、このボトルネックを「物理的に近づける」という発想で根本から解消しました。
CoWoSの仕組み──3ステップで理解する製造プロセス
「ウェハーの上でチップを組み立て、基板に載せる」
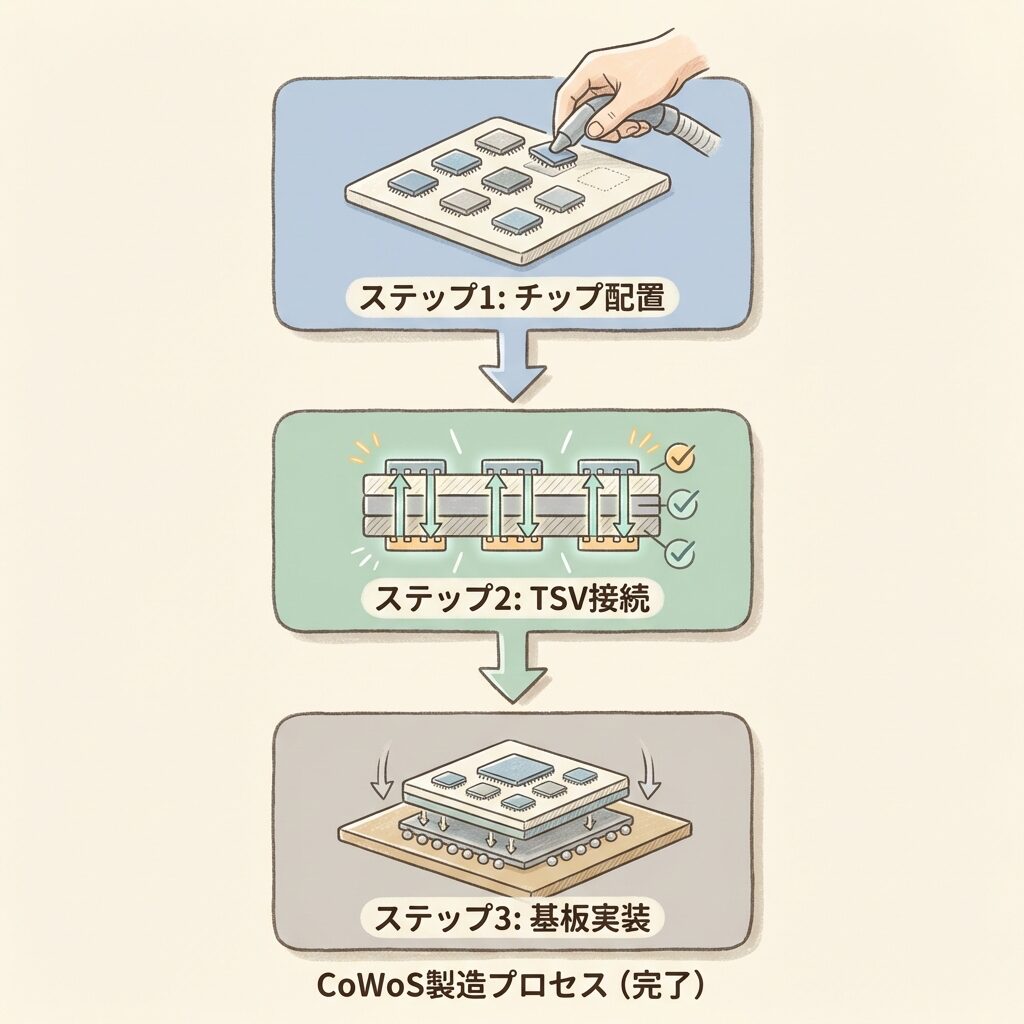
CoWoSの製造プロセスは、名前の通り3つのステップで構成されます。
STEP 1 Chip on Wafer(チップをウェハーに載せる)
シリコンウェハーで作られたインターポーザーの上に、GPUダイやHBMスタックなどの個々のチップを精密に配置 します。このとき、チップは「フリップチップ」と呼ばれる方法で裏返しにして 接続されます。チップの電極とインターポーザーの微細な配線が直接接触する形です。
用語メモ:フリップチップ
チップの電極面を下向きにして基板に直接接続する実装方式。従来のワイヤボンディング(金線で接続)よりも接続密度が高く、信号伝送が高速。
STEP 2 Wafer上での接続確認・加工
チップが載ったインターポーザー上で、接続テストと追加加工を行います。インターポーザー内部にはTSV(Through-Silicon Via:貫通シリコンビア) が数千〜数万本通っており、インターポーザーの表面(チップ側)と裏面(基板側)を垂直に貫通して接続 しています。
用語メモ:TSV(Through-Silicon Via)
シリコンを貫通する超微細な電極。インターポーザーの表面と裏面を垂直に結ぶ「エレベーター」の役割。これにより、チップ側の信号をパッケージ基板側へ高速に伝送できる。
STEP 3 on Substrate(基板に搭載)
チップが搭載されたインターポーザーを、パッケージ基板(有機基板)に接合 します。パッケージ基板は、マザーボードとの接続を担う最終的な「土台」です。これでCoWoSパッケージが完成──GPUとHBMが1つのパッケージに統合された状態になります。
たとえるなら…
CoWoSの製造は「精密なジオラマ制作 」に似ています。STEP 1で、精密な台座(インターポーザー)の上にミニチュアの建物(GPU・HBM)を正確に配置する。STEP 2で、建物同士が台座内の地下通路(TSV)でちゃんとつながっているか確認する。STEP 3で、台座ごとケースの中(パッケージ基板)に固定する。完成品は「見た目は1つのチップだが、中に複数の建物がある」状態です。
構成要素
役割
ポイント
GPUダイ
AI計算の実行
1万個以上のコアで超並列処理を担う「頭脳」
HBMスタック
超高速データ供給
3D積層DRAMでGPUに1TB/s超の帯域幅を提供
インターポーザー
チップ間接続
超微細配線+TSVでGPUとHBMを数mm以内で接続
パッケージ基板
外部接続
マザーボードとの接続を担う最終的な土台
CoWoSの3種類──S・L・Rの違いを一目で理解する
3種類の違いは「インターポーザーの材料と構造」
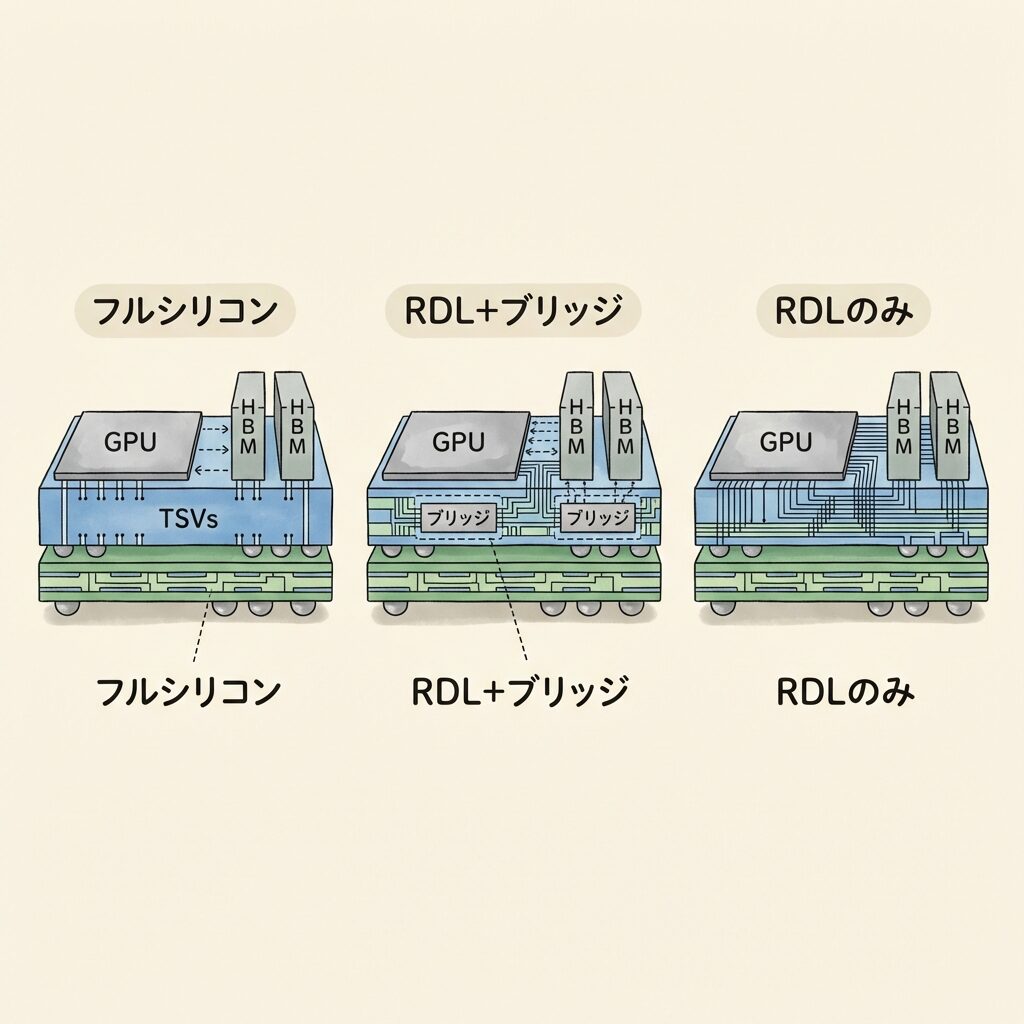
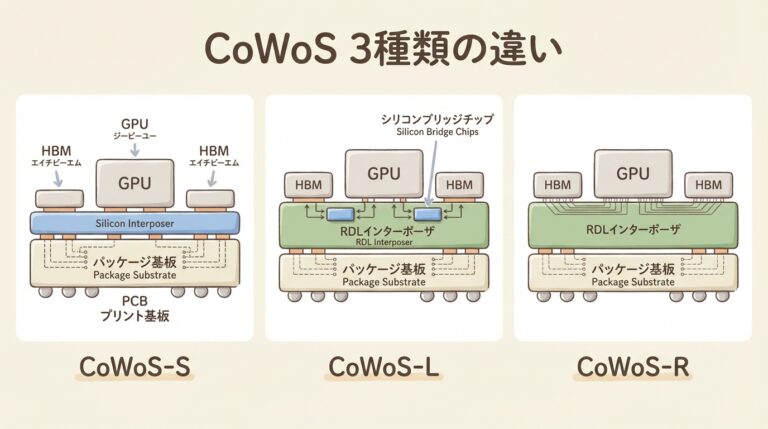
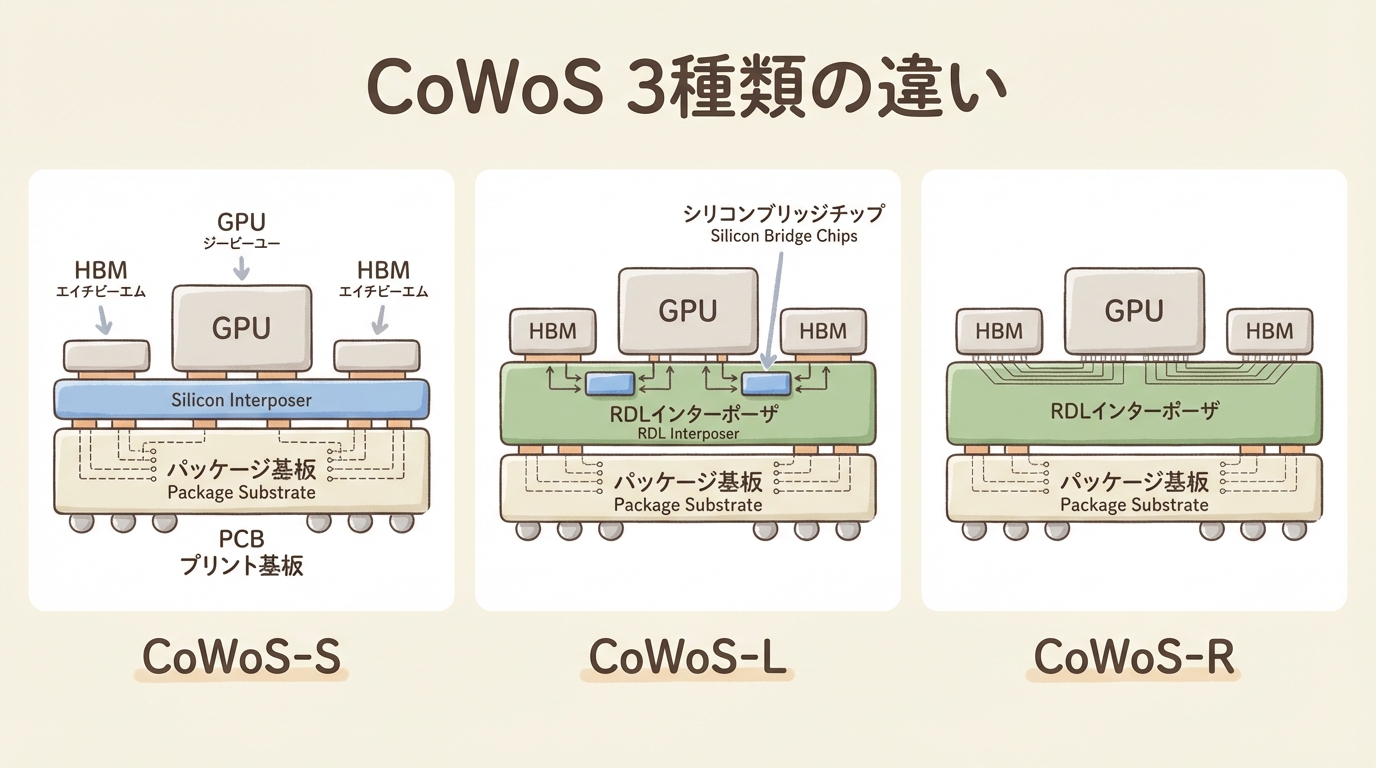
CoWoSにはCoWoS-S、CoWoS-L、CoWoS-R の3つのバリエーションがあります。名前が似ていて混乱しがちですが、違いはシンプルです。「中間基板(インターポーザー)に何を使うか」 だけが異なります。
CoWoS = 3種類のバリエーション
CoWoS-S
フルシリコンインターポーザー
CoWoS-L
RDL+シリコンブリッジB200に採用(現在の主流)
CoWoS-R
RDLインターポーザーのみ
比較項目
CoWoS-S
CoWoS-L
CoWoS-R
インターポーザー
フルシリコン
RDL+局所シリコンブリッジ(LSI)
RDL(有機再配線層)のみ
配線密度
最高
高い(ブリッジ部分は高密度)
低い
パッケージサイズ
〜3.3レチクル(制約あり)
大型化可能(制約が緩い)
大型化可能
コスト
高い
中程度
低い
歩留まり
大型化すると低下
比較的高い
高い
代表的な採用GPU
A100 / H100
B200(Blackwell)
一部のHPC製品
出典:CoWoSの3種類の分類は EE Times Japan 、Introl 、NVIDIAの採用情報は Tom’s Hardware を参考に構成
用語メモ:RDL(再配線層)
Redistribution Layer(リディストリビューション・レイヤー)の略。チップの電極を外部接続用に「配線し直す」ための層。シリコンインターポーザーの代わりに有機材料で作るため、コストが低く大面積化に有利。ただし配線密度はシリコンに劣る。
なぜCoWoS-Lが「主流」になったのか
CoWoS-Sは配線密度が最高ですが、フルシリコンインターポーザーは大型化すると歩留まり(良品率)が下がります。GPUが巨大化した最新世代(Blackwell B200は2つのGPUダイを搭載)では、CoWoS-Sのサイズ制約では収まりきらなくなりました。CoWoS-Lは「必要な部分だけシリコン(ブリッジ)を使い、それ以外はRDLにする」というハイブリッド方式で、大型化・歩留まり・コストのバランスを取っています(出典:Tom’s Hardware )。
NVIDIA GPUの進化とCoWoSの関係──A100からB200まで
GPU世代が進むたびに、CoWoSも進化してきた
NVIDIAのデータセンター向けGPUは、すべてCoWoS技術で製造されています。GPU世代の進化は、CoWoSの進化と表裏一体です。
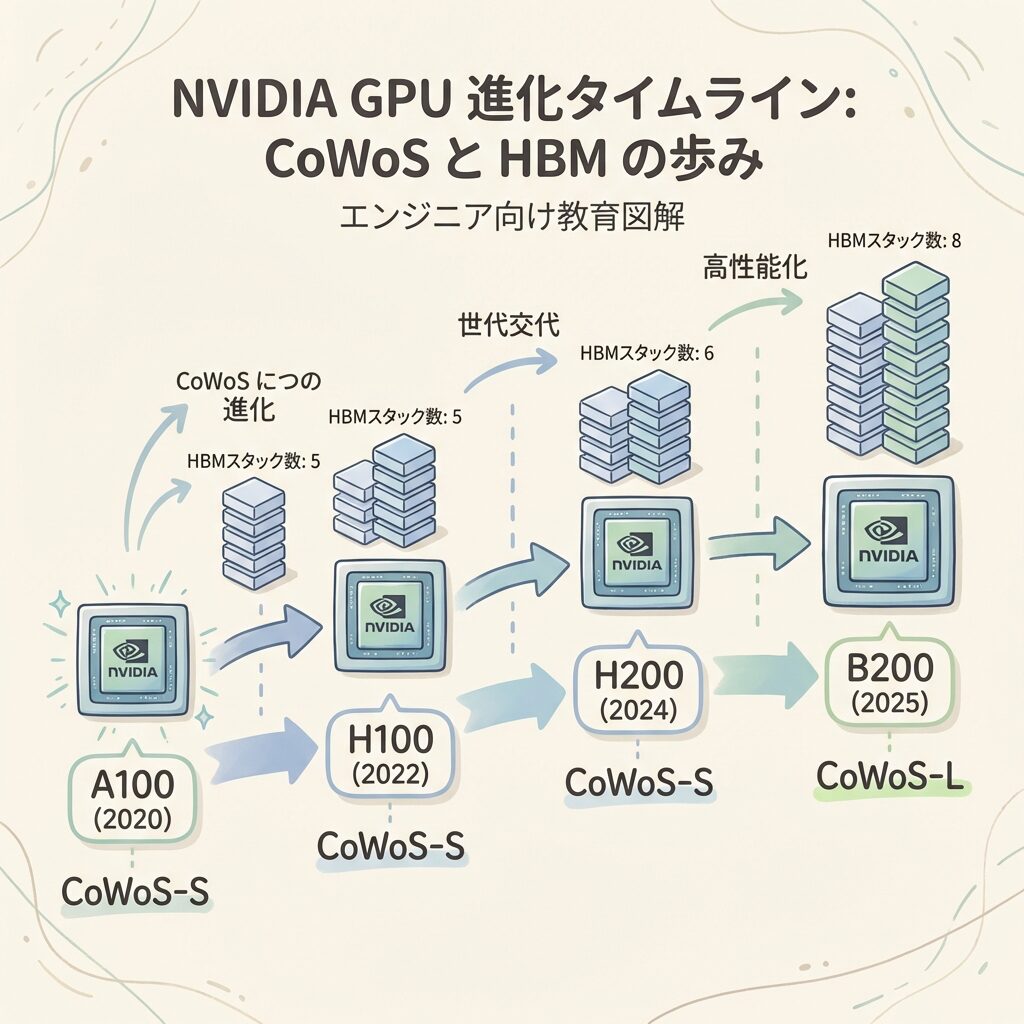
2020年 A100(Ampere世代)
CoWoS-S 採用。HBM2e × 5スタック搭載。パッケージサイズ約2レチクル。これがAIデータセンター向けGPUに「CoWoSが必須」であることを業界に決定づけた世代。
2022年 H100(Hopper世代)
CoWoS-S 採用。HBM3 × 5スタック(80GB・3.35TB/s)。ChatGPTブームでH100の需要が爆増し、CoWoSの生産能力が世界的なボトルネックに。TSMCがCoWoS増産を急いだ転換点。
2024年 H200
CoWoS-S 採用。HBM3E × 6スタック(141GB・4.8TB/s)。HBM容量と帯域幅が大幅に向上し、推論性能が飛躍的に改善。
2024〜2025年 B200(Blackwell世代)
CoWoS-L に移行。2つのGPUダイ+HBM3E × 8スタック を1パッケージに搭載。CoWoS-Sではサイズが収まらないため、CoWoS-Lへの移行が決定(出典:Tom’s Hardware )。NVIDIAはTSMCのCoWoS-L生産能力の70%以上を確保。
ひとことメモ
HBMスタック数が増えるということは、それだけCoWoSパッケージも大型化するということ。大型化すれば製造難度が上がる。だからCoWoS-SからCoWoS-Lへの移行が必要だったのです。
B200のあと──B300・RubinとCoWoS(2026年10月時点) NVIDIAのGPUは、B200のあともHBMの量を増やし続けています。パッケージに載せるHBMが増えるほど、CoWoSの中間の層も大きくする必要があります。
GPU HBM(1基) メモリ帯域(1基)
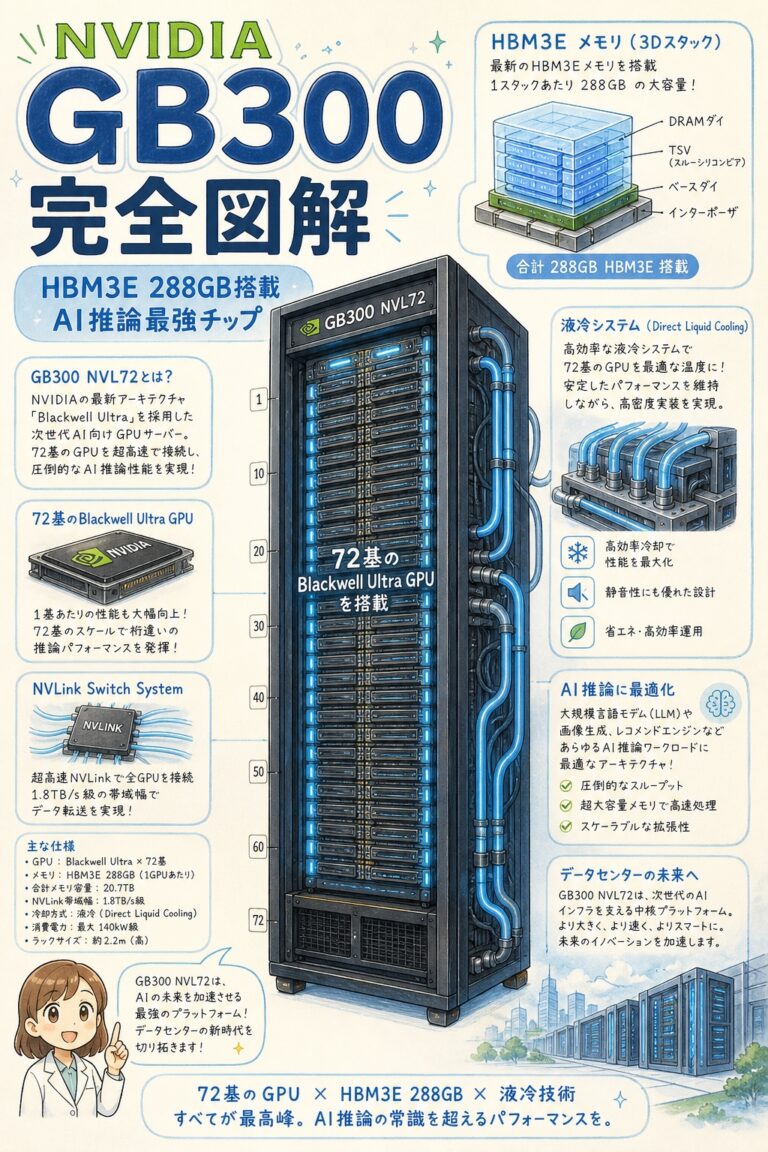
Blackwell(B200) HBM3E 192GB 8TB/s Blackwell Ultra(B300) HBM3E 288GB 8TB/s Rubin HBM4 288GB 19.2TB/s
TSMCは、露光1回の範囲(レチクル)の9.5倍の大きさのCoWoSを2027年に量産し、1つのパッケージにHBMを12個以上載せられるようにする計画を発表しています(2025年4月)。大きさの推移はCoWoS-S・L・Rの違い で図にしています。
なぜCoWoSがAI産業の「ボトルネック」なのか
GPU設計は完成している。しかし「包むもの」が足りない
NVIDIAはGPUの「設計」を持っていますが、GPUを「製品」にするにはCoWoSパッケージングが必要です。そしてCoWoSを量産できるのは、事実上TSMCだけ です。この構造が、AI半導体の供給に深刻なボトルネックを生んでいます。
① AI需要が爆増
ChatGPT以降、世界中のハイパースケーラーがNVIDIA GPUを大量発注。
② GPU設計は完成している
NVIDIAはH100やB200の設計を持っている。「作りたい」ものはある。
③ しかしCoWoSの生産能力が足りない
TSMCのCoWoS工場はフル稼働でも需要に追いつかない。生産能力の拡張には年単位の時間が必要。
④ 結果:GPU出荷数がCoWoSで制約される
NVIDIAがどれだけGPUを「設計」しても、CoWoSで「包め」なければ出荷できない。パッケージング能力がAI産業の成長速度を決めている 。
TSMCの増産計画──2026年末に月産12〜13万枚へ
この状況を受けて、TSMCはCoWoSの生産能力を急拡大しています。TrendForceの報道によると、TSMCは2026年末までにCoWoSの月産能力を2025年12月時点の7.5〜8万枚から12〜13万枚 に引き上げる計画です(出典:TrendForce )。
それでもCoWoS-SとCoWoS-Lは「完全に予約済み」の状態が続いています。世界のCoWoS需要は2024年の37万枚から2025年に67万枚、2026年には100万枚 に達する見通しです(出典:36Kr )。バーンスタインはCoWoSがTSMC売上の約15% を占めると予測しています(出典:Investing.com )。
よくある誤解 「AI半導体の供給制約 = チップの微細化技術が足りない」と思われがちですが、現在の最大のボトルネックはチップの「包み方」(パッケージング) です。NVIDIAはGPUの回路設計を持っている。HBMはSK Hynixが量産している。しかし、それらを1つにまとめるCoWoSの生産能力が追いつかない ことが、出荷数を制約しているのです。
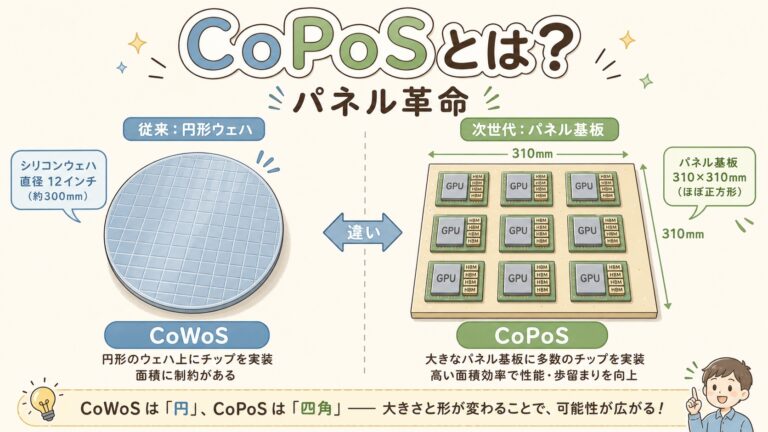
CoWoSとCoPoS・CoWoPの違い 「CoPoS CoWoS 違い」「CoWoP」も合わせて調べられています。どれもGPUとHBMをまとめる組み立て方で、違いはチップの下の層です。
名前 チップの下 状況(2026年10月時点)
CoWoS ウェーハで作る中間の層 → パッケージ基板 量産中 CoPoS 四角いパネルで作る中間の層 → パッケージ基板 試作ラインの段階。量産は2028年以降の見通し(報道) CoWoP ウェーハで作る中間の層 → プリント基板に直接(パッケージ基板を省く) 構想・開発の段階
3つの違いは図とあわせてCoPoSとは で解説しています。
CoWoSと「チップレット」の関係──なぜ今、パッケージが主役なのか
「1枚の巨大チップ」から「複数チップの組み合わせ」へ
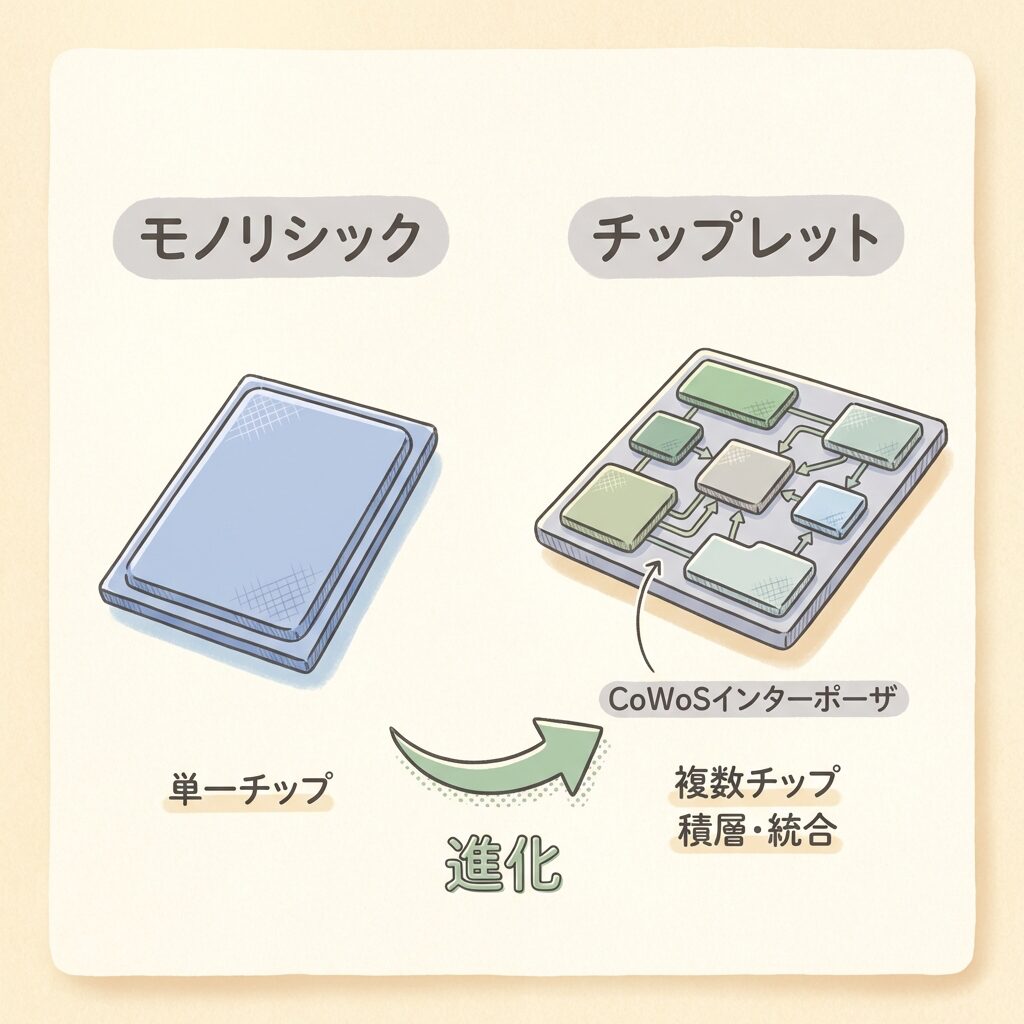
半導体の世界では長年、「1枚のシリコンウェハーから1つの巨大なチップを切り出す」(モノリシック設計)が主流でした。しかし、チップが巨大化するほど製造の歩留まりが下がり、コストが跳ね上がるという問題がありました。
そこで登場したのが「チップレット」 という考え方です。機能ごとに小さなチップ(ダイ)に分けて製造し、それらを1つのパッケージに組み合わせる──いわば「レゴブロックの組み立て」方式です。
用語メモ:チップレット
1つの大きなチップを丸ごと作る代わりに、機能ごとに分割した小さなチップ(ダイ)を複数組み合わせて1つのパッケージにする設計手法。GPUダイ、メモリダイ、I/Oダイなどを別々に製造し、CoWoSのようなパッケージ技術で統合する。「ヘテロジニアス集積」とも呼ばれる。
モノリシック設計(従来)
1枚の巨大なシリコンにすべての機能を詰め込む。チップが大きいほど不良品になる確率が上がり、コストが指数関数的に増大 する。
チップレット設計(現在)
機能ごとに小さなダイに分け、それらをCoWoSのようなパッケージ技術で統合。小さいダイは歩留まりが高く、異なるプロセスの組み合わせ も可能。
CoWoSは、まさにこの「チップレット時代」を支えるための技術です。GPUダイ(演算)とHBMスタック(メモリ)という異なる種類のチップを、1つのパッケージに高性能に統合する ──これがCoWoSの本質的な役割です。NVIDIAのBlackwell B200は、2つのGPUダイ+8つのHBMスタックをCoWoS-Lで統合しており、チップレット設計の最先端を体現しています。
チップレットは「機能ごとに分けて設計する」考え方、CoWoSはそれを1つにまとめる実装の技術という関係で、分けると良品率やコストがどう変わるのかはチップレットとは?AI時代に主流になった理由 で詳しく解説しています。
ポイント 半導体の進化の「主軸」は、微細化(ムーアの法則)からパッケージング(チップレット統合)へとシフトしつつあります。CoWoSはその最前線にある技術です。「半導体の進化 = チップを小さくすること」だけではなくなった ──これが現在の業界の構造変化です。
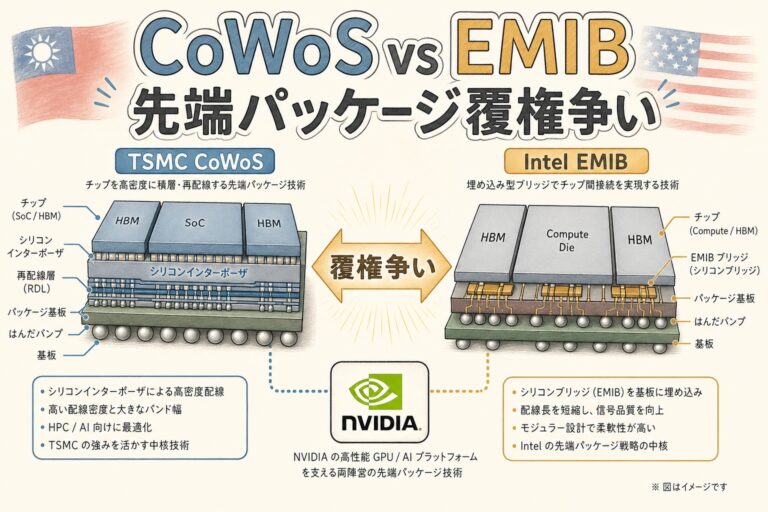
CoWoSの競合技術──IntelのEMIBとFoveros
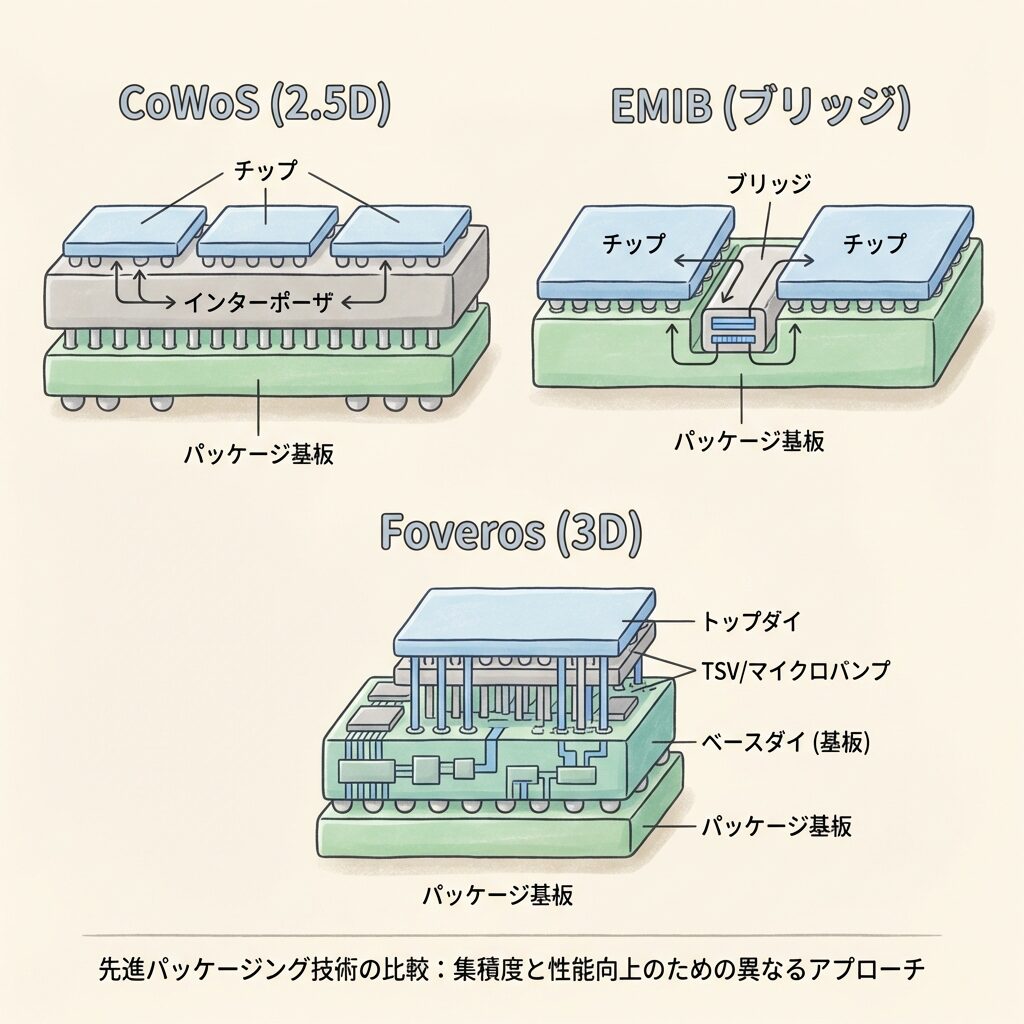
先端パッケージ技術はTSMC独占ではなく、Intelも独自技術を持っています。ただし、AI GPUの主戦場ではCoWoSが圧倒的な実績を持っています。
技術名
開発元
方式
特徴
CoWoS
TSMC
インターポーザー上にチップを横並び(2.5D)
AI GPUの事実上の標準。製造成熟度が最も高い
EMIB
Intel
基板に埋め込んだ小さなシリコンブリッジでチップを接続
大型インターポーザー不要でコスト低減。ペア接続向き
Foveros
Intel
チップを垂直に積み重ねる(3D)
省面積だが、発熱管理が課題。異なるプロセスの混載に有利
出典:Introlの技術比較を参考に構成(出典 )
ひとことメモ
AI GPUの世界では、NVIDIAがGPU設計、TSMCがチップ製造とCoWoSパッケージング、SK HynixがHBM製造という「3社の分業体制」が事実上の業界標準になっています。Intelは自社で設計・製造・パッケージングを手がける「垂直統合」を目指していますが、AI GPU市場ではNVIDIA+TSMCの組み合わせが圧倒的な実績を持っています。
よくある誤解を整理する
よくある誤解
実際はこう
「CoWoSはNVIDIAの技術」
CoWoSはTSMCが開発・製造する技術 。NVIDIAは「CoWoSを使ってGPUを包んでもらう」立場。設計(NVIDIA)・メモリ(SK Hynix)・パッケージング(TSMC)の3社分業。
「CoWoSはチップの微細化技術」
微細化は「チップ内部の回路を小さくする」技術。CoWoSは「完成した複数のチップを1つにまとめる」パッケージ技術 。まったく別の工程。
「パッケージ技術は地味な裏方」
AI時代には、パッケージング技術がGPU出荷数を直接制約する最大のボトルネック 。「裏方」どころか、AI産業の成長速度を決める主役。
「CoWoSはどの半導体メーカーでも使える」
CoWoSはTSMCの独自技術(商標) 。他社は同等技術を持っているが、CoWoSの製造成熟度とAI GPUでの実績は現時点でTSMCが圧倒的。
「CoWoSの3種類はすべて同じくらい重要」
現在の主流はCoWoS-L (Blackwell B200が採用)。CoWoS-Sは前世代、CoWoS-Rは一部用途。NVIDIAの最新GPUを追うなら、CoWoS-Lの動向が最重要。
あなたにとっての意味──投資家・学生・技術者の視点
投資家の方へ
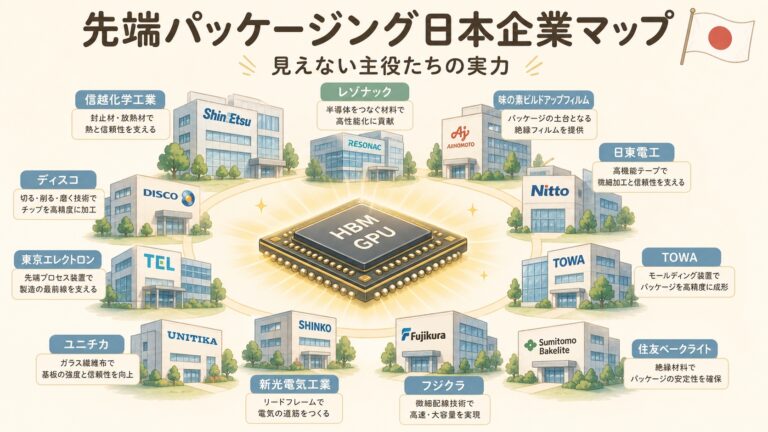
AI関連投資で「NVIDIA」だけを見ていませんか? NVIDIAの業績は、TSMC(CoWoSの製造能力)とSK Hynix(HBMの供給量)に直接依存しています。CoWoSの生産能力がNVIDIAのGPU出荷数を決めるということは、TSMCのCoWoS増産計画やCapEx(設備投資)がNVIDIA株価の先行指標 になり得るということです。さらに、CoWoSに使うシリコンインターポーザーの研磨装置(ディスコ等)、検査装置(アドバンテスト等)、パッケージング用基板メーカーも、サプライチェーンの上流として注目に値します。
学生の方へ
半導体産業の「次の主戦場」は微細化ではなくパッケージングに移りつつあります。CoWoS・TSV・2.5D/3D実装・チップレット設計は、半導体エンジニアが今後必ず直面する技術領域です。これは情報系だけでなく、電気工学(信号伝送設計)・材料工学(インターポーザー素材)・精密機械(実装装置) の学生にとっても大きなキャリアチャンスです。「半導体 = 回路設計だけ」という時代は終わりました。
技術者の方へ
CoWoSパッケージングの技術は、AIデータセンターの設計・運用にも影響を及ぼします。パッケージサイズの拡大はソケット設計や冷却設計に直結し、消費電力の増加は電力設備の要件を変えます。「チップの中身」だけでなく「チップの包み方」が、システム設計の前提条件を変えている──これを理解しておくことで、インフラ設計の精度が上がります。
まとめ:CoWoSの全体像
この記事のまとめ
① CoWoSとは: Chip on Wafer on Substrate。GPUとHBMをシリコンインターポーザー上に横並びに配置し、1つのパッケージに統合するTSMCの先端パッケージ技術。② なぜ必要か: GPUとHBMの距離を数cmから数mmに縮め、1,024bit超の超広バス幅を確保する。これにより帯域幅が数十倍向上し、メモリウォール問題を解消する。③ 仕組み: チップをインターポーザーに載せ(Chip on Wafer)、それを基板に搭載(on Substrate)する3層構造。TSVで垂直接続。④ 3種類: CoWoS-S(フルシリコン・H100)、CoWoS-L(RDL+ブリッジ・B200・現在の主流)、CoWoS-R(RDLのみ・低コスト)。⑤ GPU進化との関係: A100→H100→H200はCoWoS-S、B200からCoWoS-Lへ移行。HBMスタック数の増加がパッケージ大型化を要求。⑥ ボトルネック: NVIDIAはTSMCのCoWoS-L生産能力の70%超を確保。CoWoS生産能力がAI GPU出荷数を直接制約する最大のボトルネック。⑦ チップレット時代: 半導体の進化の主軸が「微細化」から「パッケージング(チップレット統合)」にシフト。CoWoSはその最前線。
結局こういうことです。CoWoSは「GPUとHBMをつなぐ接着剤」のような技術です。GPUがどれだけ高性能でも、HBMがどれだけ高速でも、それらを1つの製品に統合するCoWoSがなければ、AI GPUは存在しません 。そしてこのCoWoSの製造能力が、世界のAI半導体供給の「蛇口」を握っている。だからCoWoSを理解することは、AI産業の構造を理解することなのです。
よくある質問(FAQ)
Q. CoWoSはTSMC以外の企業でも製造できますか?
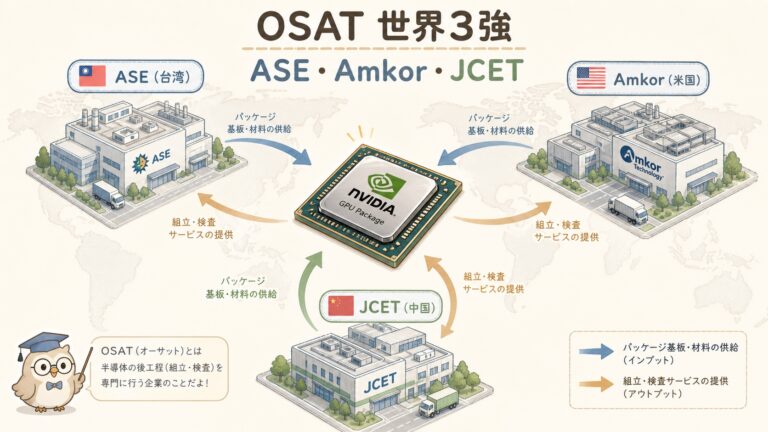
A. CoWoSはTSMCの独自技術(商標)であり、同じ名前の技術は他社にはありません。ただし、同等の2.5D実装技術はIntel(EMIB)やASEなどのOSAT(外部パッケージング受託企業)も開発・量産しています。しかし、AI GPUの分野ではTSMCのCoWoSが圧倒的な実績と製造成熟度を持っており、NVIDIAの主要GPU(H100・B200)はすべてTSMCのCoWoSで製造されています。
Q. CoWoSの製造能力不足は、いつ解消されますか?
A. TSMCは2026年末までにCoWoS月産能力を12〜13万枚に拡大する計画ですが、世界のCoWoS需要は2026年に100万枚/年に達する見通しで、需要と供給のギャップは当面続くと見られています。パッケージング工場の建設には年単位の時間がかかるため、「需要急増→供給拡大→追いつく」のサイクルには構造的なタイムラグがあります。
Q. CoWoSの次の技術として注目されているものはありますか?
A. NVIDIAは「CoWoP(Chip on Wafer on PCB)」と呼ばれる次世代パッケージ技術を検討していると報じられています。これはGPUダイをマザーボード(PCB)に直接実装する方式で、パッケージ基板を省略してコスト削減や大型化を目指すものです。ただし現時点では研究段階であり、実用化にはPCBの配線微細化など多くの技術課題があります。
この記事のテーマを、本でもっと深く PR(アフィリエイト広告)
¥2,200 (2026/10/04 13:17時点 | Amazon調べ)
ポチップ
S
シラス
電験三種・QC検定1級 / メーカーでパワエレ設計・品質保証 実務10年
メーカーで回路設計と生産技術(品質改善)に携わってきた経験をもとに、AIインフラを支える半導体・電力・冷却の仕組みを、図解でやさしく解説しています。
テーマ別に、もっと深く学ぶ 気になるところから読んでも大丈夫です。どの記事も、はじめての方にもわかるように図解で書いています。
HBM・先端パッケージをもっと深く
つまずきやすい「違い」を解決
あわせて知りたい、隣のテーマ
記事の更新情報を受け取りたい方へ
新しい記事が公開されたら、Xアカウント @shirasusolo でお知らせします。AIインフラの構造を一緒に学んでいきましょう。




コメント