
「GPUサーバー」「AIサーバー」──最近、AIやデータセンターのニュースで本当によく見かける言葉ですよね。でも、こんなふうに感じていませんか?
この記事では、「そもそもGPUサーバーって何が違うの?」という疑問に、図解と比喩を使って丁寧に答えていきます。AIデータセンターの全体像を理解するうえで、GPUサーバーの理解は「最初の一歩」です。ここを押さえれば、電力問題も冷却問題も、すべて「なぜそうなるのか」が見えてきます。
- GPUサーバーとは? ── まずは30秒で理解する
- CPUとGPUの「仕事のやり方」はこんなに違う
- 一般サーバー(CPUサーバー)とGPUサーバーの構成比較
- AIサーバーの中身(構造)──GPU 8基の型の例
- 「AIサーバー」と「GPUサーバー」は何が違うのか?
- GPUサーバーの主な種類を比較する
- GPUの消費電力はどれくらい? ── 世代ごとに急増している
- なぜGPUサーバーは「発熱の怪物」になるのか?
- GPUサーバーはデータセンターの設計をどう変えるのか?
- よくある誤解を整理する
- あなたにとっての意味 ── 投資家・学生・技術者の視点
- まとめ:GPUサーバーの全体像
- よくある質問(FAQ)
GPUサーバーとは? ── まずは30秒で理解する
一言でいうと「GPUを積んだ専用計算マシン」
GPUサーバーとは、GPU(Graphics Processing Unit:画像処理装置)を複数搭載したサーバーのことです。
「サーバー」とは、ネットワークの向こう側で処理をしてくれるコンピュータのこと。普段みなさんがWebサイトを見たり、メールを送ったりするとき、裏側で動いているのがサーバーです。そのサーバーのなかに「GPU」という特殊なチップをたくさん積んだものが、GPUサーバーです。
もう少し身近な例えで説明しましょう。
HPE(ヒューレット・パッカード・エンタープライズ)は、GPUサーバーを「標準のCPUに加えてGPUを備えたサーバーの一種」と定義しています(出典:HPE公式)。ポイントは、GPUサーバーにもCPUは入っているということ。GPUだけで動くわけではなく、CPUが全体の管理を行い、GPUが大量計算を担当するという「役割分担」で成り立っています。
CPUとGPUの「仕事のやり方」はこんなに違う
料理で例えると、一目でわかる
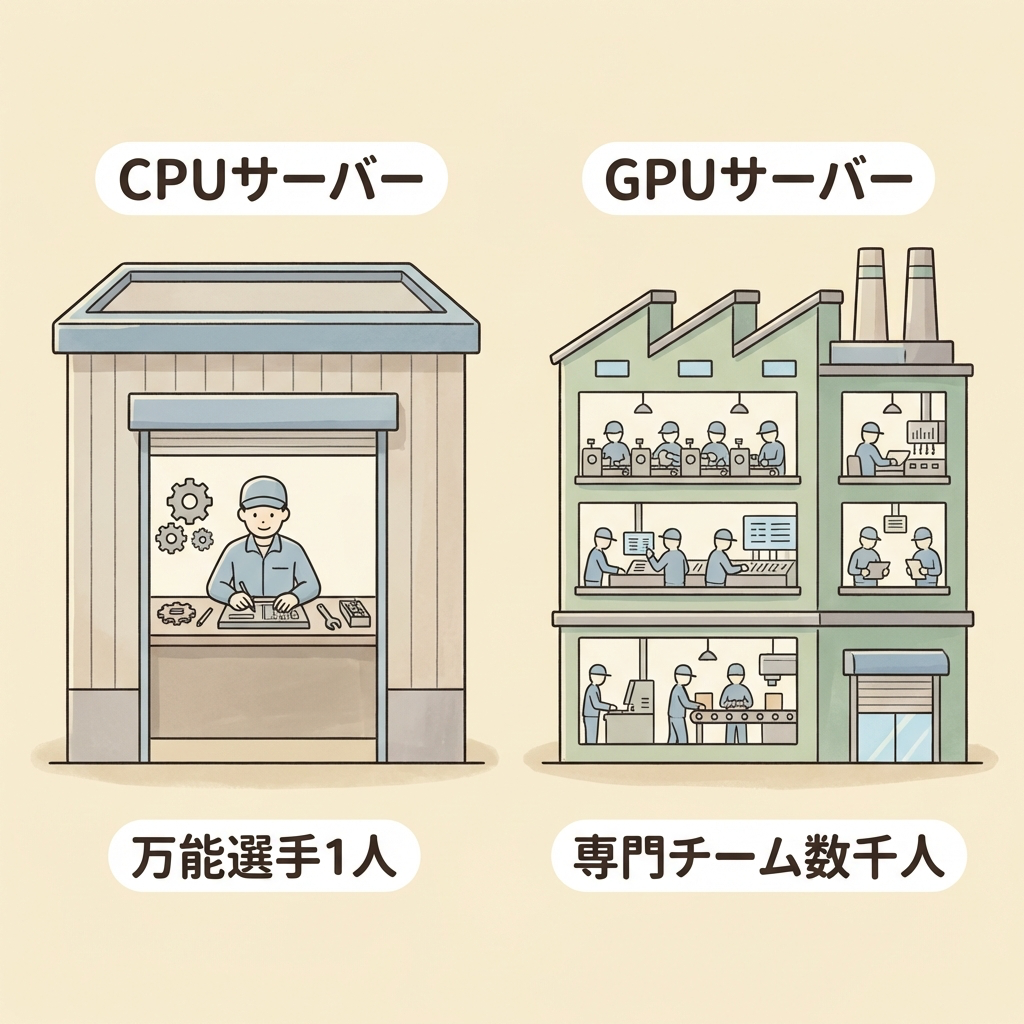
CPUとGPUの違いは、「仕事のやり方」がまるで違うことに尽きます。性能の高い低いではなく、得意分野が根本的に異なるのです。
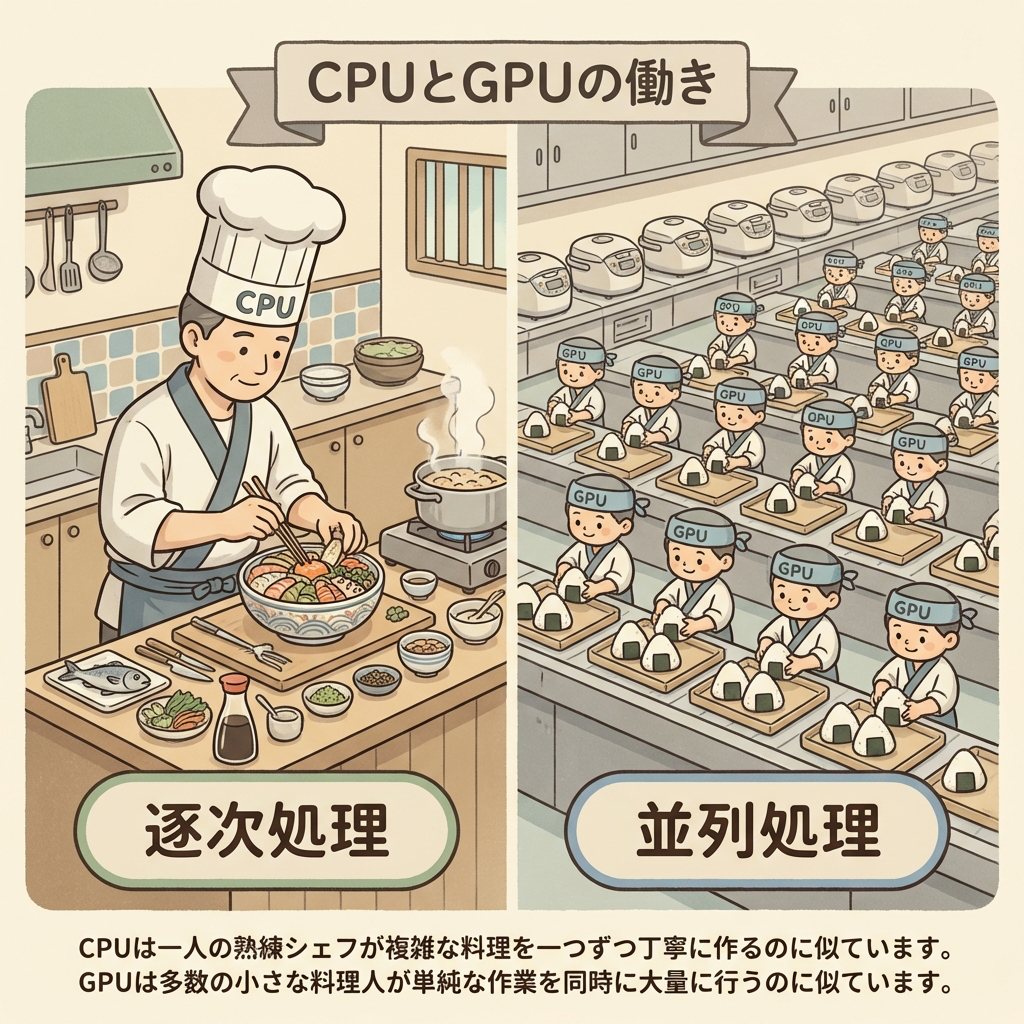
料理に例えてみましょう。
スペックで見る違い ── コア数が桁違い
料理の例えを数字に戻しましょう。CPUとGPUで決定的に違うのが「コア」の数です。コアとは、実際に計算を行う処理ユニットのことです。
| 比較項目 | CPU(例:サーバー用) | GPU(例:NVIDIA H100) |
|---|---|---|
| コア数 | 数十個(例:64コア) | 数千〜1万個以上(例:14,592コア) |
| 1コアの能力 | 高い(複雑な処理が得意) | 低い(単純な計算に特化) |
| 得意な処理 | 複雑な判断を順番にこなす (逐次処理) |
同じ計算を大量に同時実行 (並列処理) |
| 例えるなら | 超一流シェフ1人 | 専門調理師 数千人チーム |
CPUのコアが数十個なのに対して、GPUのコアは1万個以上。この桁違いのコア数が、「同じ計算を超大量に同時にこなす」並列処理力を生んでいます。
なぜAI処理にはGPUが必要なのか?
AIの学習(トレーニング)で何が起きているかというと、大量のデータに対して「同じような計算を何兆回も繰り返す」という処理をしています。
たとえばChatGPTのような大規模言語モデルの学習では、数兆個のパラメータ(数値の重み)を、膨大なテキストデータを使って少しずつ調整していきます。この「少しずつ調整する計算」は、1回1回は単純なのですが、それを数兆回繰り返す必要があるのです。
CPUで行えば数ヶ月かかるAI学習が、GPUを数千台並べることで数日〜数週間に短縮できます。これが「AIにはGPUが不可欠」と言われる理由です。GPUはもともとゲームの3D映像描画のために生まれたチップですが、その並列処理能力がAIの計算にぴったりだったのです(出典:デロイト トーマツ)。
一般サーバー(CPUサーバー)とGPUサーバーの構成比較
中身がまるで違う ── 7つの観点で比較
見た目はどちらもラックに収まる箱型ですが、中身はまったくの別モノです。以下の表で、主要な構成要素を一気に比較してみましょう。
| 構成要素 | CPUサーバー(一般サーバー) | GPUサーバー |
|---|---|---|
| 主な処理チップ | CPU 1〜2基 | CPU 1〜2基 + GPU 4〜8基 |
| GPU搭載数 | なし or 1基(補助的) | 4〜8基(高密度モデルはさらに多い) |
| メモリ(RAM) | 数十〜数百GB | 数百GB(CPU用)+ GPU専用メモリ(HBM)数百GB |
| 消費電力 | 300〜800W 程度 | 3,000〜10,000W(3〜10kW) |
| GPU間接続 | 不要 | NVLinkなど超高速接続が必須 |
| 冷却方式 | 空冷(ファン)で十分 | 空冷 or 液冷が必要(高密度の場合) |
| 主な用途 | Web/メール/DB/業務システム | AI学習・推論、3D処理、科学計算 |
| 価格帯 | 数十万〜数百万円 | 数百万〜数千万円(GPU単体で数百万円) |
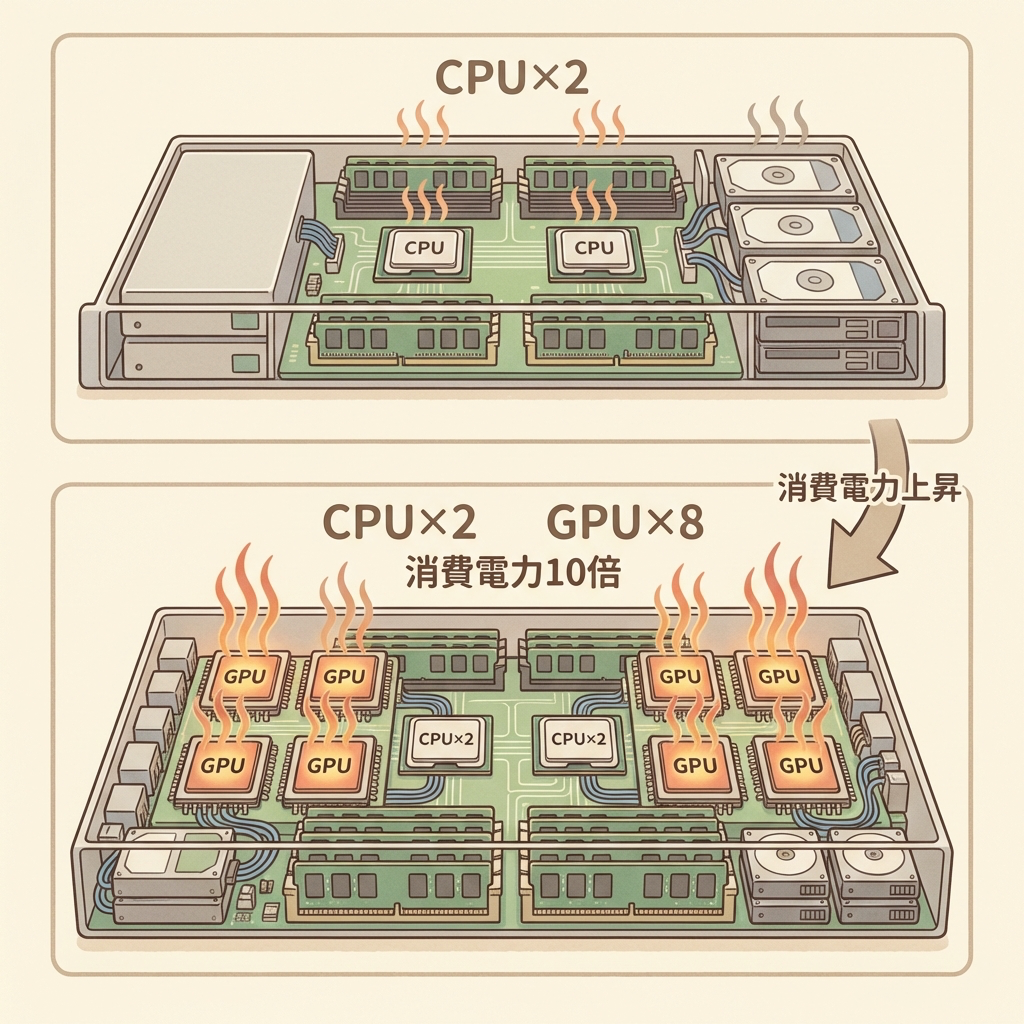
構成イメージ ── 「中身のレイアウト」が根本的に異なる
2つのサーバーの内部構成を、簡略化したイメージで見てみましょう。
この続きと一緒に読まれている記事
見ての通り、GPUサーバーでは内部スペースの大部分をGPUが占めています。NVIDIA DGX H100のような代表的なGPUサーバーは、H100 GPU×8基を搭載し、最大消費電力は約10.2kW(10,200W)に達します(出典:Uvation)。家庭用エアコン3〜4台を同時にフル運転しているのと同程度の電力です。
図の「GPU間接続」の中心がNVIDIA独自の専用配線NVLinkで、最新のラックではこれをNVSwitchで束ね、サーバーの枠を超えて多くのGPUを1台の巨大なGPUのように動かします(NVLinkとは?「1台の巨大GPU」を作る技術)。
AIサーバーの中身(構造)──GPU 8基の型の例
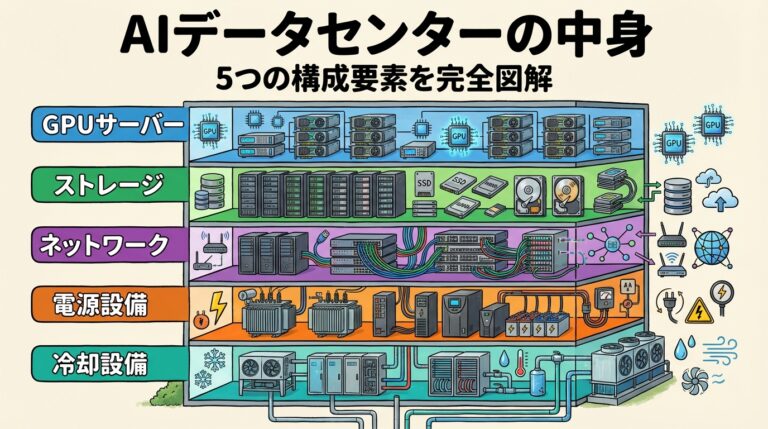
「AIサーバー 構造」「GPU 構造」と調べる方のために、いま多いGPU 8基の型(HGXなど)を例に、箱の中の部品を役割ごとに並べます。
「AIサーバー」と「GPUサーバー」は何が違うのか?
結論:技術的にはほぼ同義。ただし「視点」が違う
「GPUサーバー」と「AIサーバー」──この2つの言葉を目にして、「結局、同じもの? 違うもの?」と混乱する方は多いです。結論から言えば、技術的にはほぼ同じものです。ただし、名前を付ける「視点」が異なります。
TD SYNNEX社の解説では、「AIサーバーは、GPUサーバーとほぼ同義ですが、よりAI処理に特化して最適化したサーバーを指します」と説明されています(出典:TD SYNNEX)。
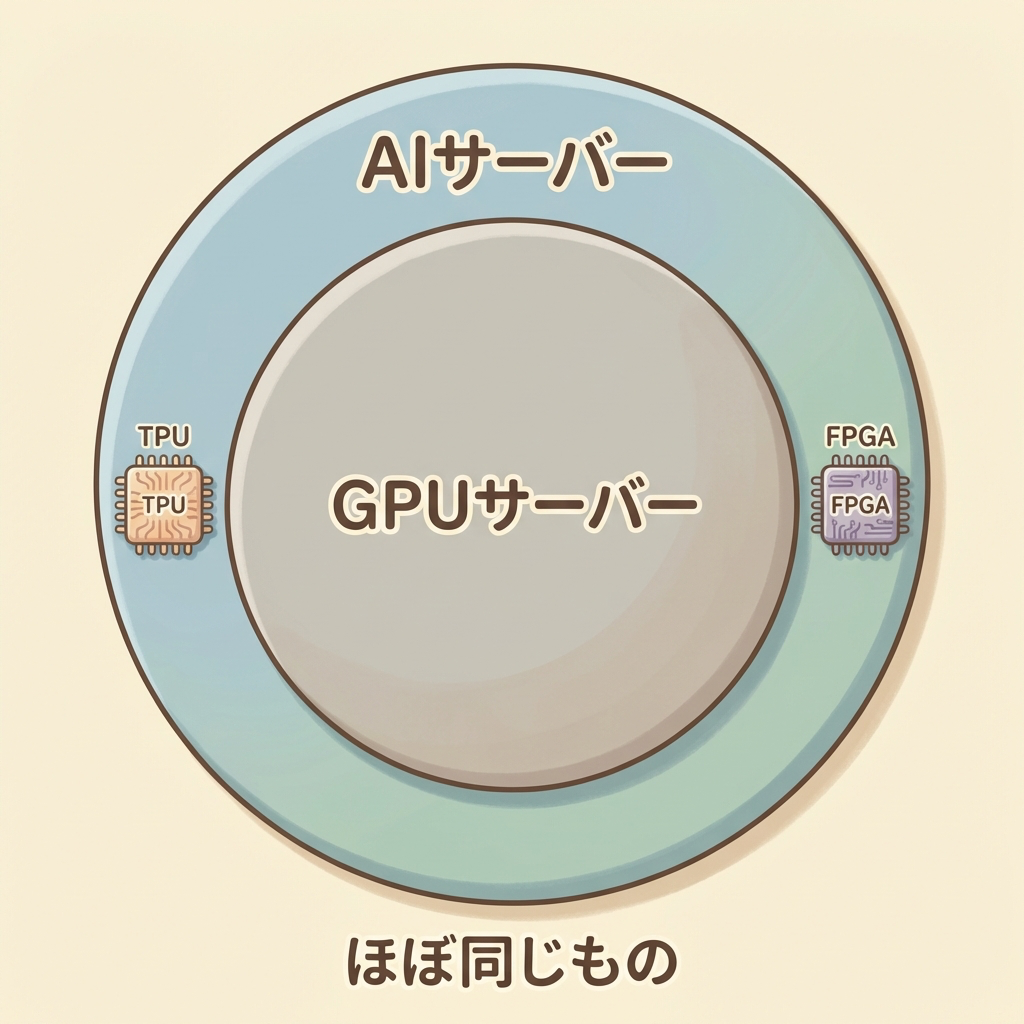
もう少し厳密に言えば、AIサーバーにはGPU以外の「AIアクセラレーター」(GoogleのTPU、FPGAなど)を搭載するケースもあります。つまり、AIサーバーの方がGPUサーバーより少し広い概念です。ただし現実の市場では、AIサーバーの大半がNVIDIA GPUを搭載しているため、「AIサーバー ≒ GPUサーバー」と考えてほぼ問題ありません。
| 比較項目 | GPUサーバー | AIサーバー |
|---|---|---|
| 名前の視点 | ハードウェア構成 | 用途・目的 |
| 搭載チップ | GPU(NVIDIAなど) | GPU、TPU、FPGA等の AIアクセラレーター全般 |
| 用途 | AI、3D、科学計算など幅広い | AI処理(学習・推論)に特化 |
| 実態 | 現実にはほぼ同じもの(市場の大半がNVIDIA GPU搭載) | |
GPUサーバーの主な種類を比較する
「GPUサーバー 比較」と調べる方のために、いま使われている主な型を、中身と冷やし方で比べました。同じGPUサーバーでも、カードを差すだけの型から、ラック1台を1つの大きな計算機にする型まで幅があります。
GPUの消費電力はどれくらい? ── 世代ごとに急増している
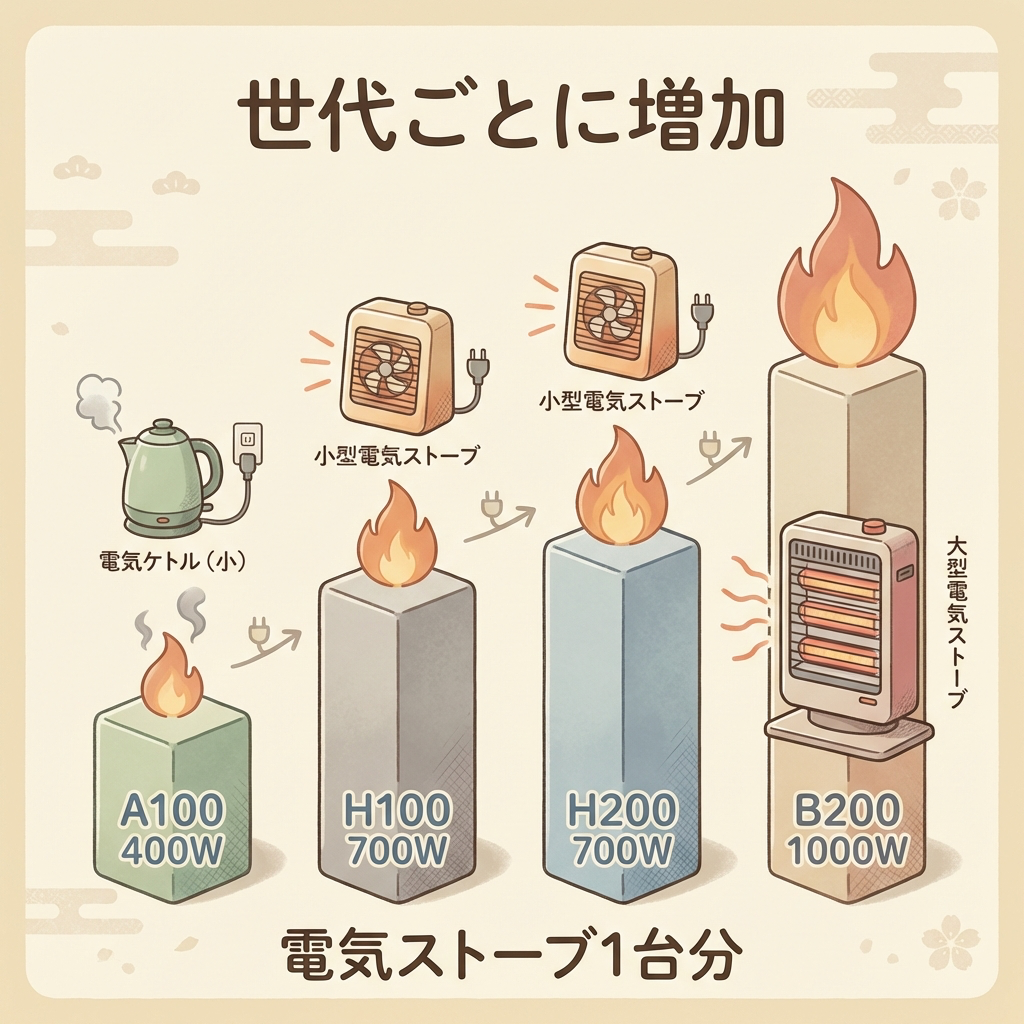
GPU1枚の消費電力が「電気ストーブ1台分」に
GPUサーバーを理解するうえで、絶対に押さえておきたいのが「GPU1枚あたりの消費電力がどんどん増えている」という事実です。NVIDIAのデータセンター向けGPUの消費電力(TDP)の推移を見てみましょう。
| GPU世代 | 消費電力(TDP) | 身近な例え | 登場時期 |
|---|---|---|---|
| A100 | 400W | ドライヤー弱風 | 2020年 |
| H100 | 700W | 電子レンジ運転中 | 2022年 |
| H200 | 700W | 同上(メモリ強化版) | 2024年 |
| B200 | 1,000W | 電気ストーブ1台 | 2024年 |
※TDP=Thermal Design Power(熱設計電力)。チップが最大負荷時に消費する電力の目安。
出典:各世代の仕様は NVIDIA H200公式、NVIDIA Blackwell発表より
A100の400Wから、最新のB200は1,000W。わずか4年で消費電力が2.5倍になっています。GPU1枚で電気ストーブ1台分──これがGPUサーバーに8枚搭載されるのですから、1台のサーバーで「電気ストーブ8台をフル稼働」しているのと同じ状態です。
GPU×8基 = 1台で10kW超。サーバー1台でこの電力
具体的に計算してみましょう。NVIDIA DGX H100(H100 GPU×8基搭載のサーバー)の最大消費電力は約10.2kWです。家庭の電気の契約でよくある30A(約3kVA)で考えると、約3軒分の上限いっぱいの電気を、サーバー1台で使い続ける計算です。これが数百〜数千台集まるのがAIデータセンターです。
2025〜2026年の世代:B300とRubin
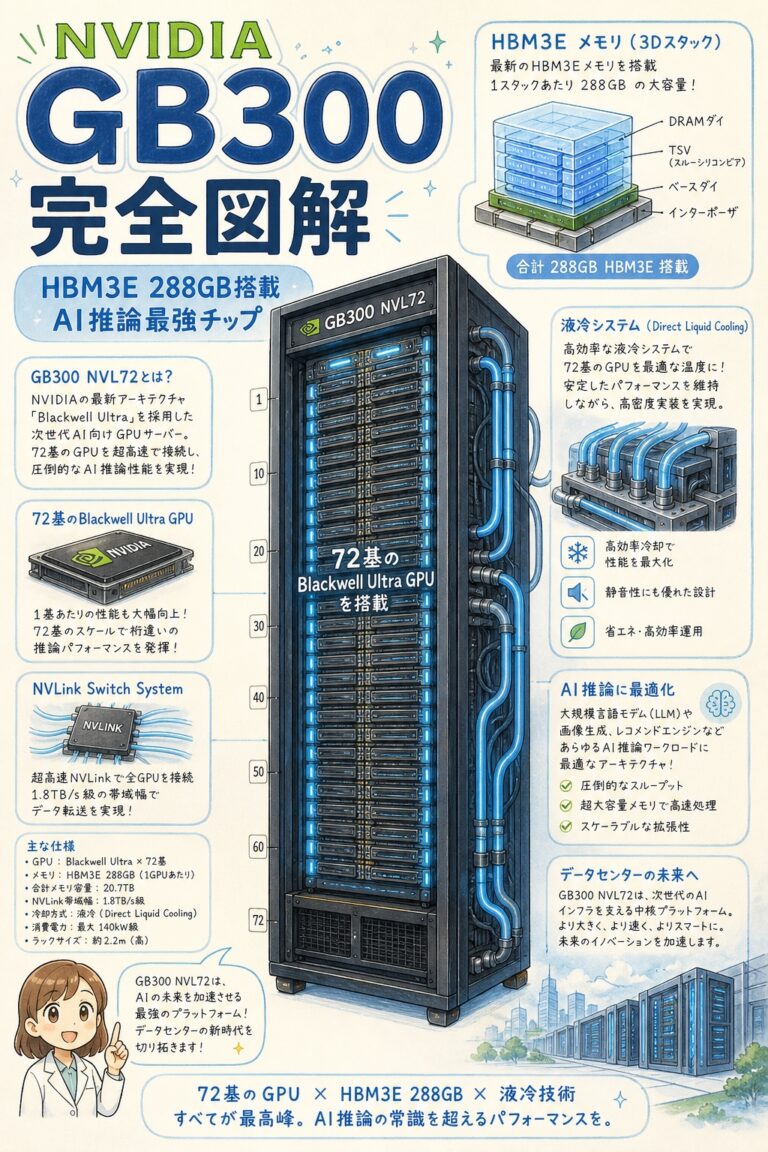
表のあとも世代は進んでいます。2025年にはBlackwellの強化版(B300・GB300)の量産出荷が始まり、NVIDIAは2026年8月の決算発表で、次の世代のVera Rubinが本格生産に入ったと説明しました。Rubin 1基のHBM4は288GBです。1基の消費電力は、NVIDIAの仕様表には載っていません(2026年10月時点)。
GB300の中身と消費電力はNVIDIA GB300とはでまとめています。
なぜGPUサーバーは「発熱の怪物」になるのか?
電力の大部分は「熱」に変わる
GPUサーバーの消費電力が大きいことは前章で見ました。では、その電力はどこへ行くのか? 答えはシンプルです──消費された電力の大部分は「熱」に変わります。
これは物理法則です。半導体チップが電気エネルギーを使って計算すると、その過程でエネルギーの一部が熱として放出されます。GPUは数千のコアが全力で計算を続けるので、発熱量も桁違いになるのです。
わかりやすい比喩で考えてみましょう。
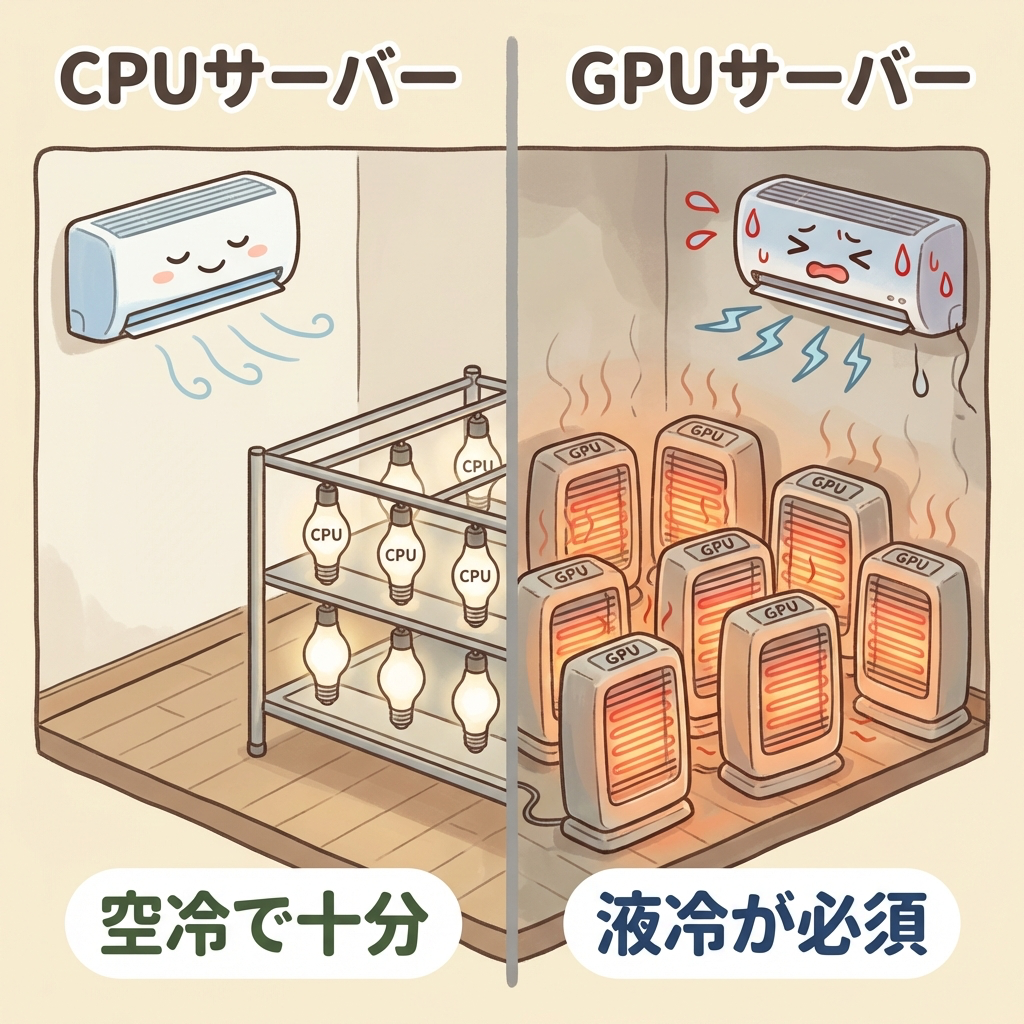
空冷の限界 → 液冷が不可欠に
従来のデータセンターでは、サーバーの冷却は「空冷」が主流でした。強力なエアコンでサーバールーム全体に冷たい空気を送り込む方式です。
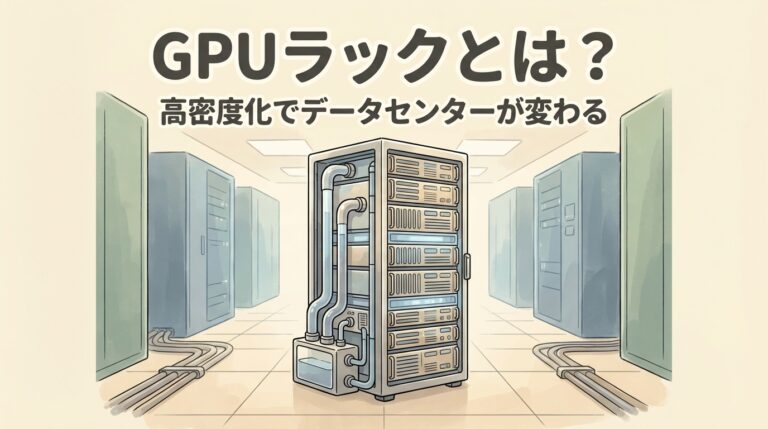
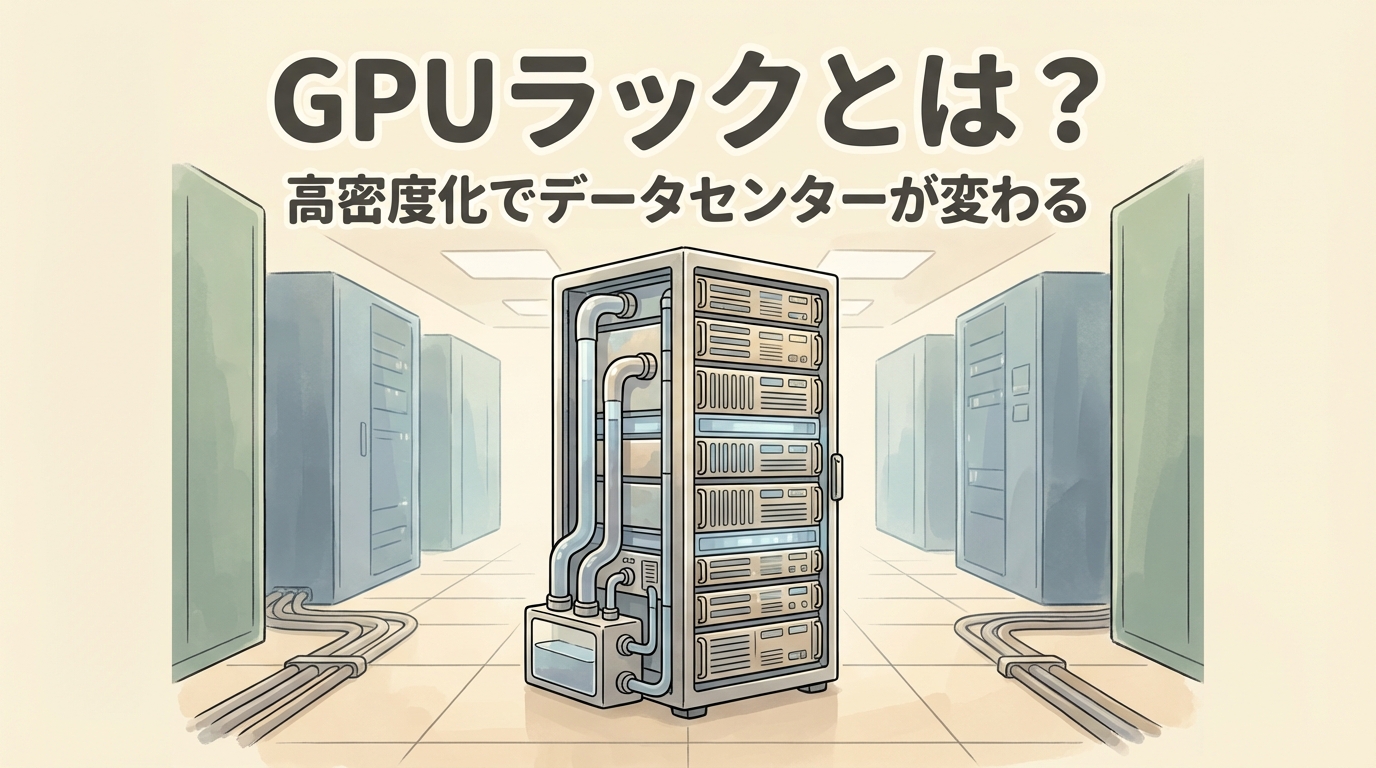
しかし、空冷で対処できるのはラックあたり20kW程度が限界とされています(出典:日経クロステック)。GPUサーバーを数台詰め込んだラックは50kW〜120kWに達するため、空冷ではまったく追いつきません。
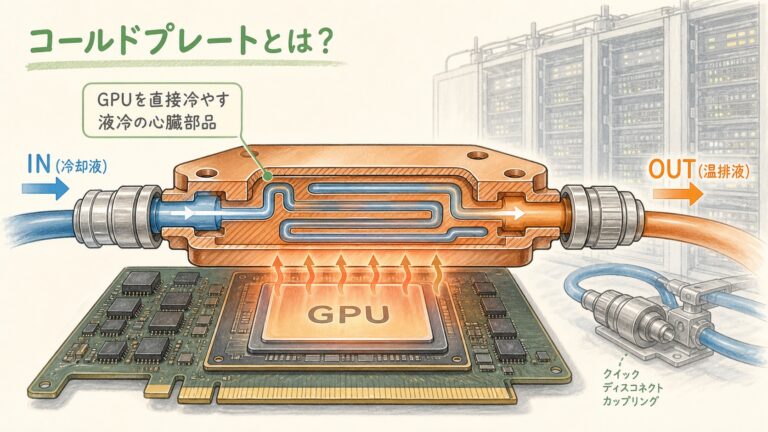
そこで必要になるのが「液冷」です。水や特殊な冷却液をパイプでチップ直近まで送り、熱を直接奪う方式です。液体は空気に比べて熱伝導率が格段に高いため、高密度なGPUサーバーの冷却に対応できます。
GPUサーバーはデータセンターの設計をどう変えるのか?
「建物」から変えないと、GPUサーバーは置けない
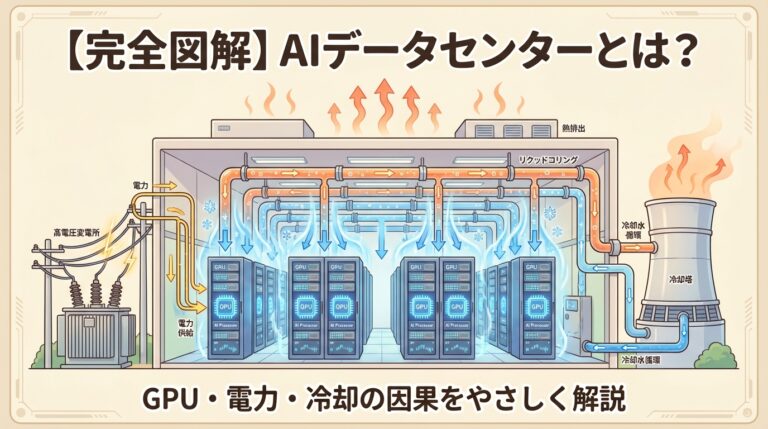
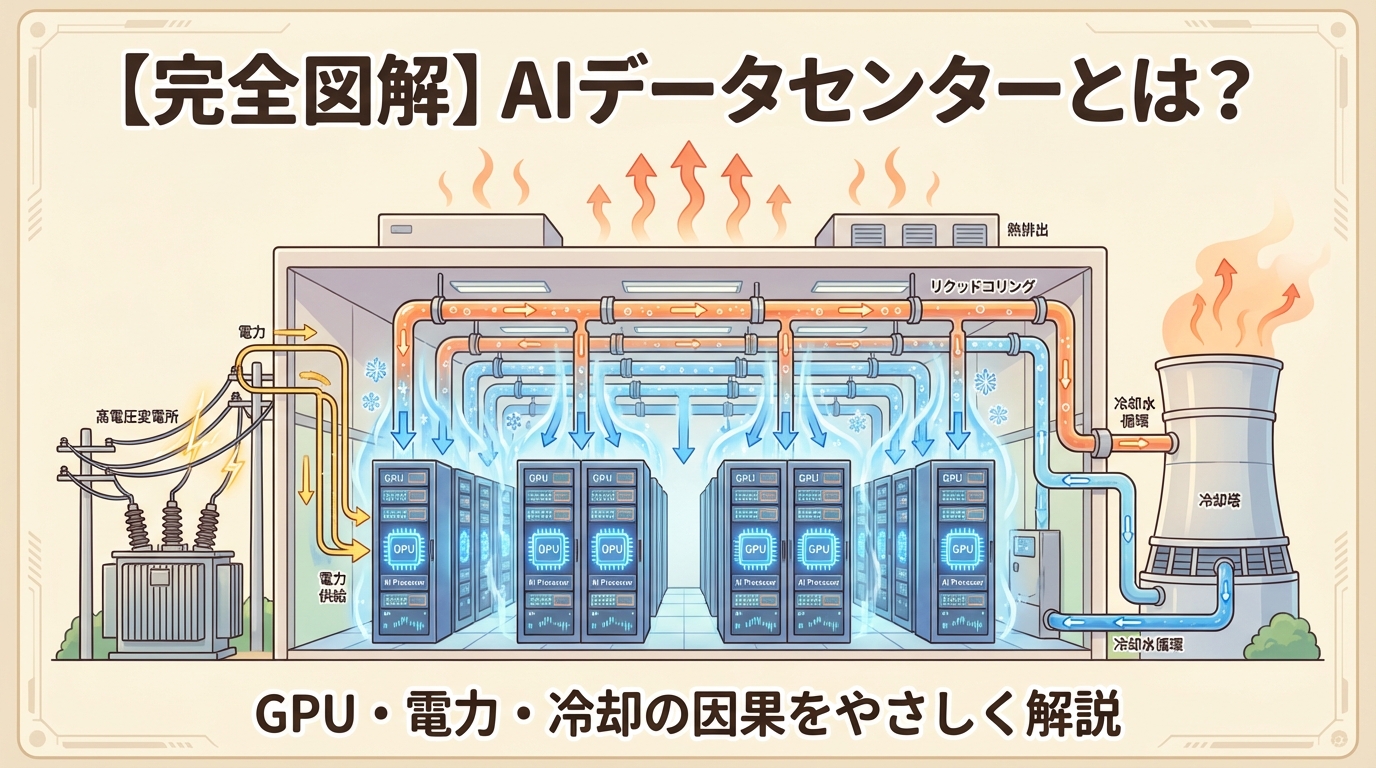
ここまで読んでいただければ、GPUサーバーが「普通のサーバーの強化版」ではないことがおわかりいただけたと思います。消費電力も発熱もケタ違い。これはつまり、GPUサーバーを収容するデータセンターの設計そのものが変わるということです。
家に例えましょう。普通のサーバーが「一般家庭の電化製品」だとすると、GPUサーバーは「業務用の製造設備」です。業務用のオーブンや大型プレス機を家に入れようとしたら、電気の契約を変えて、配線を太くして、排熱ダクトを設置して、床の補強もしなければなりません。同じ「建物に機器を入れる」でも、対応すべきことがまったく違うのです。
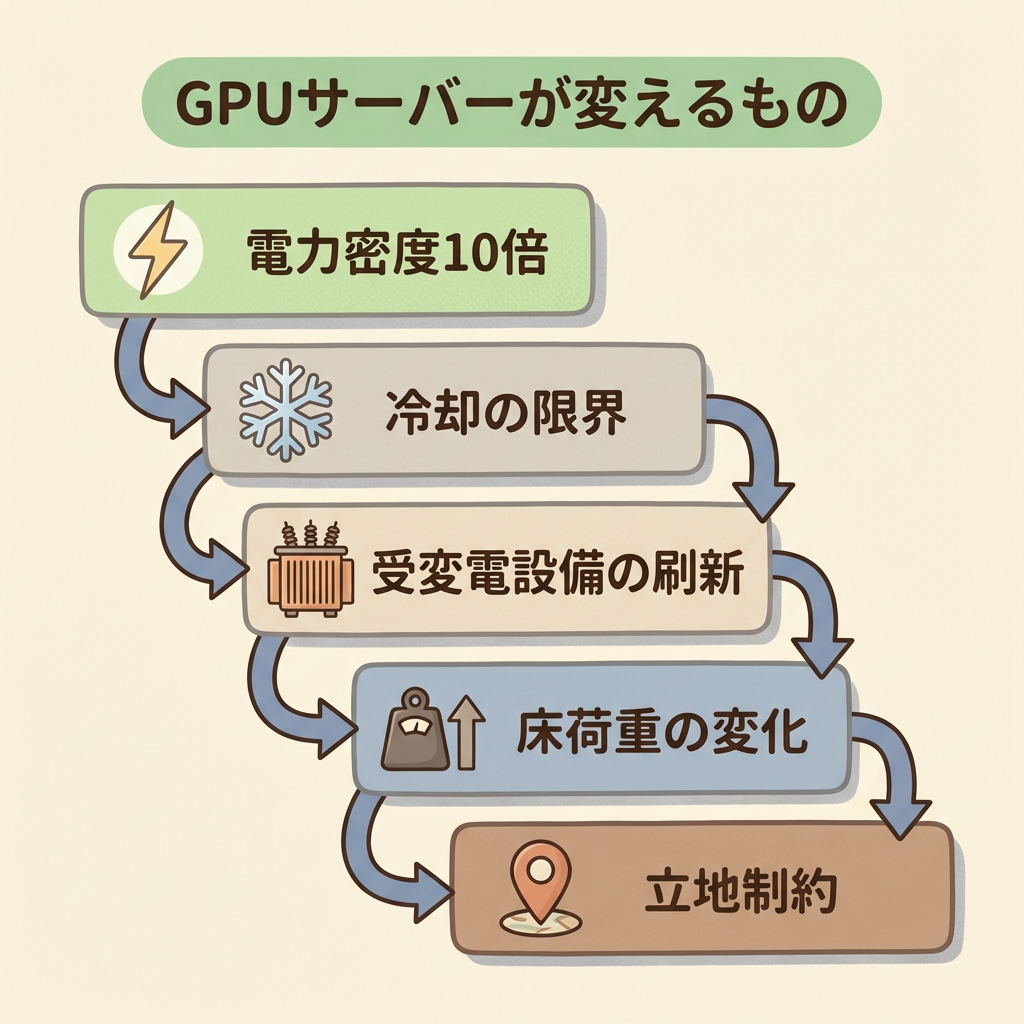
GPUサーバーがデータセンターに与える影響 ── 5つの連鎖
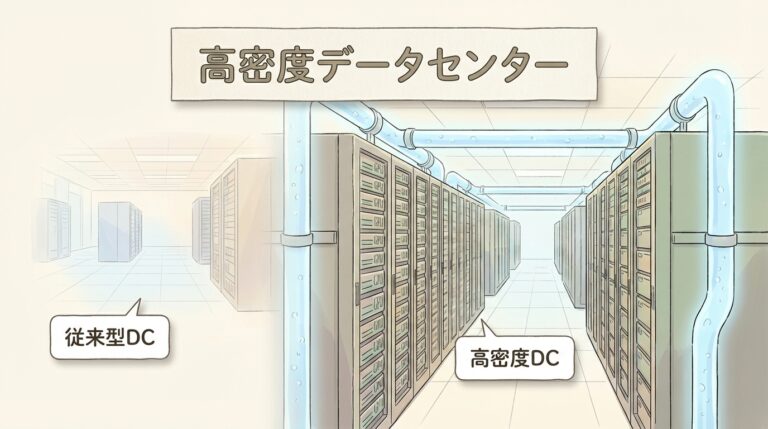
| 比較項目 | 従来型DC(CPUサーバー中心) | AI対応DC(GPUサーバー中心) |
|---|---|---|
| ラック電力密度 | 5〜10kW | 50〜120kW |
| 冷却方式 | 空冷(エアコン) | 液冷(水冷・液浸) |
| 電力設備 | 一般的な受変電設備 | 専用変電所レベル |
| ネットワーク | 数Gbps〜数十Gbps | 数百Gbps〜Tbps級 |
| 施設全体の電力 | 数MW〜数十MW | 数百MW〜GW級 |
ネットワークが太くなるほどGPU同士をつなぐスイッチの電力も増えるため、光を電気に変えずに小さな鏡で経路を切り替えて電力を抑えるOCS(光回線スイッチ)を、GoogleはTPUクラスタで使い続けています(OCS(光回線スイッチ)とは?)。
よくある誤解を整理する
誤解と 実際
| よくある誤解 | 実際はこう |
|---|---|
| 「GPUサーバーはGPUだけで動く」 | CPUが全体の管理や前処理を担当し、GPUが大量計算を実行する役割分担制。CPUなしにGPUは動けない。 |
| 「普通のサーバーにGPUを後付けすればいい」 | GPUサーバーは基板設計・電源・冷却・GPU間接続が専用設計。後付けではGPUの性能を引き出せない。 |
| 「GPUサーバーとAIサーバーは別物」 | 技術的にはほぼ同じもの。視点の違い(ハードウェア構成 vs 用途)で呼び方が変わるだけ。 |
| 「GPUは性能が高い=CPUの上位互換」 | GPUは並列処理に特化しているが、複雑な逐次処理はCPUの方が得意。上位・下位の関係ではなく、得意分野が違う。 |
| 「既存データセンターにGPUサーバーを入れればAI対応」 | 電力密度が10倍以上異なるため、冷却・電力・床耐荷重から設計し直しが必要。多くの場合、新築の方が現実的。 |
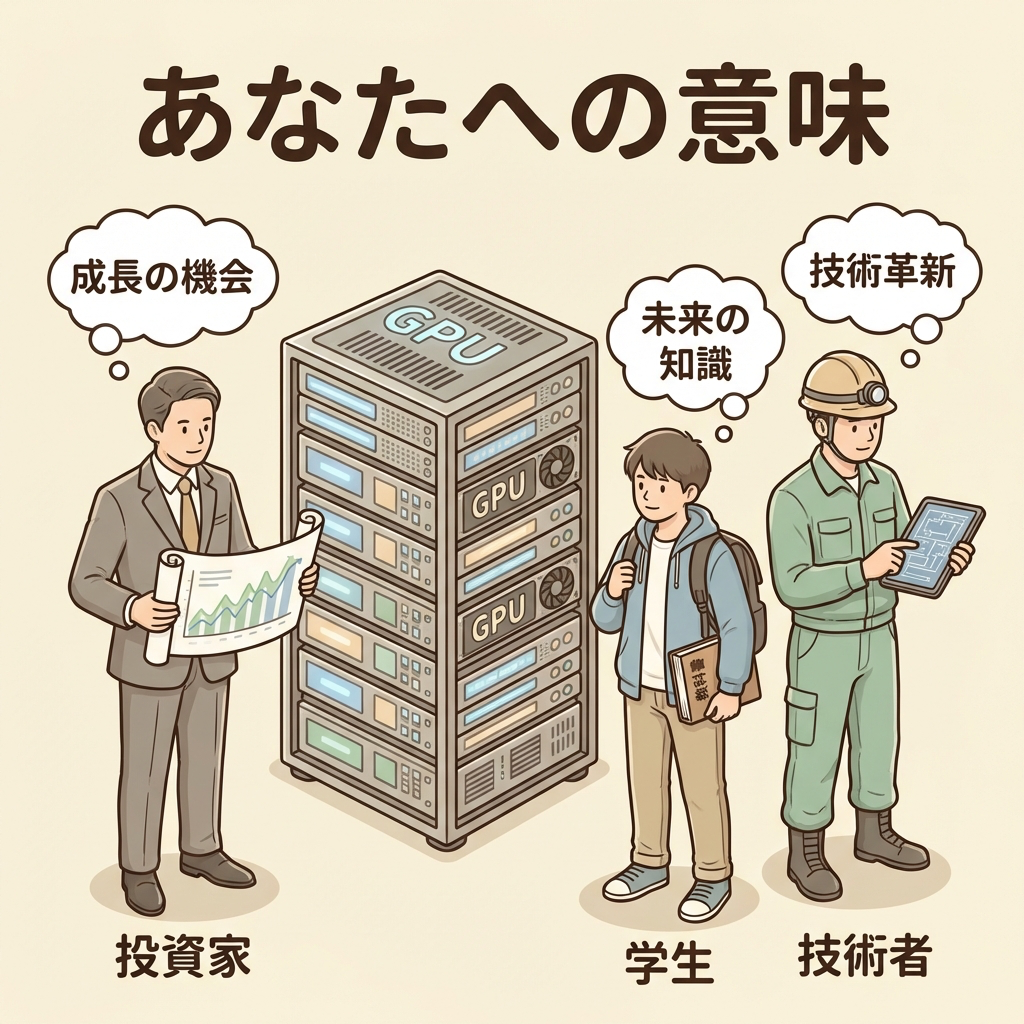
あなたにとっての意味 ── 投資家・学生・技術者の視点
GPUサーバーの理解が、次の一歩を変える
GPUサーバーの構造を理解したことで、「AIの話」が「アルゴリズムの話」だけではないことが見えてきたのではないでしょうか。ここから先、あなたの立場ごとに「何を考え、何を学ぶべきか」を整理します。
まとめ:GPUサーバーの全体像
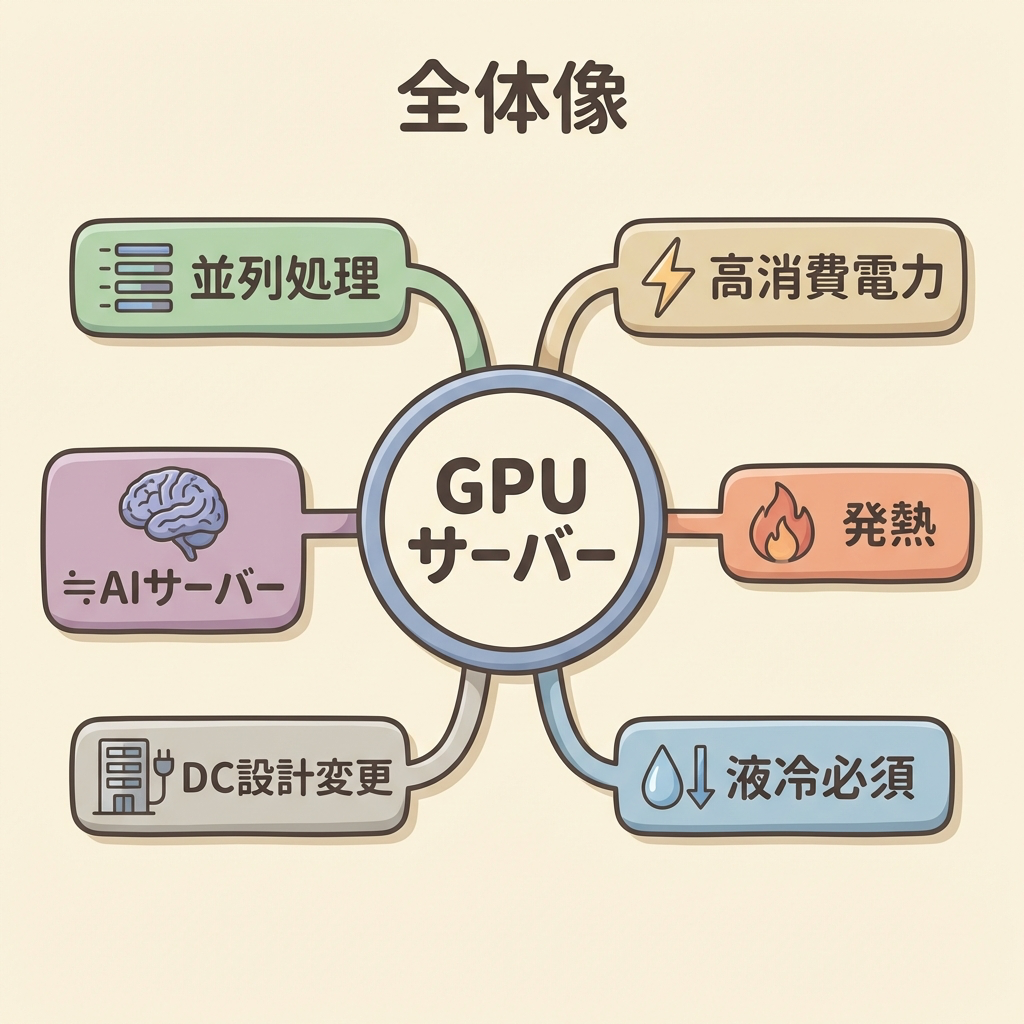
結局こういうことです。GPUサーバーは「普通のサーバーの強化版」ではありません。サーバーの中身が変わることで、ラック設計が変わり、冷却方式が変わり、電力設備が変わり、データセンターの建物そのものが変わる。GPUサーバーの理解は、AIインフラの全体像を理解するための「最初の1ピース」です。
GPUサーバーをたくさん詰め込むと、データセンターには大きな電気と熱の負担がかかります。「普通のデータセンター」では足りない理由は、次の記事で確かめられます。
よくある質問(FAQ)
GPUサーバーの主役であるGPUそのものの中身を知りたい方に。本書(技術評論社)は、CPUとGPUの違い、GPUの超並列処理(SIMD・SIMT)、デバイスメモリやCPUとGPU間のデータ伝送、ディープラーニング時代のAIアクセラレータまでを解説した技術書です。


次に読むべき記事
ここまでで「GPUサーバー」の全体像がつかめました。次は、つながりの深い記事で理解を一歩ずつ広げていきましょう。
テーマ別に、もっと深く学ぶ
気になるところから読んでも大丈夫です。どの記事も、はじめての方にもわかるように図解で書いています。

コメント