
「GPUラック」「高密度データセンター」──AIインフラのニュースで急に目にするようになったこの言葉、こんなふうに感じていませんか?
多くの解説記事は「GPUサーバー」の話で止まりますが、実際にデータセンターの現場を変えているのは「ラック単位の高密度化」です。この記事では、サーバーラックの基本から始めて、GPUラックが従来と何がどう違うのかを、具体的な数字と図解で解説します。
サーバーラックとは?── まず「入れ子構造」を理解する
ラックは「サーバーを収める棚」
AIデータセンターの話に入る前に、まず「ラック」とは何かを押さえましょう。意外とここが曖昧なまま先に進んでしまう方が多いですが、ここを理解するかどうかで、この先の話の通り具合がまったく変わります。
サーバーラック(19インチラック)とは、サーバーやネットワーク機器を縦に積み上げて収納するための専用の棚です。見た目は背の高い金属製のキャビネットで、高さは約2メートル。ここにサーバーを「本棚に本を差し込む」ように、上から下へ順番に積んでいきます。
ラックのサイズには「U(ユニット)」という単位が使われます。1Uは高さ約4.4cm。標準的なラックは42U(約185cm)で、1Uのサーバーなら最大42台まで収容可能です。このラックが、データセンターの床にずらりと数百〜数千本並んでいるわけです。
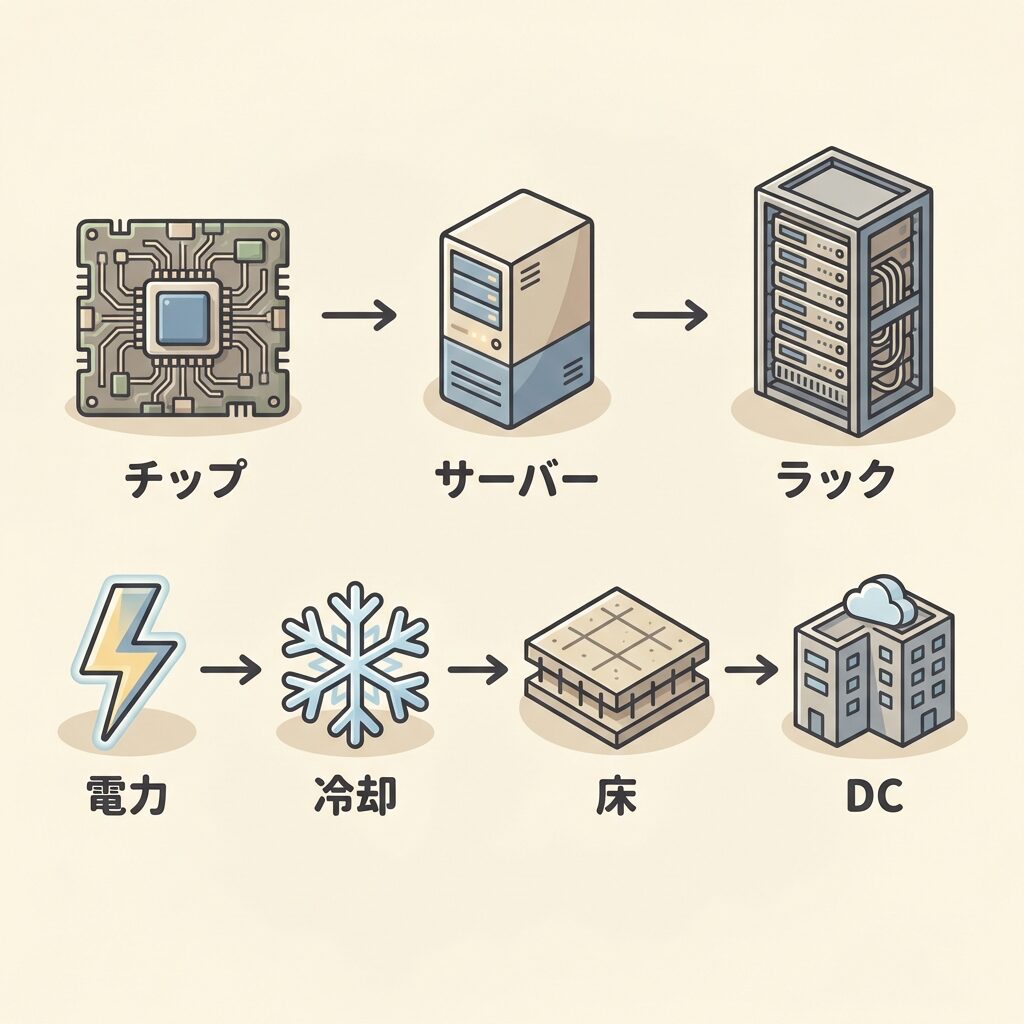
サーバー → ノード → ラック → データセンターの入れ子構造
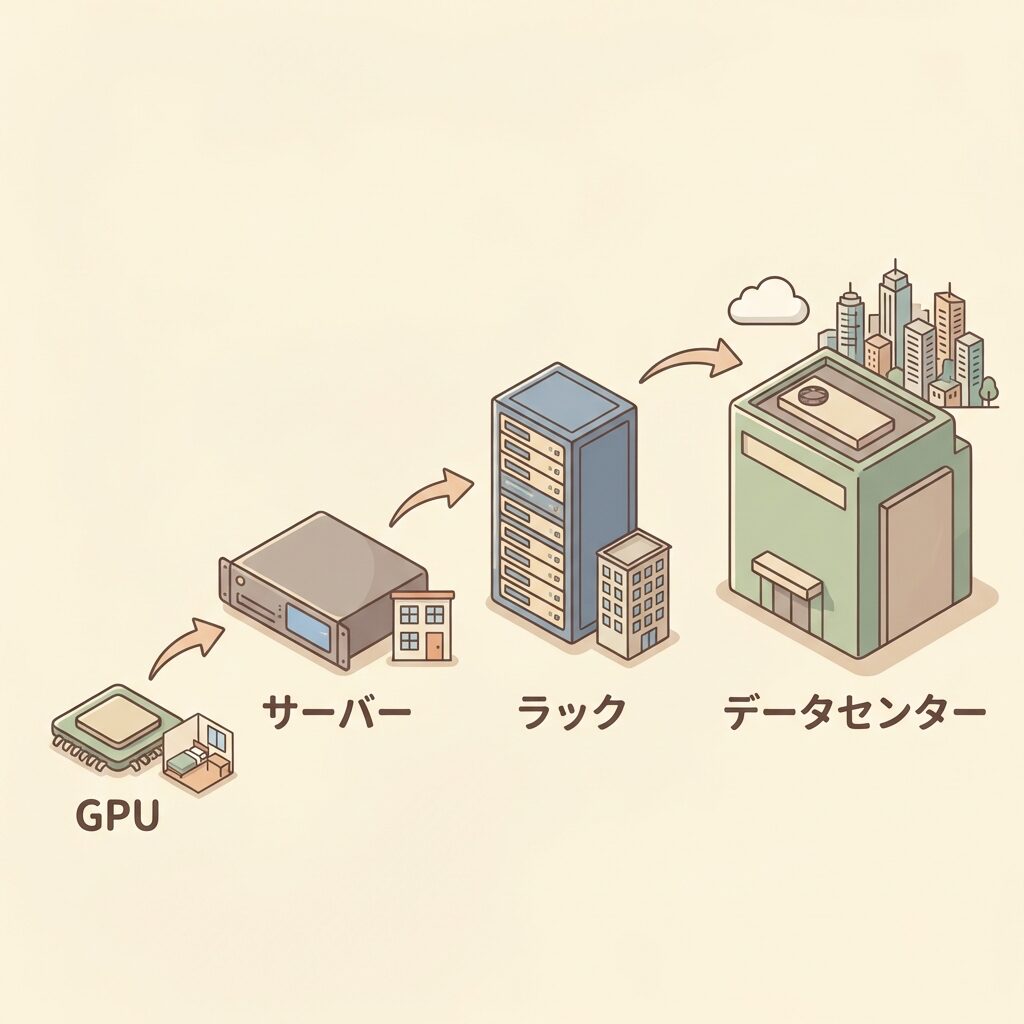
AIデータセンターの話を理解するうえで最も大切なのは、「サーバー1台」と「データセンター全体」の間にある入れ子構造を把握することです。マンションに例えるとわかりやすいでしょう。
GPUという「住人」がサーバーという「部屋」に入り、そのサーバーがラックという「1棟のマンション」に積み上げられ、ラックが何百本も並んだものがデータセンターという「団地全体」です。
ここで重要なのは、「住人」が変われば「部屋」も「マンション」も「団地」も設計し直す必要があるということ。従来のCPUという「おとなしい住人」から、GPUという「電気を大量に使い、猛烈に暖房を焚く住人」に入れ替わったことで、ラック=マンションの電力配線も、空調も、床の耐荷重も、すべてが足りなくなっているのです。
「1ラック」とは?──19インチ・U(ユー)・ラックあたりの電力の読み方
データセンターの記事には「1ラック」「42U」「ラックあたり○kW」といった言い方がよく出てきます。GPUラックの話に入る前に、ラックの数え方を押さえておきます。
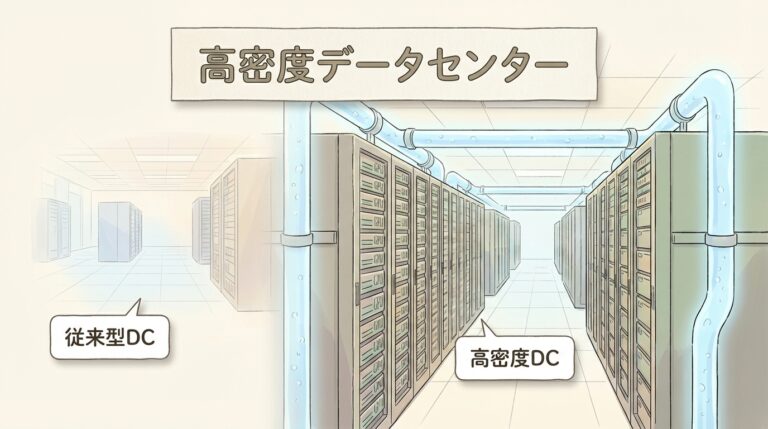
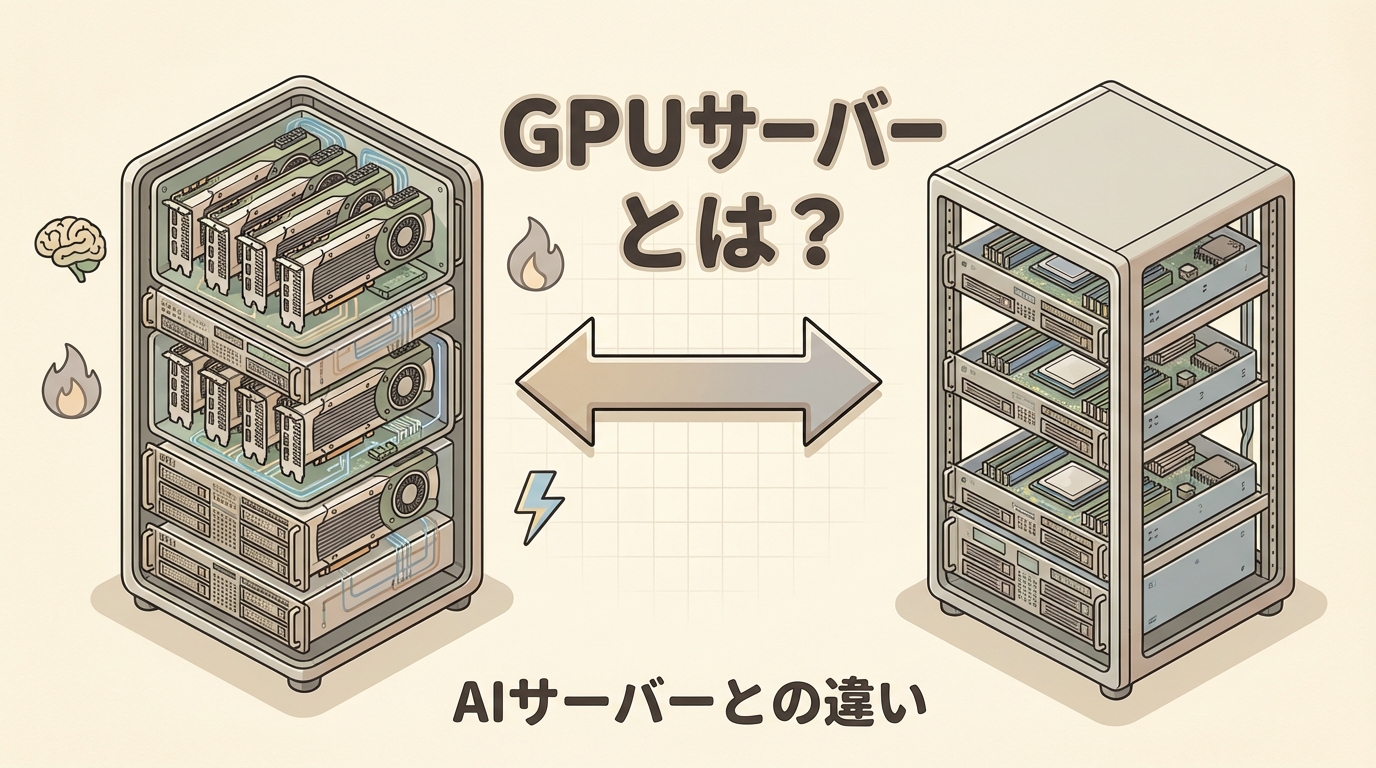
ラックの中に入るサーバーそのものはGPUサーバーとは、ラックを大量に並べたときの施設の違いは高密度データセンターとはで解説しています。
GPUラックとは?── 「桁違いの住人」を収めるための専用マンション
一言でいうと「GPUサーバー専用の高電力ラック」
GPUラックとは、GPUサーバーを複数台収容するために、電力供給・冷却・耐荷重をすべて強化した専用のサーバーラックのことです。
見た目は従来のサーバーラックと似た金属製のキャビネットですが、中身はまったくの別物です。先ほどのマンションの例えを使えば、従来のラックが「一般家庭向けマンション」だとすると、GPUラックは「工場用の産業設備を収めるための特殊ビル」です。電気の引き込み量も、空調も、床の強度も、ケーブルの本数も、すべてが桁違いになります。
この続きと一緒に読まれている記事
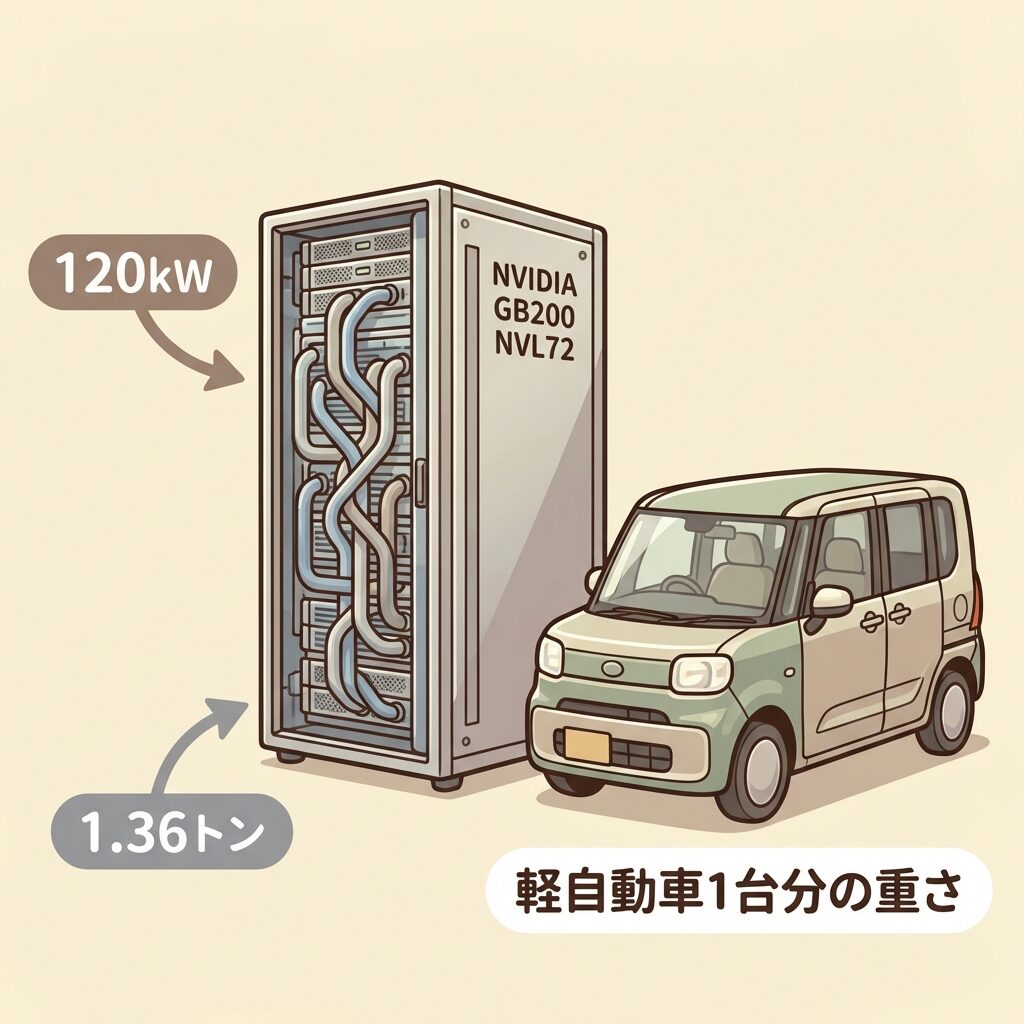
代表例:NVIDIA GB200 NVL72 ── 「軽自動車1台分のラック」
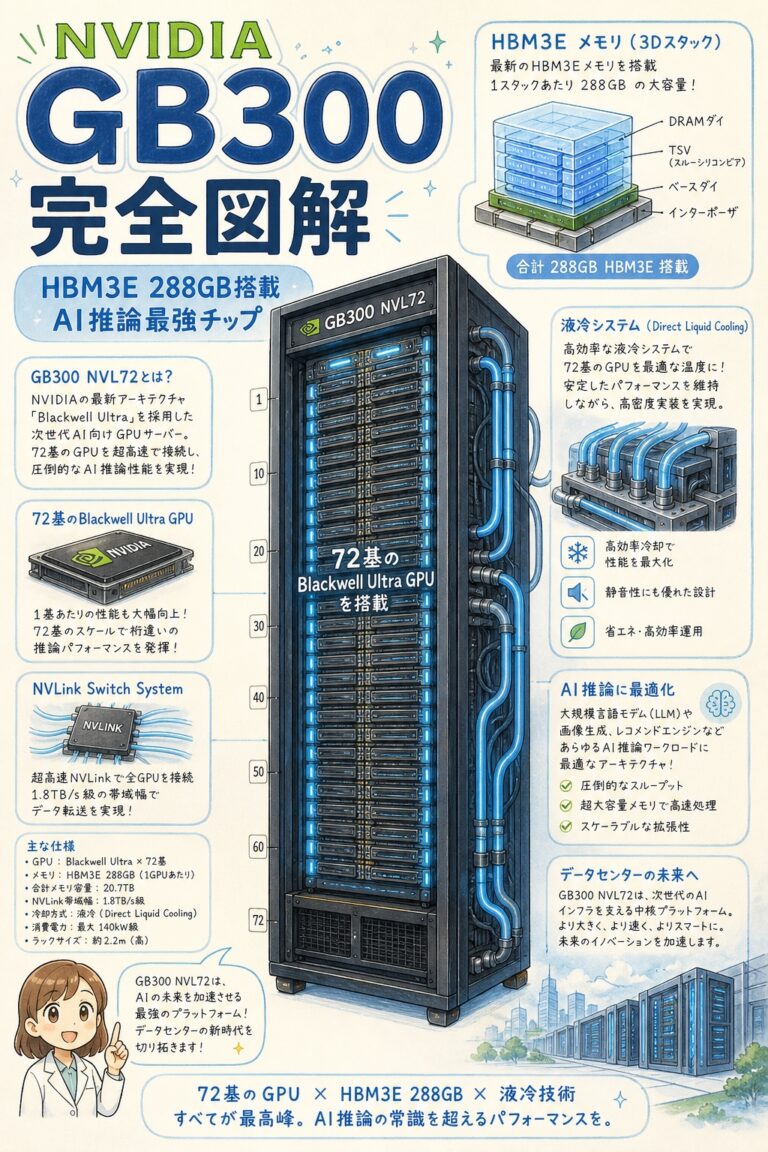
GPUラックの代表例が、NVIDIAのGB200 NVL72です。これは72基のBlackwell GPUと36基のGrace CPUを、1つのラックに液冷で詰め込んだシステムです。
このラックのスペックを見ると、GPUラックが「従来の延長線上」にないことが一目でわかります。
| 項目 | GB200 NVL72 のスペック |
|---|---|
| 搭載GPU数 | 72基(Blackwell GPU)+ 36基(Grace CPU) |
| 消費電力 | 約120kW(一般家庭 約40世帯分) |
| 重量 | 約1.36トン(軽自動車1台分に匹敵) |
| 冷却方式 | 完全液冷(空冷では対処不能) |
| 価格 | 約300万ドル(約4.5億円) |
出典:NVIDIA GB200 NVL72公式、FiberMall技術解説、Innovatopia
1本のラックで120kW、重さ1.36トン。これが数百〜数千本並ぶのがAIデータセンターです。「なぜデータセンターの設計が根本から変わるのか」──この数字を見れば、答えは明らかですよね。
GPUラックの中身──GB200 NVL72を開けると
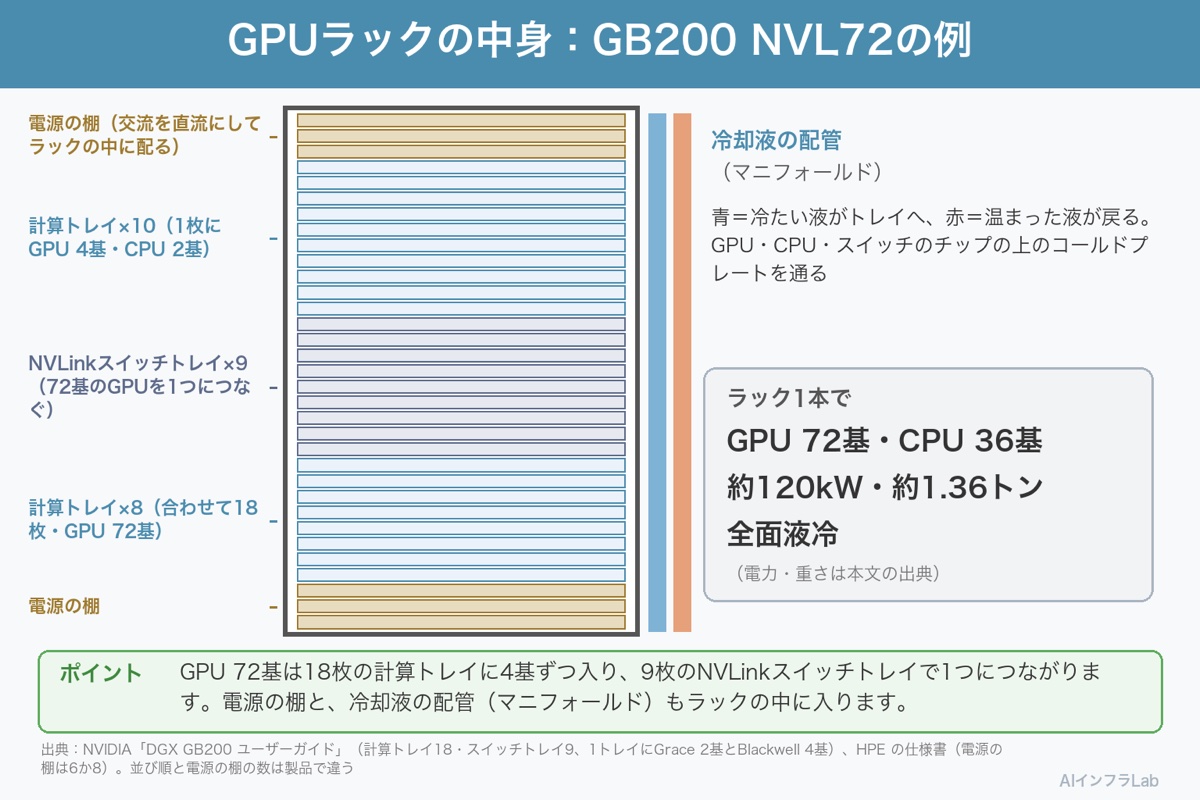
「ラック 中身」「サーバーラック 構造」と調べる方のために、代表例のGB200 NVL72の中を上から見ていきます。NVIDIAの資料では、ラックの中に計算トレイが18枚(1枚にGrace CPU 2基とBlackwell GPU 4基)、NVLinkスイッチトレイが9枚入り、72基のGPUを1つの大きなGPUのようにつなぎます。上と下には電源の棚があり、交流を直流にしてラックの中の配線(バスバー)に配ります。後ろには冷却液の配管(マニフォールド)が通り、各トレイのコールドプレートへ液を送ります。
従来ラックとGPUラックは何がどう違うのか?
6つの観点で一気に比較する
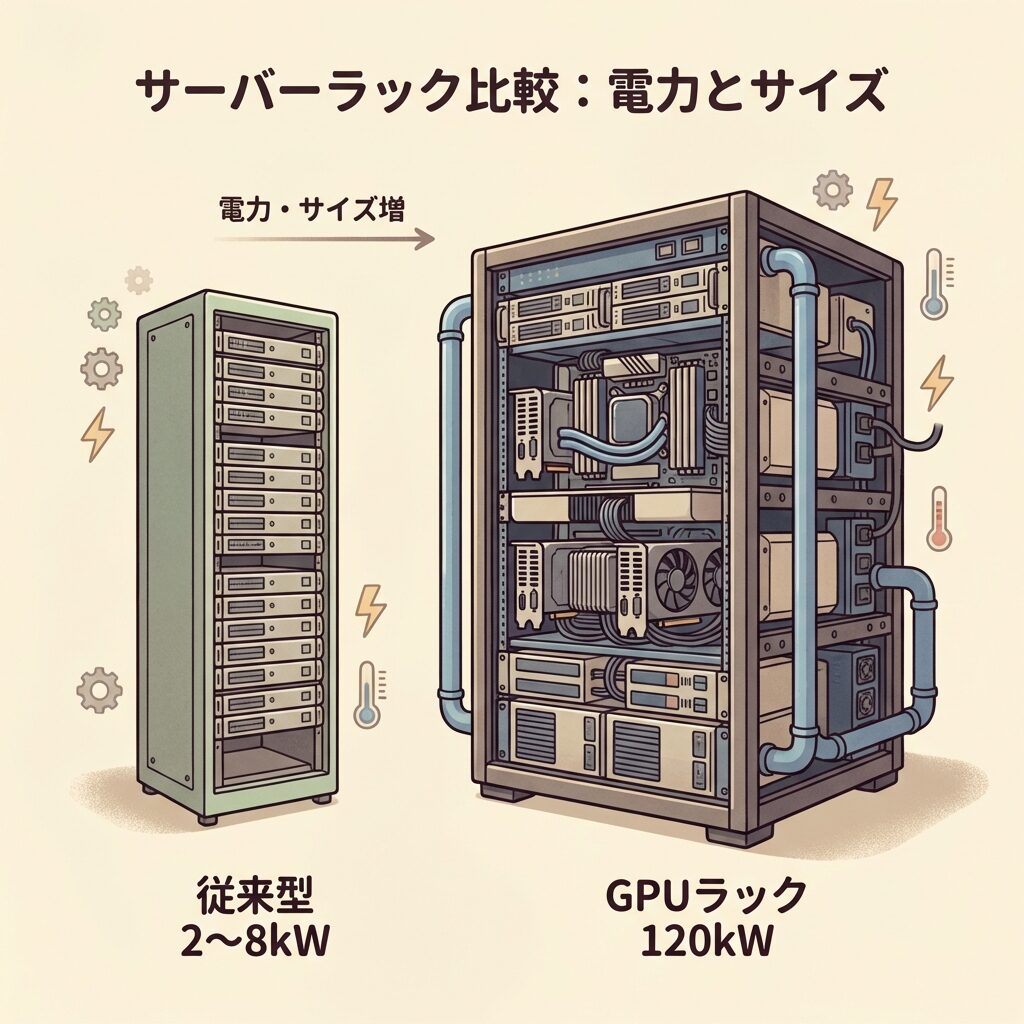
まず全体像をつかむために、従来型のCPUサーバーラックとGPUラックを6つの観点で比較しましょう。NTTPCコミュニケーションズの公開資料を基に、最新のGPUラックスペックを加えて整理しました。
出典:電力容量は NTTPCコミュニケーションズ、床耐荷重は Burrtec、ケーブル本数は Introlを参考に構成
身近なもので「差」をイメージする
数字だけだとピンとこないかもしれないので、身近なものに置き換えてみましょう。
同じ「サーバーラック」という名前がついていますが、中身のスケールがまったく違うことがおわかりいただけたと思います。これは「自転車とダンプカーの違い」に近い。どちらも「車輪がついた乗り物」ですが、走れる道も、止まれる場所も、必要な免許もすべて異なります。
「1ラックあたり電力容量」が意味すること
この数字がデータセンターの「格」を決める
データセンターの世界では、「1ラックあたりの電力容量(kVA / kW)」がその施設の能力を端的に表す指標です。この数字が、「どの世代のサーバーを何台載せられるか」を決めます。
NTTPCコミュニケーションズの解説によれば、一般的なデータセンターの電力容量は1ラックあたり2kVA〜8kVA程度です。一方、GPUサーバーの格納を想定するなら20kVA程度の電力供給が目安になるとしています(出典:NTTPCコミュニケーションズ)。
この「2〜8kVA」と「20kVA」の差を、もう少し噛み砕いて考えてみましょう。
電力密度の推移 ── ラック1本がどこまで「重く」なるか
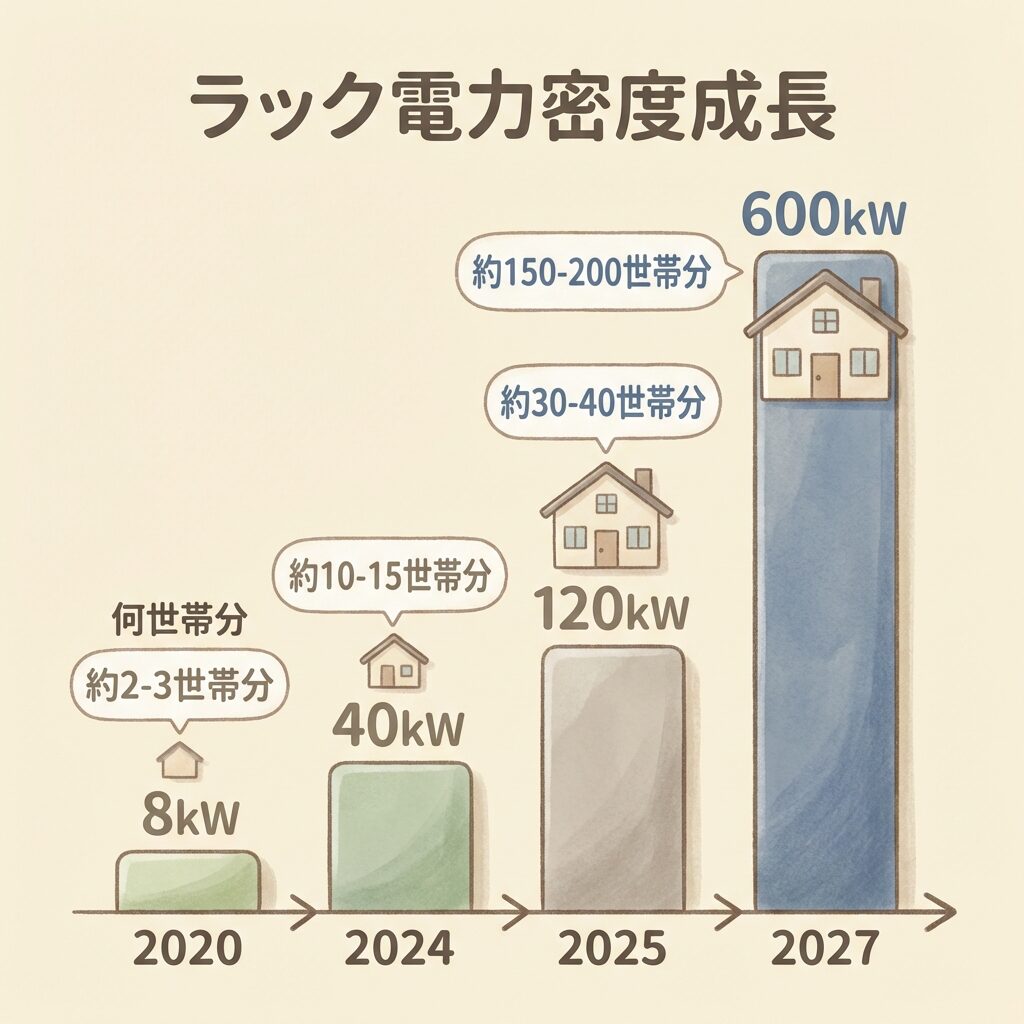
| 時期 | 代表的なGPU世代 | ラックあたり電力 | 身近な例え |
|---|---|---|---|
| 〜2020年 | 従来型CPU | 2〜8kW | エアコン1〜3台 |
| 2022〜2024年 | H100(空冷) | 20〜40kW | 一般家庭7〜13世帯分 |
| 2025年〜 | GB200(液冷) | 120kW | 一般家庭 40世帯分 |
| 2027年〜 | Rubin Ultra(予定・報道値) | 600kW | 一般家庭 200世帯分 |
出典:各世代の電力は 日経クロステック、NVIDIA公式を参考に構成
わずか数年で、ラック1本の電力消費が8kW → 120kW → 600kWと、2桁のオーダーで増加しています。この急激な変化こそが、「昔のデータセンターでは対応できない」最大の理由です。
GPUラックは何が「重くて」何が「熱い」のか?
重量の正体 ── GPU本体 + 液冷設備 + ケーブル
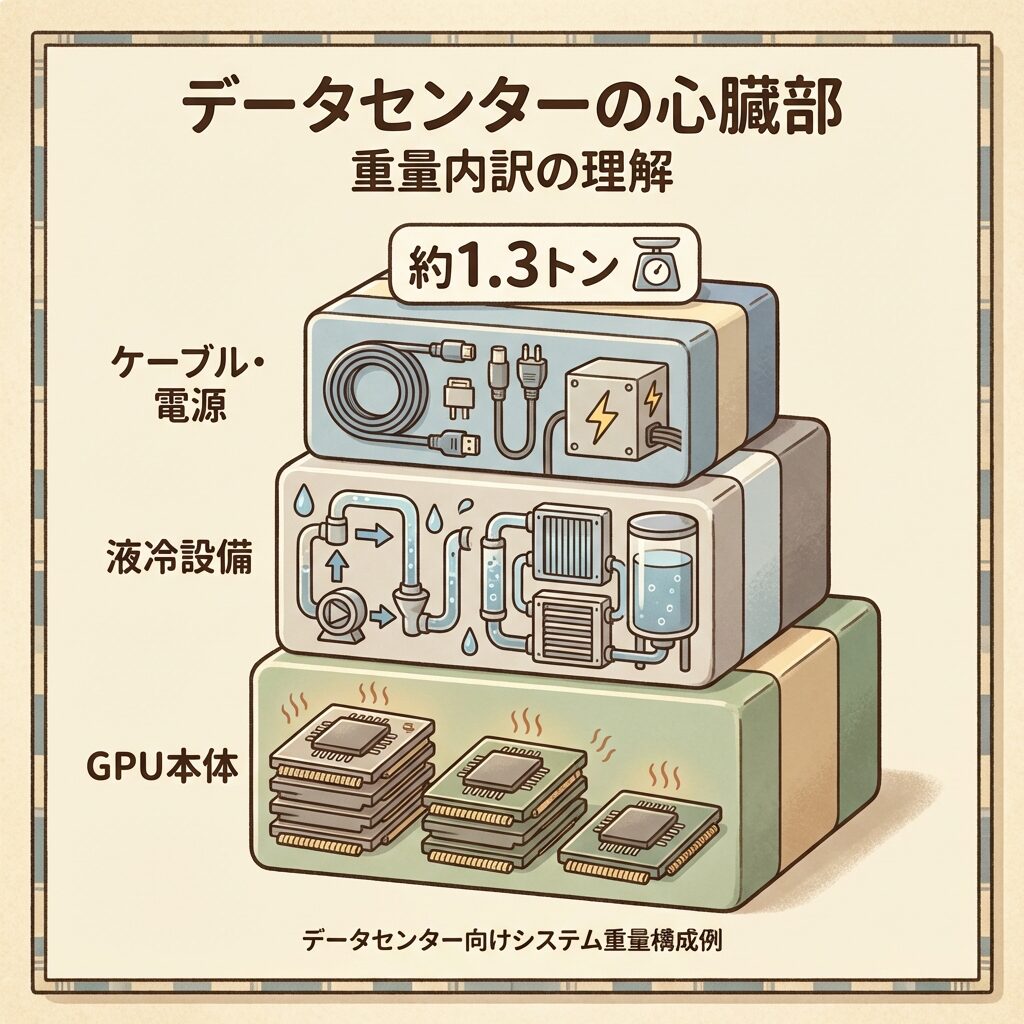
GPUラックの重量が約1.3トンに達する理由は、GPU本体だけでは説明できません。重量の内訳を理解すると、「なぜ液冷が必須になると重くなるのか」が見えてきます。
Introl社の技術レポートによれば、最新世代のGPU(1,200W級)は、チップ単体では約5kgですが、冷却用のコールドプレート・マニホールド・冷却液を加えるとGPU1基あたり約15kgになります。これにCPU、メモリ、電源ユニット、ケーブル類が加わり、8GPU搭載サーバー1台でフル装備100kg超に達します(出典:Introl)。
つまり、GPUラックが重い理由は「GPU自体が重い」だけでなく、冷却のための液冷設備と、電力供給のためのケーブルが大量に加わるからです。40GPUを搭載するラックには、電力・ネットワーク・管理用で200本以上のケーブルが必要になるという報告もあります(出典:Introl)。
発熱の正体 ── 消費電力のほぼすべてが熱になる
次に「熱」の問題です。GPUラックが猛烈に発熱する理由は、物理法則としてシンプルです。消費された電力の大部分は「熱」に変わります。
120kWのGPUラックがあるとしましょう。120kWの電力が計算に使われ、その大部分が熱エネルギーとして放出されます。これは電気ストーブ(1,000W)を120台、狭い部屋で同時にフル稼働させているのと同じ状態です。
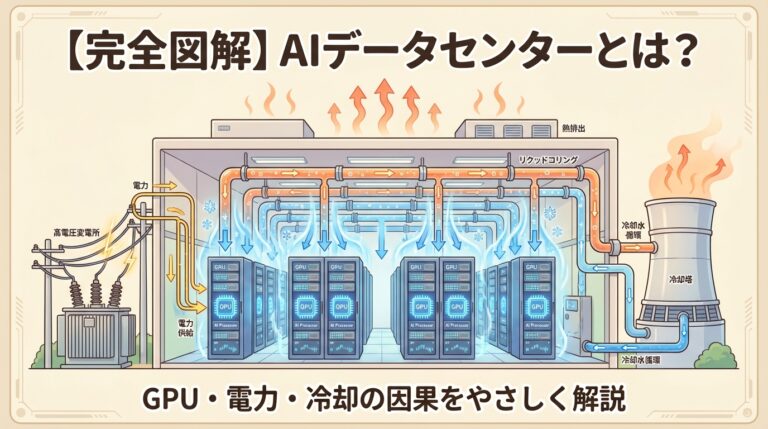
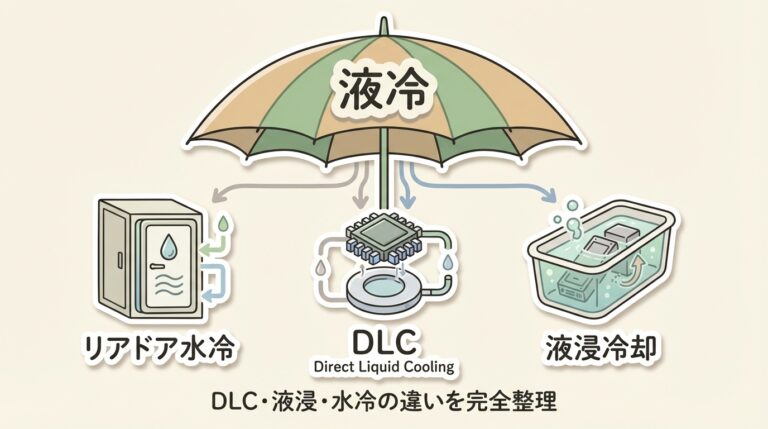
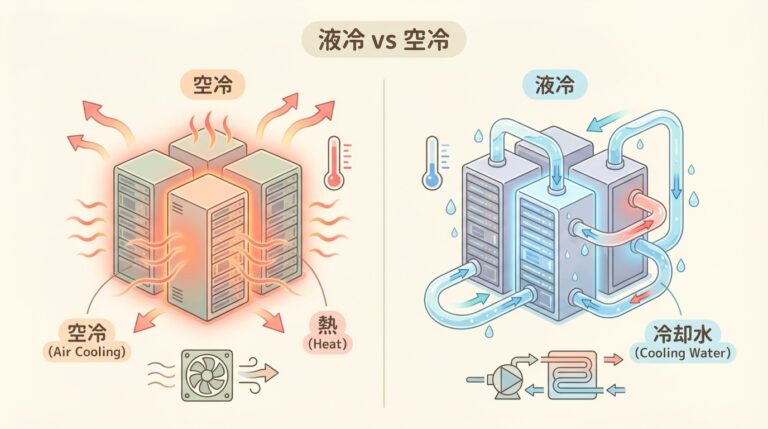
空冷(エアコン)で対応できるのはラックあたり20kW程度が限界とされています(出典:日経クロステック)。120kWのラックを空冷で冷やそうとすれば、それこそ台風のような風量が必要で、現実的ではありません。だからこそ、水や冷却液をパイプでGPUのすぐ近くまで通して直接熱を奪う「液冷」が不可欠になるのです。
なぜ昔のデータセンターではGPUラックに対応できないのか?
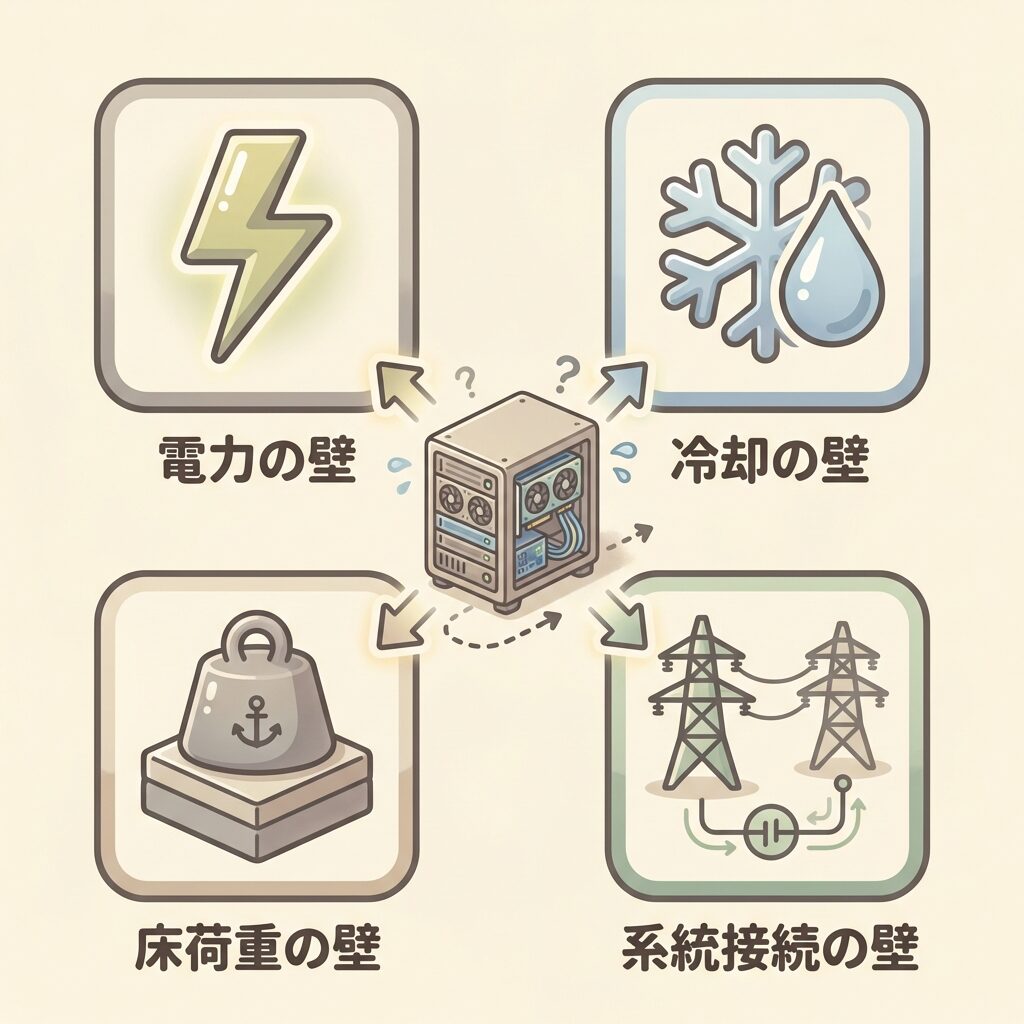
ここが、この記事で最も重要なセクションです。「GPUラックが重い・熱い・電気を食う」ことはわかった。では、なぜ既存のデータセンターを改修するだけでは対応できないのか。4つの壁を見ていきましょう。
壁①:電力設備の限界
従来のデータセンターは、1ラックあたり2〜8kVAの電力供給を前提に受変電設備が設計されています。ラックが100本あるフロアなら、設備全体で200〜800kVA程度の容量です。
ところが、GPUラックを100本並べると、必要な電力は12,000kW(12MW)。これは従来の15〜60倍です。ブレーカーの容量、電力ケーブルの太さ、変圧器の容量、すべてが足りません。「コンセントを増やす」レベルの話ではなく、建物に引き込む電力インフラそのものを作り替える必要があります。
壁②:冷却システムの限界
従来のデータセンターの冷却は「空冷」──つまり、床下から冷たい空気を送り込み、ラック前面から吸気して背面から排気する方式です。日本の既存データセンターの9割以上がこの方式です。
しかし空冷で対応できるのはラックあたり約20kWが上限です。GPUラックの50〜120kWは、空冷の能力を完全に超えています。液冷に移行するには、冷却液を循環させる配管設備、サーバールームの防水処理、冷却液分配ユニット(CDU)の設置など、建物構造を根本から変える改修が必要です。
壁③:床耐荷重の限界
一般のオフィスビルの床耐荷重は300〜500kg/㎡程度です。従来型データセンターでも500〜700kg/㎡程度に設計されています(出典:クラウドWatch)。
ところが、GPUラックは1本で1.3トン超。液冷設備の重量も加わるため、AIデータセンターには1,000〜2,000kg/㎡の床耐荷重が求められます(出典:Burrtec)。既存の建物では床が文字通り「耐えられない」のです。
壁④:系統接続(送電網との接続)の限界
数百MW〜GW級の電力を必要とするAIデータセンターは、既存の送電網では電力を十分に引き込めないケースが増えています。日本では特に東京圏(千葉県印西市など)で系統接続の制約が深刻で、新規の電力接続に最長10年以上かかるケースも報告されています。
GPUラックの高密度化に関わる日本企業
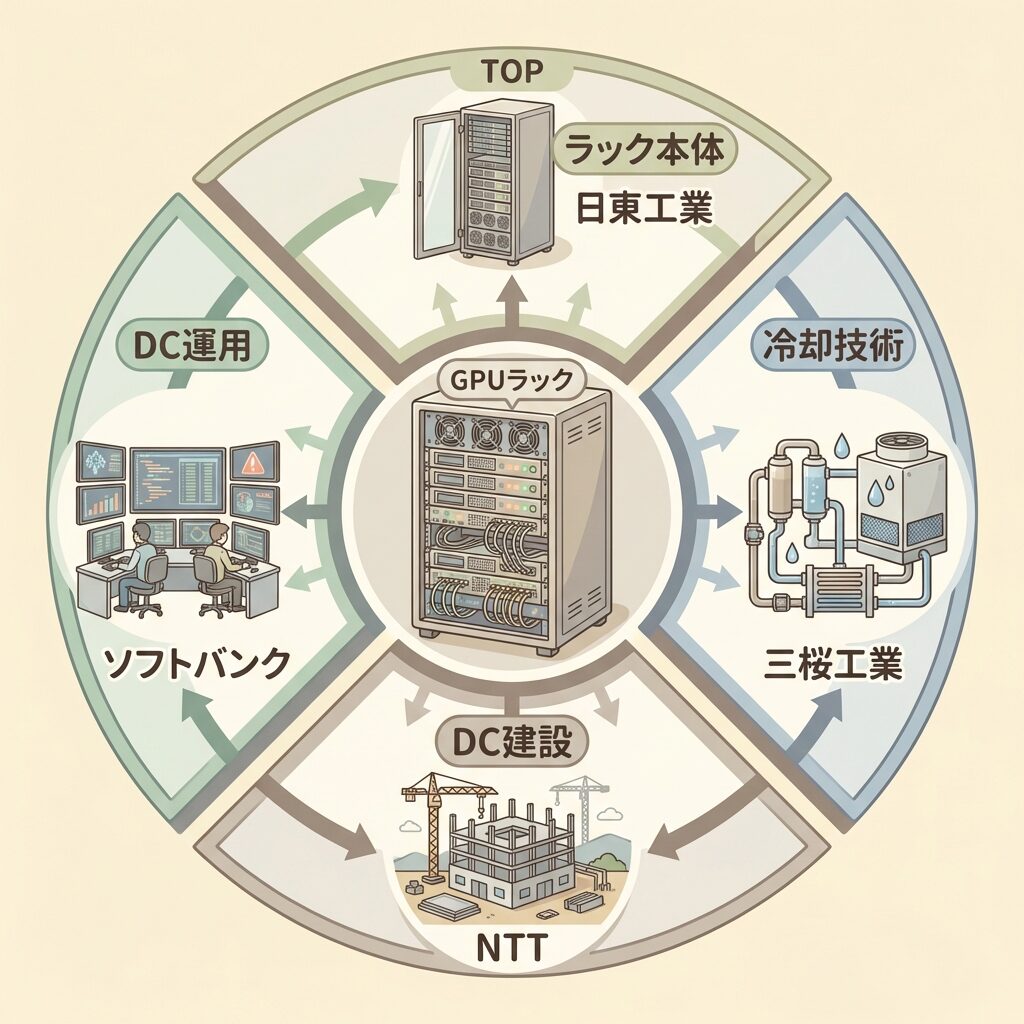
GPUラックの話はNVIDIAなど海外企業の名前ばかり出てきますが、実は日本企業もこの変化の当事者です。投資家・学生それぞれの視点で知っておくべき企業を、役割ごとに整理しました。
ラック本体 ── 日東工業・河村電器産業・摂津金属工業
GPUラックの「箱」そのものを作っている日本メーカーが存在します。
日東工業(東証プライム・6651)は、データセンター向けシステムラックの国内大手です。高密度GPUサーバーの搭載に対応したFSシリーズや、ハイパースケールデータセンター向けの52U対応FDシリーズを展開しています(出典:日東工業公式)。さらに、OCP(Open Compute Project)準拠のオープンラックも個別対応で提供しており、DC給電・高効率化の最新トレンドに対応しています。
河村電器産業は、免震データセンター向けのデータセンターラック E-Classシリーズを展開しています(出典:河村電器産業)。また、摂津金属工業はサーバーラック業界でのシェアが高く、データセンター向けラック製造の老舗として知られています。
冷却技術 ── NEC・NTTグループ・三桜工業・カンネツ
GPUラックの高密度化に伴い、液冷技術の需要が急拡大しています。
NECは、神奈川・神戸・印西のデータセンターで水冷対応サーバーの受け入れを開始しています(出典:クラウドWatch)。NTTグループは、NTTコミュニケーションズが海外で170MW規模の液冷データセンターを展開するなど、グループ全体で液冷への転換を本格化させています。NTTPCコミュニケーションズはNVIDIA認定エリートパートナーとして、20kVA対応の高電力ラック提供とGPU運用環境のトータル設計を行っています。
液冷設備のメーカーとしては、三桜工業(東証プライム・6584)が自動車向け配管技術をデータセンター冷却に応用し注目を集めています。カンネツはサーバー冷却装置の専門メーカーとして業界で高いシェアを持っています。
データセンター建設・運用 ── NTTファシリティーズ・ソフトバンク・SCSK
NTTファシリティーズは、データセンターの設計・建設・運用を手がける国内大手で、電力設備設計から冷却設計まで一貫した技術力を持ちます。ソフトバンクは北海道苫小牧に大規模AIデータセンターの建設を進めており(2026年度の開業が目標)、これとは別に2025年12月にGB200 NVL72を載せたAI計算基盤を動かし始めました(出典:ソフトバンク)。SCSKはGPUサーバーやHPCに最適な高負荷ハウジングサービスを提供しています。
よくある誤解を整理する
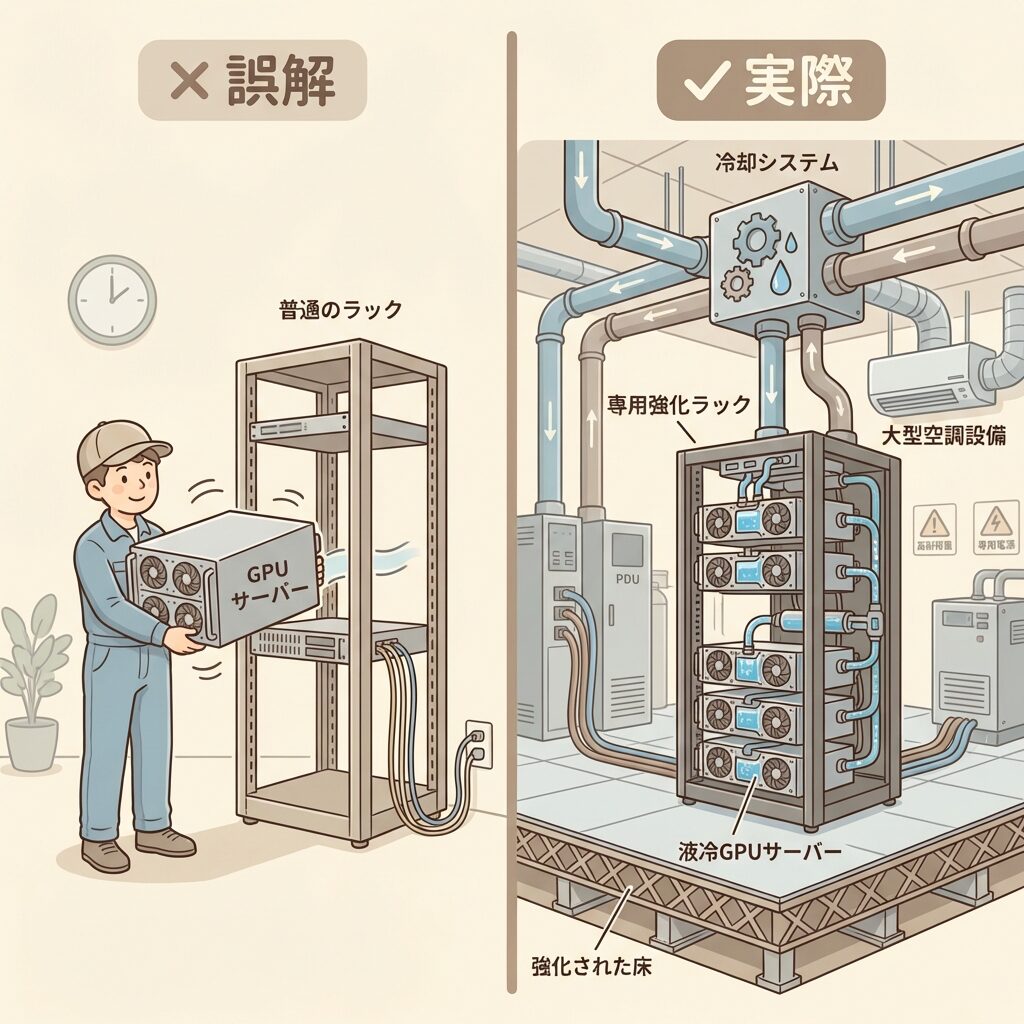
誤解と 実際
| よくある誤解 | 実際はこう |
|---|---|
| 「GPUラックは普通のラックにGPUサーバーを入れただけ」 | 電力容量・冷却方式・耐荷重・ケーブル設計まですべて専用設計。従来ラックにGPUサーバーを入れても性能は発揮できず、最悪の場合ラック自体が壊れる。 |
| 「既存のデータセンターを改修すればGPUラックを置ける」 | 電力設備・冷却・床耐荷重・系統接続の4つすべてが足りないため、改修より新築の方が合理的なケースが多い。 |
| 「GPUラックが重いのはGPU本体が重いから」 | 重量の大部分は液冷設備(コールドプレート、配管、冷却液)とケーブル類。GPU本体は全体重量の一部に過ぎない。 |
| 「電力の問題はGPUの省電力化で解決する」 | GPU1基あたりの電力効率は改善しているが、ラック全体の電力密度は世代ごとに急増している(120kW→600kW→1MW超)。処理性能の向上が消費電力の削減を上回っている。 |
| 「データセンターの問題はソフトウェアで解決する」 | GPUラックの高密度化が引き起こす課題は、電力・冷却・床荷重・建設・送電網というきわめて物理的な問題。ソフトウェアだけでは解決しない。 |
まとめ:GPUラックの全体像
結局こういうことです。AIの進化を「支えている」のは、ラック1本1本の物理的な設計です。GPUの性能がどれほど上がっても、それを収める箱の電力・冷却・耐荷重が追いつかなければ、AIは動かない。GPUラックの高密度化こそが、AIデータセンターのすべての課題の出発点なのです。
高密度化の代表例が、NVIDIAの最新のGPUを詰め込んだラックです。そのGPUの1つ、GB300の中身は次の記事で図解しています。
よくある質問(FAQ)
学習ロードマップ上の位置づけ
GPUラックが置かれるデータセンターの全体を、1冊で知りたい方に。本書(幻冬舎メディアコンサルティング)は、日米で20年以上の実績を持つデータセンターコンサルタントが、建物・IT機器・運用システムといったデータセンターの構造から、抱える課題と未来像までを解説した入門書です。


次に読むべき記事
ここまでで「GPUラック」の全体像がつかめました。次は、つながりの深い記事で理解を一歩ずつ広げていきましょう。
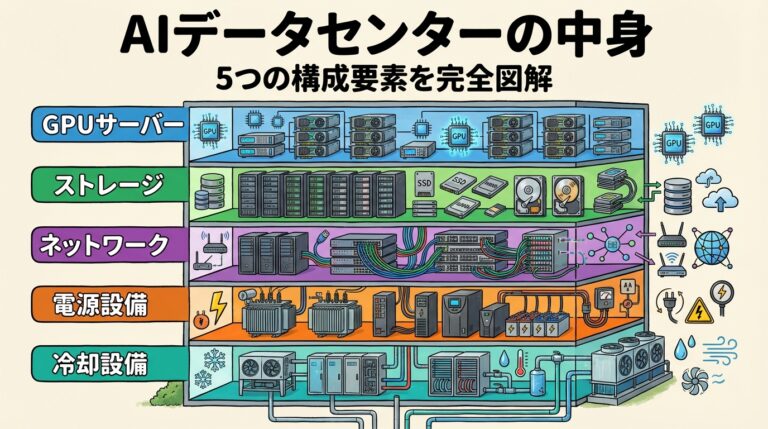
テーマ別に、もっと深く学ぶ
気になるところから読んでも大丈夫です。どの記事も、はじめての方にもわかるように図解で書いています。

コメント