こんな疑問、ありませんか?
- 「GB200 NVL72」「NVL72」の「NVL」と「72」が何を意味するのか、実はよく分かっていない
- NVLinkとInfiniBand、どちらも「GPUをつなぐ」と聞くけれど、何が違うのか説明できない
- ふつうのPCにもGPUはつながっているのに、なぜAI用だけ専用の配線が必要なのか不思議
- 「NVIDIAの強さはGPU単体ではない」と聞くけれど、ではどこが強いのかを言葉にできない
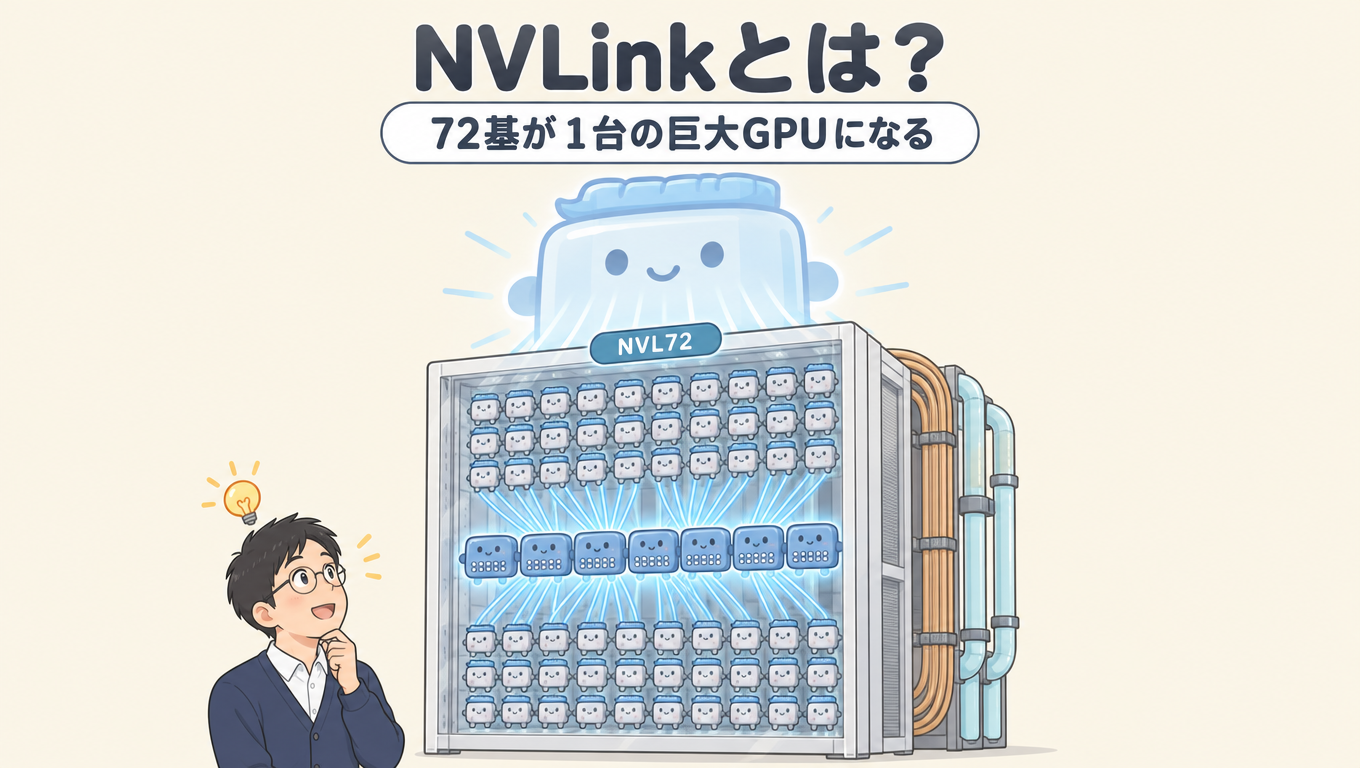
答えのカギはNVLink(エヌブイリンク)とNVSwitch(エヌブイスイッチ)です。
この2つがあるおかげで、72個のGPUが「1台の巨大なGPU」のようにふるまえます。
この記事では、PCIeとの差を実際の数字で比べながら、「なぜ72なのか」までを1から整理します。
こんにちは。前回の記事では、ラックとラックをつなぐ「外の道路」(InfiniBand・Ethernet)を扱いました。今回はその内側、ラックの中でGPU同士を結ぶ「中の廊下」の話です。この廊下がとても太いことが、今のAIデータセンターの形を決めています。
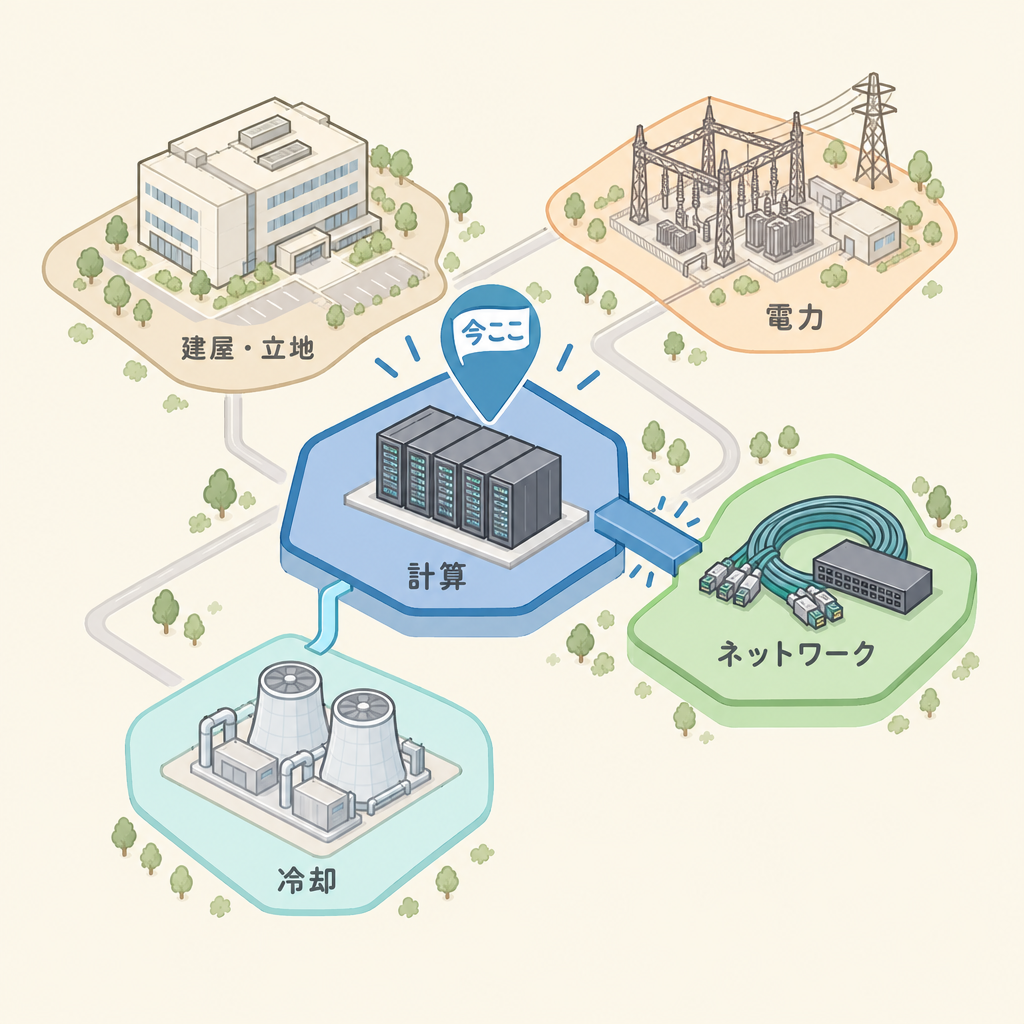
あなたが今いる場所:AIインフラ > AIデータセンター入門 > NVLink・NVSwitch(スケールアップ)
▼ AIデータセンターの5つの構成要素
建屋・立地
電力
冷却
計算(GPUサーバー) ←ココ
ネットワーク
▼ DCができるまで(ライフサイクル)
立地・用地確保
電力確保(系統接続)
設計・建設
設備・IT機器搭載 ←ココ
運用・サービス提供
ひとことメモ:NVLinkは「計算」と「ネットワーク」の境目にある技術です。そして後半で見るとおり、冷却(液冷)とラックの電力の事情が「72」という数字を決めています。1つの技術が、DCの3つの要素にまたがっているわけです。
先に結論:この記事の答え
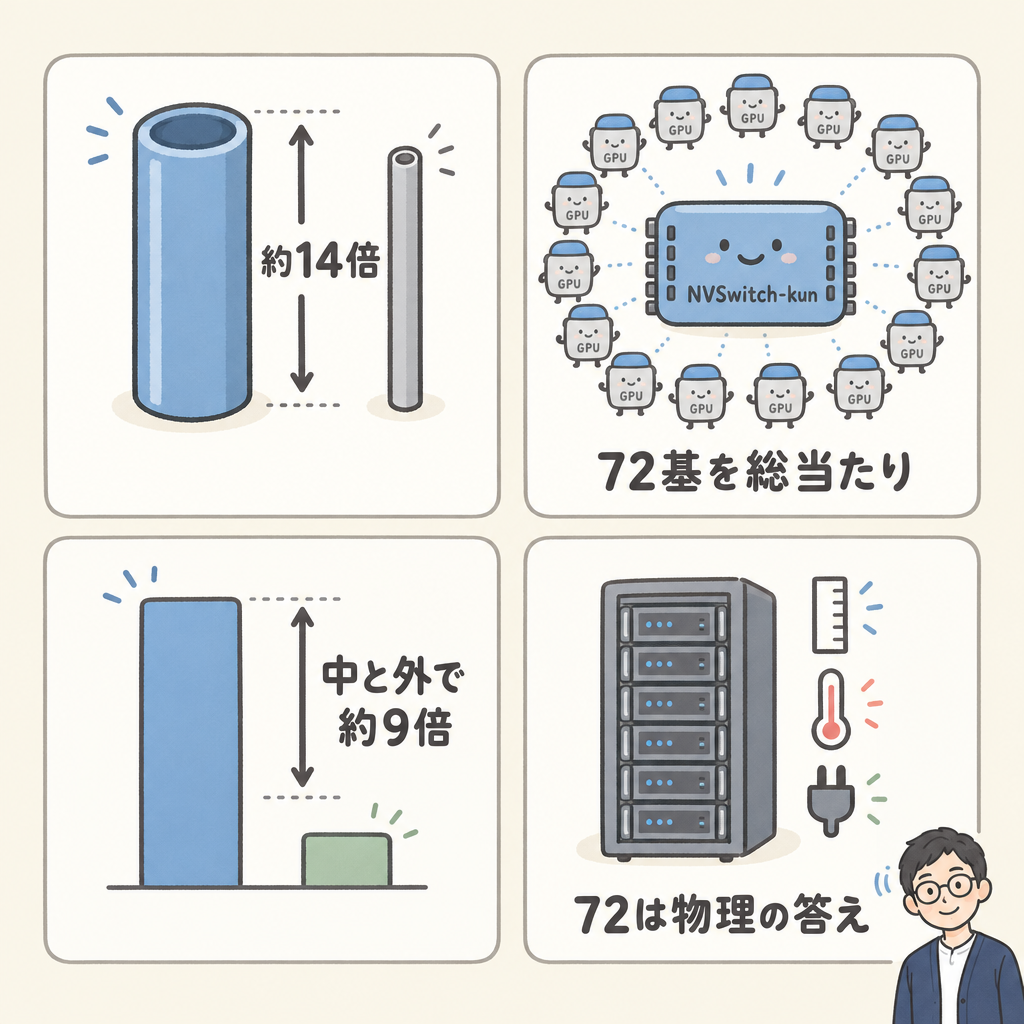
① NVLinkは、NVIDIA(NVDA)独自のGPU同士の専用配線です。Blackwell世代ではGPU1基あたり1.8TB/s(双方向)で、一般的な接続規格PCIe 5.0(x16)の約14倍の太さがあります。
② NVSwitchは、NVLinkを束ねる「交差点」の役割を持つチップです。GB200/GB300 NVL72では18個のNVSwitchが72基のGPUを総当たりでつなぎ、互いのメモリ(HBM)を自分のメモリのように読み書きできるようにします。
③ スケールアップは「1つのまとまりを大きくする」こと、スケールアウトは「まとまりの数を増やす」ことです。ラック内のNVLinkと、ラック外のInfiniBand/Ethernetとでは、GPU1基あたりの帯域に約9倍の差があります。
④ 「72」は偶然の数字ではありません。銅線が届く距離、1ラックに引ける電力(約120kW級)、液冷で冷やせる限界という3つの物理的な制約がちょうど釣り合う点が、NVL72という単位になりました。
PCIeとNVLinkの違いを「実際の数字」で比べる
ふつうのPCやサーバーでは、GPUはPCIe(ピーシーアイ・エクスプレス)という汎用の差し込み口でつながっています。グラフィックボードを挿すあのスロットです。まずは、その太さとNVLinkを並べてみましょう。
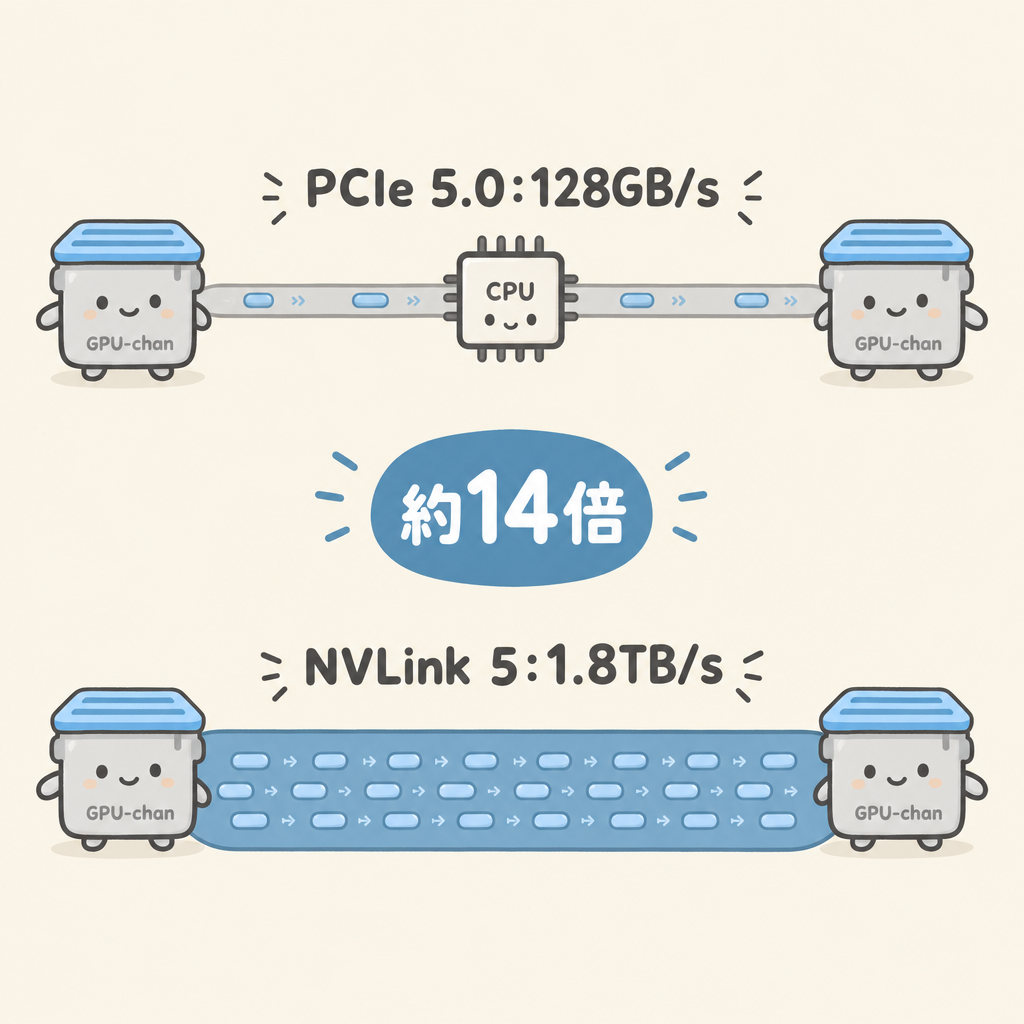
128GB/s
PCIe 5.0 x16(双方向)
出典:PCI-SIG規格値
1.8TB/s
NVLink 5(Blackwell)GPU1基あたり
出典:NVIDIA公表値
約14倍
NVLink 5 ÷ PCIe 5.0 x16
1,800 ÷ 128 ≒ 14
| 接続方式 |
GPU1基あたり帯域(双方向) |
PCIe 5.0比 |
主な搭載GPU |
| PCIe 5.0 x16 | 128GB/s | 1倍 | 一般サーバー |
| PCIe 6.0 x16 | 256GB/s | 2倍 | 次世代サーバー |
| NVLink 4 | 900GB/s | 約7倍 | H100/H200 |
| NVLink 5 | 1.8TB/s | 約14倍 | B200/GB200/GB300 |
| NVLink 6 | 3.6TB/s | 約28倍 | Rubin(Vera Rubin NVL72) |
※帯域は送信・受信の合計(双方向)で比較しています。PCIeは規格上の理論値、NVLinkはNVIDIA公表値です。
用語ミニ解説
帯域(バンド幅):1秒間に運べるデータの量。「道路の車線数」のようなものです。
GB/s・TB/s:1秒あたりのギガバイト・テラバイト。1TB/sは、2時間の映画(約5GB)を
1秒で約200本送れる速さです。
PCIe:CPUとGPU・SSDなどをつなぐ汎用の接続規格。どのメーカーの部品でも使えるのが強みです。
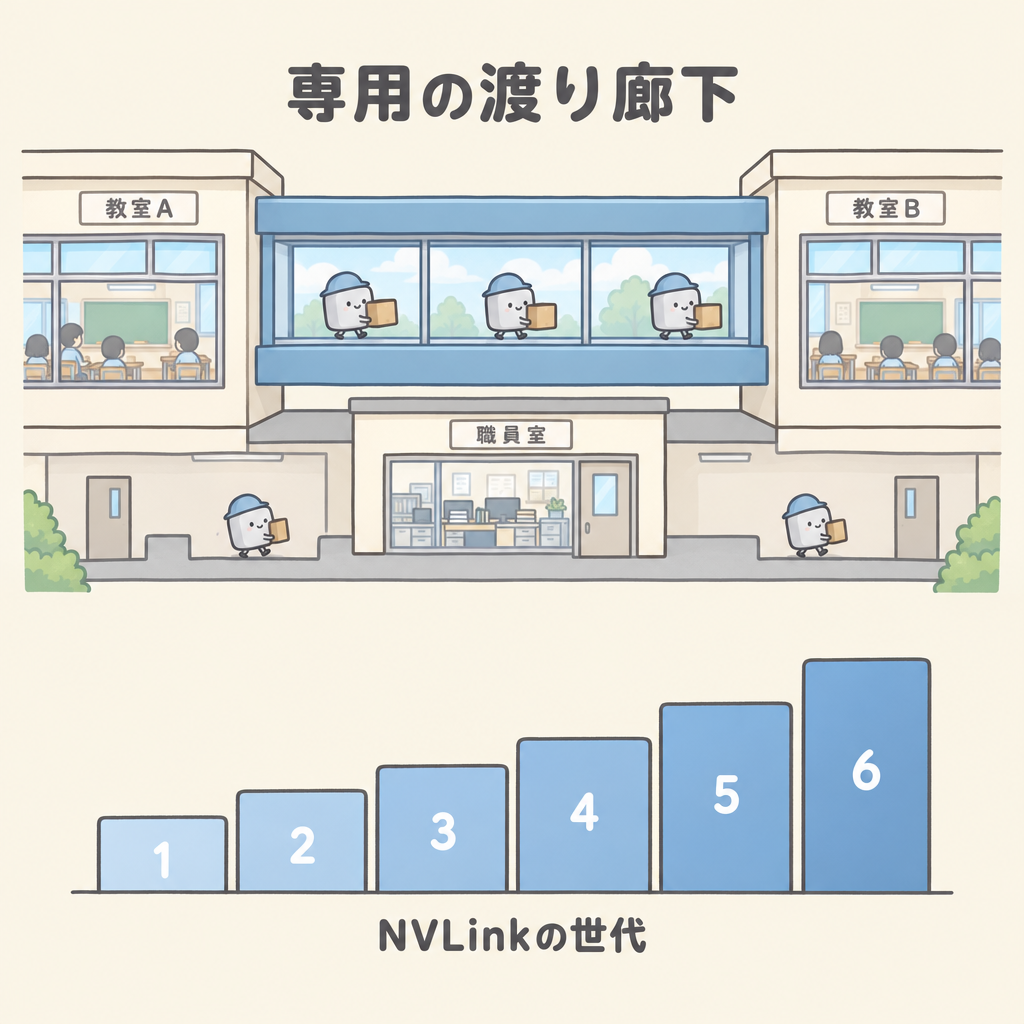
たとえ話:職員室を通る連絡 vs 教室同士の渡り廊下
PCIeでGPU同士が話すのは、隣のクラスに用事があるたびに
職員室(CPU側)を経由して連絡するようなものです。廊下も細いので、ほかのクラスの連絡と重なるとすぐ混みます。
NVLinkは、
教室と教室を直接つなぐ、幅の広い専用の渡り廊下です。職員室を通らずに、大量の荷物をまとめて運べます。
NVLinkはどう太くなってきたか(GPU1基あたり・双方向)
NVLink 1
2016年・P100
160GB/s
NVLink 2
2017年・V100
300GB/s
NVLink 3
2020年・A100
600GB/s
NVLink 4
2022年・H100
900GB/s
NVLink 5
2024年〜・Blackwell
1.8TB/s
NVLink 6
2026年〜・Rubin
3.6TB/s
※NVIDIA公表値にもとづく目安。年は対応GPUの発表・出荷開始時期の目安です。
10年で20倍以上太くなりました。ただし本当の変化は、太さよりも「何台を1つにつなげるか」のほうにあります。そこで主役になるのが、次に紹介するNVSwitchです。
NVSwitchとは?72基のGPUを「総当たり」でつなぐ交差点
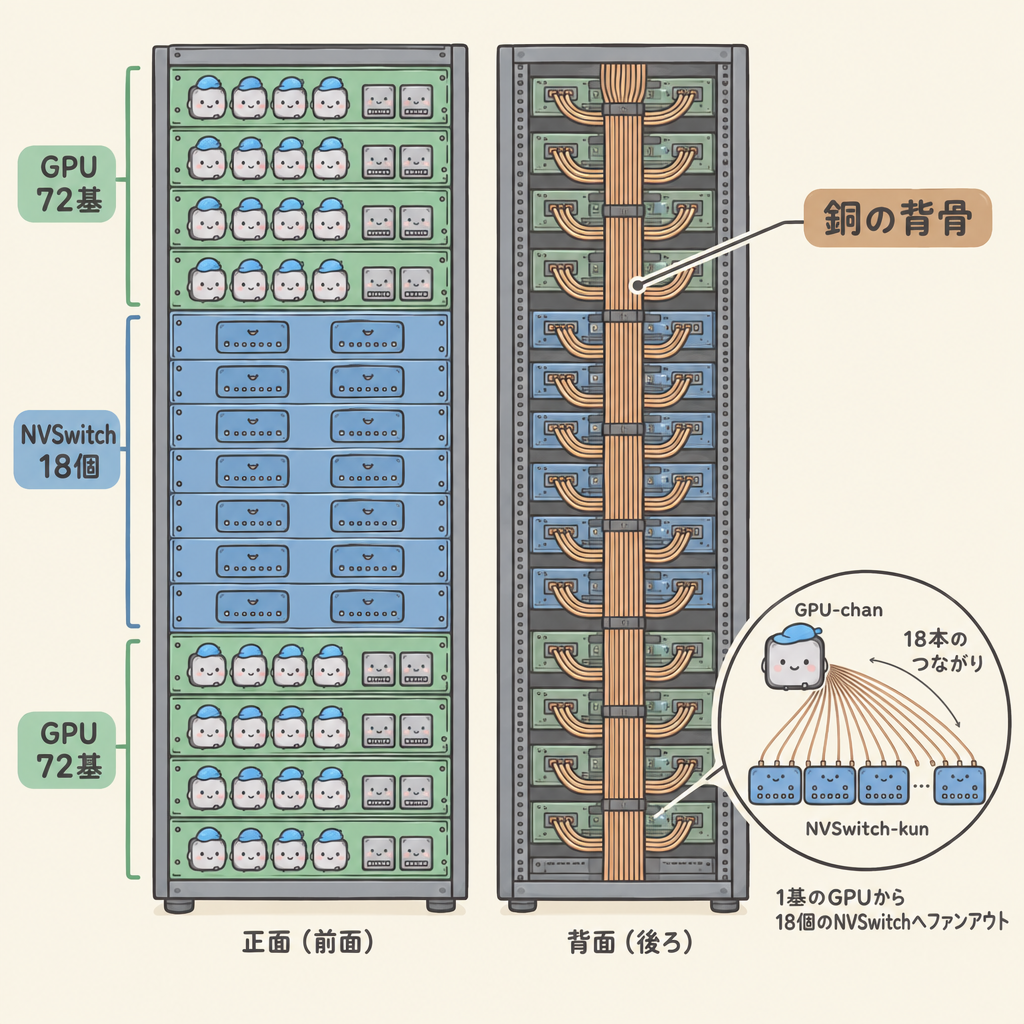
NVLinkは「線」です。GPUが増えると、全員を線で直接つなぐのは現実的ではありません。72基を全部つなぐと、72×71÷2=2,556本もの組み合わせになります。そこでNVIDIAは、線を中継する専用のスイッチチップ(NVSwitch)を用意しました。
GB200 NVL72ラックの中身(模式図)
コンピュートトレイ × 18台
1トレイ=GPU 4基+Grace CPU 2基
合計:GPU 72基・CPU 36基
⇄
銅線の
背骨
NVLinkスイッチトレイ × 9台
1トレイ=NVSwitchチップ 2個
合計:NVSwitch 18個
つなぎ方のルール:各GPUは18本のNVLinkを持ち、18個のNVSwitchそれぞれに1本ずつつながっています。そのため、どのGPUからどのGPUへも「GPU → NVSwitch → GPU」の1回の中継で届きます。
背面には5,000本を超える銅ケーブルの「背骨(NVLinkスパイン)」があり、ラック全体で合計130TB/sの通信ができます(GB200世代・NVIDIA公表値)。
用語ミニ解説
トレイ:ラックに引き出しのように差し込む薄い箱。
コンピュートトレイには計算用のGPU・CPUが、
スイッチトレイには交差点となるNVSwitchが入っています。
NVLinkドメイン:NVLinkで直接つながったGPUのまとまりのこと。H100世代の標準的なサーバー(HGX)では
8基、NVL72では
72基です。
72基のGPUを「1つのメモリ空間」に見せるとはどういうことか
NVLinkのすごさは、太さだけではありません。NVLinkドメインの中では、GPUが隣のGPUのメモリ(HBM)に、自分のメモリと同じ感覚で「読む・書く」の命令を直接出せます。ネットワーク越しに「送ってください」と頼んで待つのではなく、手を伸ばして取るイメージです。
ネットワーク越し(スケールアウト)
「GPU②さん、そのデータを送ってください」→ NICが荷造り → ケーブル → 相手のNICが荷ほどき → 受け取り完了。
手紙のやりとりに近く、1回ごとに手続きがかかります。
NVLink越し(スケールアップ)
「GPU②のメモリの◯番地を読む」と命令するだけ。NVSwitchが瞬時に中継します。
同じ机の上の書類を取る感覚で、手続きがほとんどいりません。
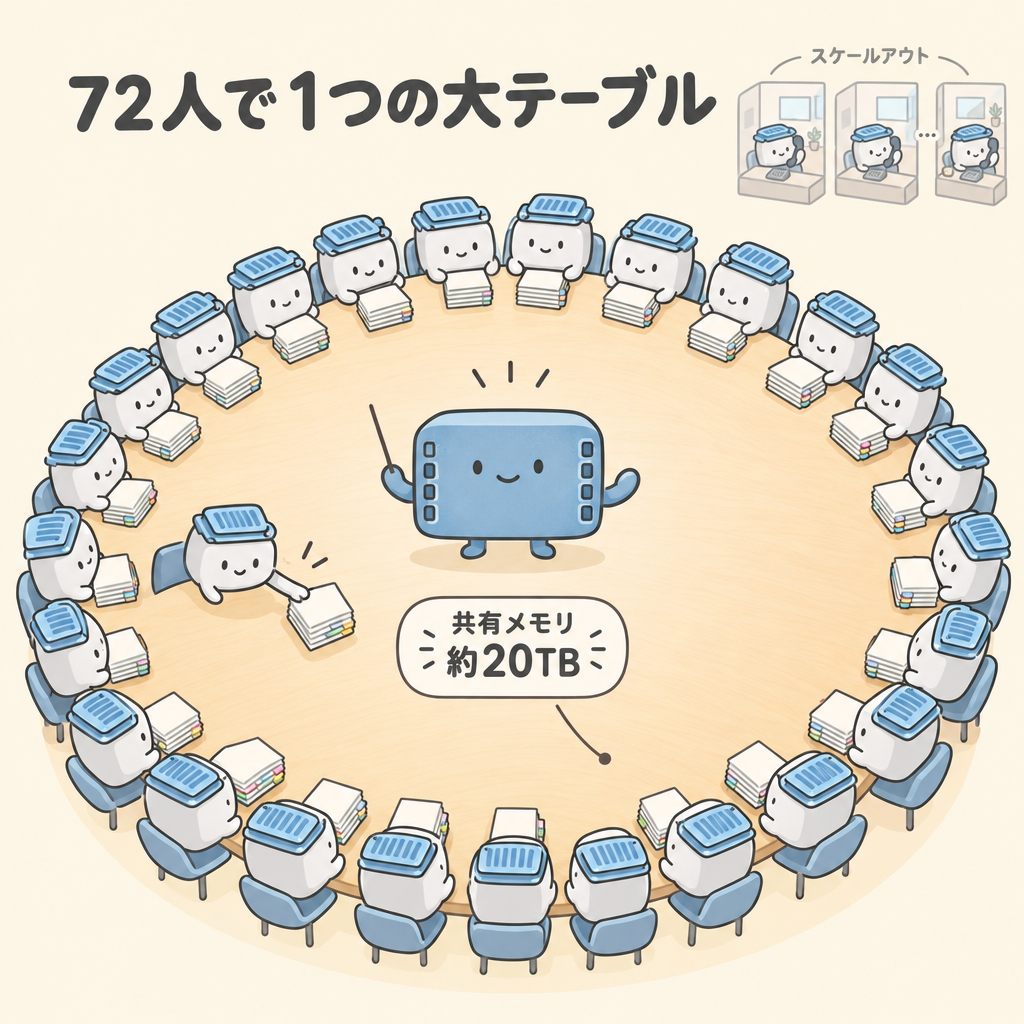
288GB
GB300のGPU1基あたりHBM3E容量
出典:NVIDIA公表値
約20TB
NVL72全体で「共有できる」HBM
288GB × 72基 ≒ 20.7TB
たとえ話:72人が囲む1つの大テーブル
スケールアウトは、
72人がそれぞれ別の部屋で作業し、必要な資料を内線電話で頼んで届けてもらう職場です。
NVL72は、
72人が1つの大きなテーブルを囲んでいる状態です。どの資料も手を伸ばせば届くので、テーブル全体が「1人の超人の机」のように働きます。巨大なAIモデルを
1つのGPUに入り切らないまま動かせるのは、この大テーブルがあるからです。
GPUの隣にあるメモリ(HBM)そのものの仕組みは、HBMとは?GPUの隣にある「AI最重要メモリ」で詳しく解説しています。
スケールアップとスケールアウトの違い
ここで、前回のInfiniBand記事と今回のNVLinkを1枚の表にまとめます。「ラックの中か、外か」で役割がはっきり分かれています。
| 比較項目 |
スケールアップ |
スケールアウト |
| ひとことで | 1つのまとまりを大きくする | まとまりの数を増やす |
| 範囲 | ラックの中(NVL72なら72基) | ラックとラックの間(数千〜数十万基) |
| 代表技術 | NVLink+NVSwitch | InfiniBand・Ethernet(RoCE) |
| GPU1基あたり帯域 | 1.8TB/s(双方向) | 800Gb/s NIC = 100GB/s(片方向)≒ 200GB/s(双方向) |
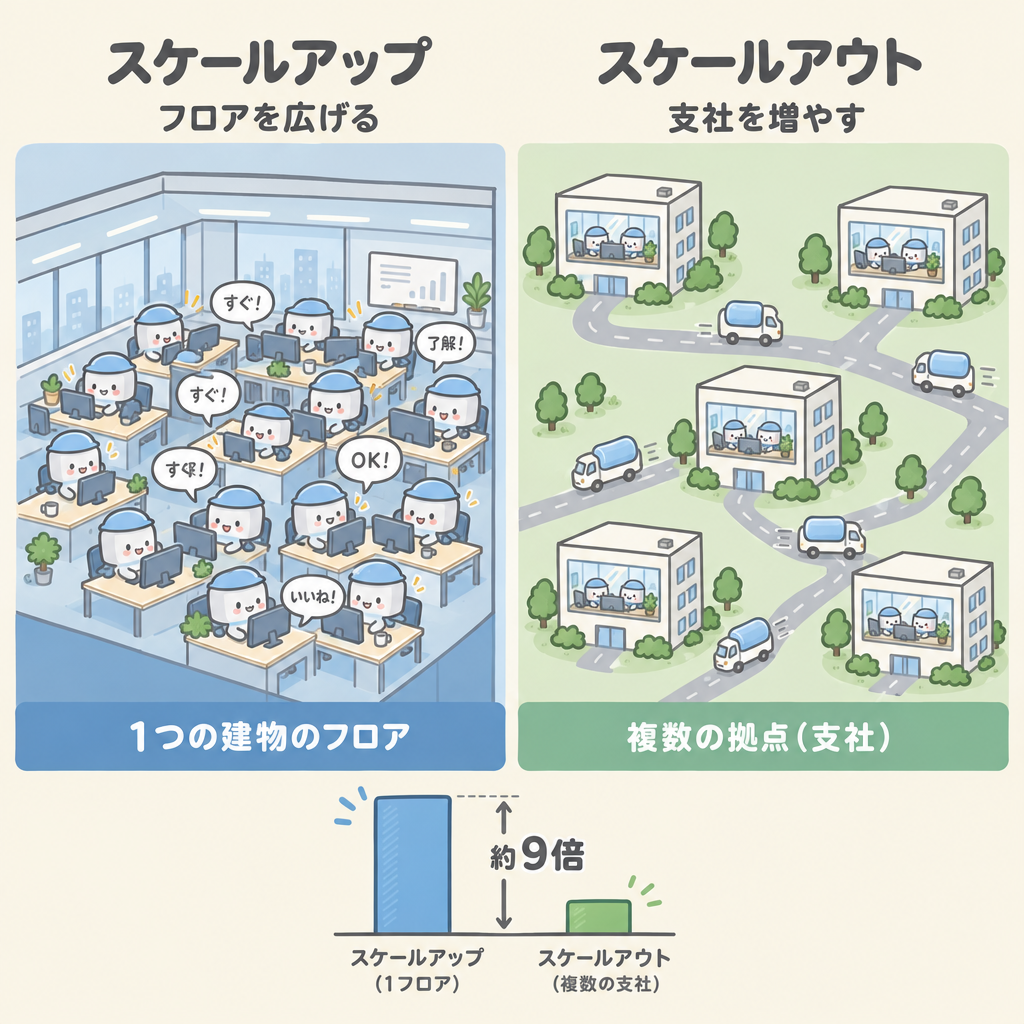
| 帯域の差 | 1,800 ÷ 200 = 約9倍(Blackwell世代の目安) |
| メモリの扱い | 互いのHBMを直接読み書き(1つのメモリ空間のように) | RDMAで「送る・受け取る」 |
| 配線 | 主に銅線(数メートル以内) | 主に光ファイバー(数十m〜km) |
| 広げられる規模 | 物理的な制約で上限あり | 建物と電力があればほぼ無制限 |
※Gb/s(ギガビット)とGB/s(ギガバイト)は8倍違います(1バイト=8ビット)。800Gb/s ÷ 8 = 100GB/sです。数値は構成・世代により異なる目安です。
たとえ話:ビルを高くするか、ビルを増やすか
スケールアップは、1つの会社の
フロアを広げることです。全員が同じフロアにいるので相談は一瞬ですが、フロアの広さには建物の限界があります。
スケールアウトは、
支社を増やすことです。いくらでも増やせますが、支社同士のやりとりには時間がかかります。
分岐点:「どの通信を、どちらの道に流すか」
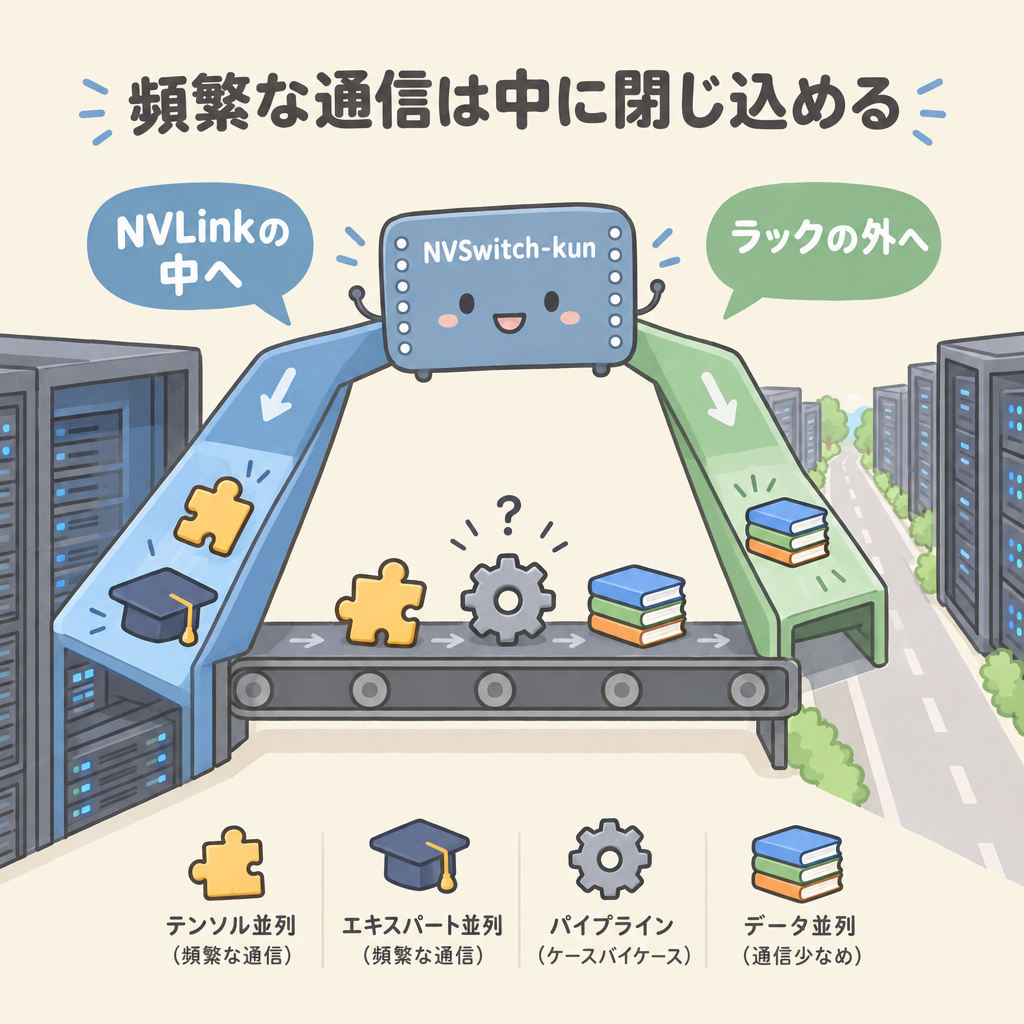
AIの学習では、巨大なモデルを複数の分け方で同時に分割します。ポイントは、分け方によって通信の「頻度」と「待てる時間」が大きく違うことです。そこで、頻度の高い通信は太いNVLinkの中に閉じ込め、頻度の低い通信だけを外に出します。
テンソル並列(1つの層を分割)
1つの行列計算を複数のGPUで分担します。層ごとに何度も結果を合わせる必要があり、少しの遅れも許されません。
NVLinkの中へ
エキスパート並列(MoEモデル)
「専門家」ごとに担当GPUを分け、入力ごとに全員が全員へデータを送り合います(All-to-All)。推論でも通信が多くなります。
NVLinkの中へ
パイプライン並列(層ごとに分担)
工場のライン作業のように、層のまとまりを順番に受け渡します。受け渡しは比較的少なめです。
構成次第
データ並列(同じモデルを複製)
データを分けて学習し、1ステップに1回All-Reduceで結果をまとめます。量は多いものの、頻度は低めです。
ラックの外へ
ここが分岐点:NVLinkドメインが大きいほど、
「頻繁で待てない通信」を中に閉じ込められる範囲が広がります。8基なら8基分しか閉じ込められませんが、72基なら9倍の規模まで広げられます。これが、NVIDIAがドメインを大きくし続ける理由です。
外に出たデータ並列のAll-Reduceで、なぜ「ばらつき」が致命的になるのかは、
InfiniBandとEthernetの違いで詳しく解説しています。
MoE(Mixture of Experts):モデルの中に多数の「専門家」を用意し、入力に応じて一部だけを働かせる設計です。計算を減らせる代わりに、GPU同士の通信が増えます。最近の大規模モデルで広く使われています。
なぜ「NVL72」という単位が生まれたのか
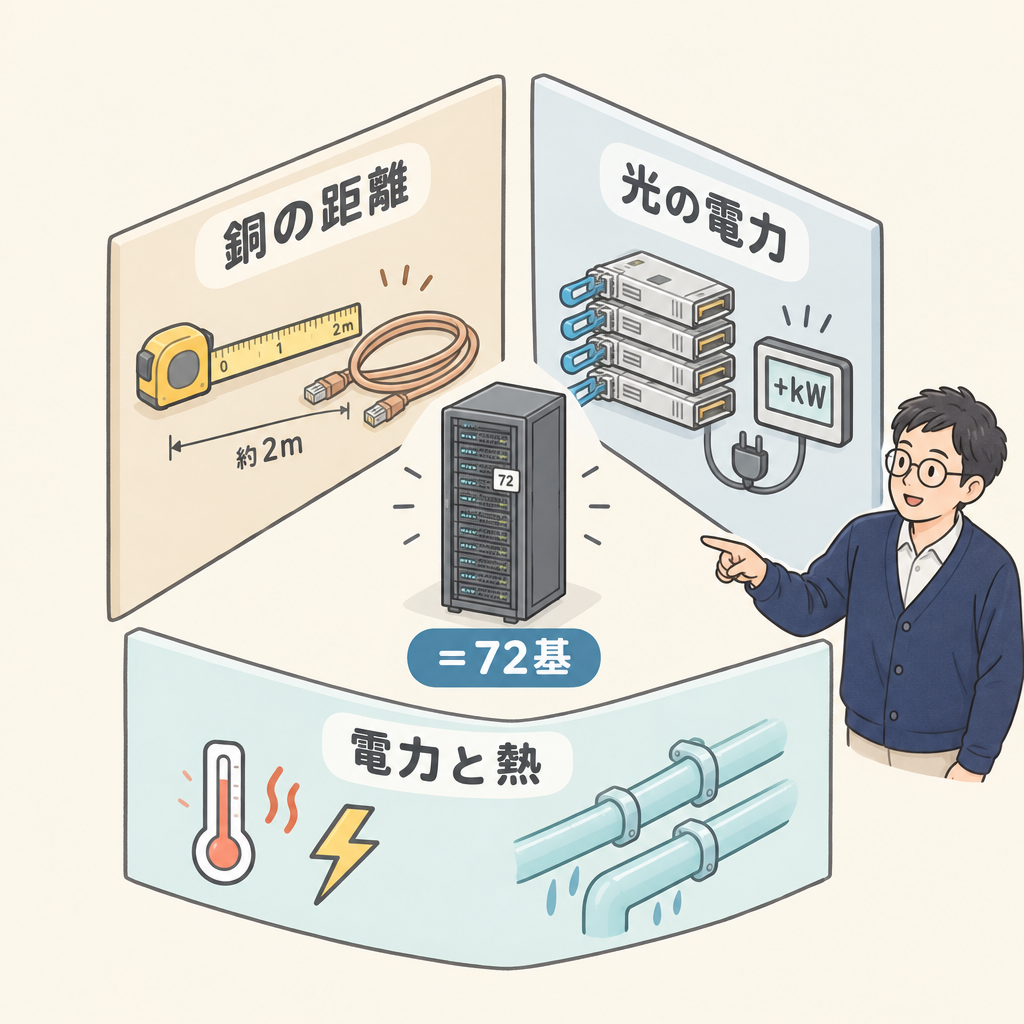
「大きいほど良い」なら、なぜ1,000基や1万基をNVLinkでつながないのでしょうか。答えは、3つの物理的な壁がちょうど「1ラック・72基」あたりで重なるからです。
壁①:銅線が届く距離
超高速信号を銅線で送れるのは、せいぜい1〜2m程度です。それ以上離れると光ファイバーが必要になります。つまり「銅でつなげる範囲=ほぼ1ラック」です。
壁②:光にすると電力が増える
光でつなぐには、電気と光を変換する光トランシーバーが大量に必要です。NVIDIAは、NVL72の背骨を光にすると約20kW余分に電力がかかると説明しています(2024年GTC基調講演)。そこで銅で済ませました。
壁③:電力と熱の上限
GPUを1ラックに詰めるほど、電力と熱が集中します。NVL72は1ラック約120kW級で、液冷が前提です。これは従来DCのラック(数kW〜10kW台)の10倍以上にあたります。
銅が届く範囲 = 約1ラック
光を避けたい(電力+20kWを回避)
1ラックで扱える電力・熱 = 約120kW級(液冷)
= ちょうど釣り合う点が「GPU 72基」
ひとことメモ:120kWは、一般家庭の平均的な使用電力(1世帯あたり約0.4kW、年間約3,500kWhから換算)で割ると
約300世帯分です。
冷蔵庫ほどの大きさの箱1つが、小さな町内会まるごとの電気を使っていることになります。ラックの物理的な収容の話は
GPUラックとは?、液冷の要件は
NVIDIAのBlackwellと液冷で解説しています。
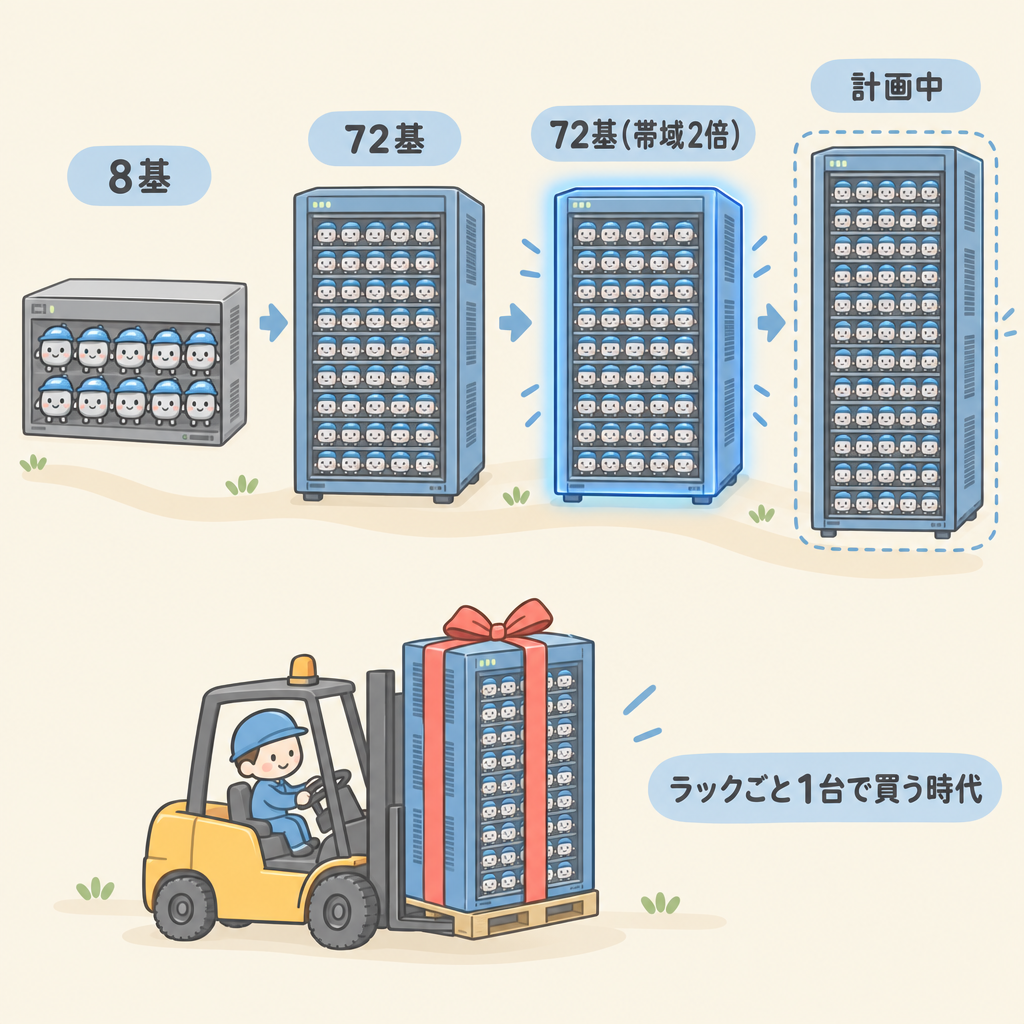
NVLinkでつながるGPU数はどう増えてきたか
H100世代
8基
1サーバー(HGX)
空冷が中心
GB200 / GB300
72基
1ラック(NVL72)
液冷が前提 ←現在地
Vera Rubin
72基
NVLink 6で帯域2倍
合計260TB/s
Rubin Ultra(計画)
576ダイ級
新ラック「Kyber」
数百kW級
※NVIDIA公表値・ロードマップにもとづく目安。Rubin Ultraは2027年予定の計画値で、変更される可能性があります。
「72」の数え方に注意:Rubin世代では当初「NVL144」という名前が発表されましたが、のちにGPUのパッケージ数で数える「Vera Rubin NVL72」に呼び方がそろえられました。1パッケージに2つのGPUダイ(チップ本体)が入っているため、ダイで数えると144になります。名前の数字が何を数えているかは、ニュースを読むときに必ず確認しましょう。
従来DC vs AI DC:「サーバー単位」から「ラック単位」へ
| 比較項目 |
従来DC |
AI DC(NVL72時代) |
何が変わった |
| 買う単位 | サーバー1台ずつ | ラック丸ごと1台 | 「ラックが1台の計算機」 |
| ラックの役割 | サーバーを置く棚 | 配線・電源・冷却が一体の製品 | 棚から「機械」へ |
| GPU同士の結合 | PCIe・ネットワーク経由 | NVLinkで72基が直結 | 約14倍の太さ |
| 重さ | 数百kg | 約1.4トン級(報道値) | 床の耐荷重も設計対象に |
| 故障の影響 | 1台止まっても他は動く | 1部品の不調がラック全体に響く | 検査・保守がより重要に |
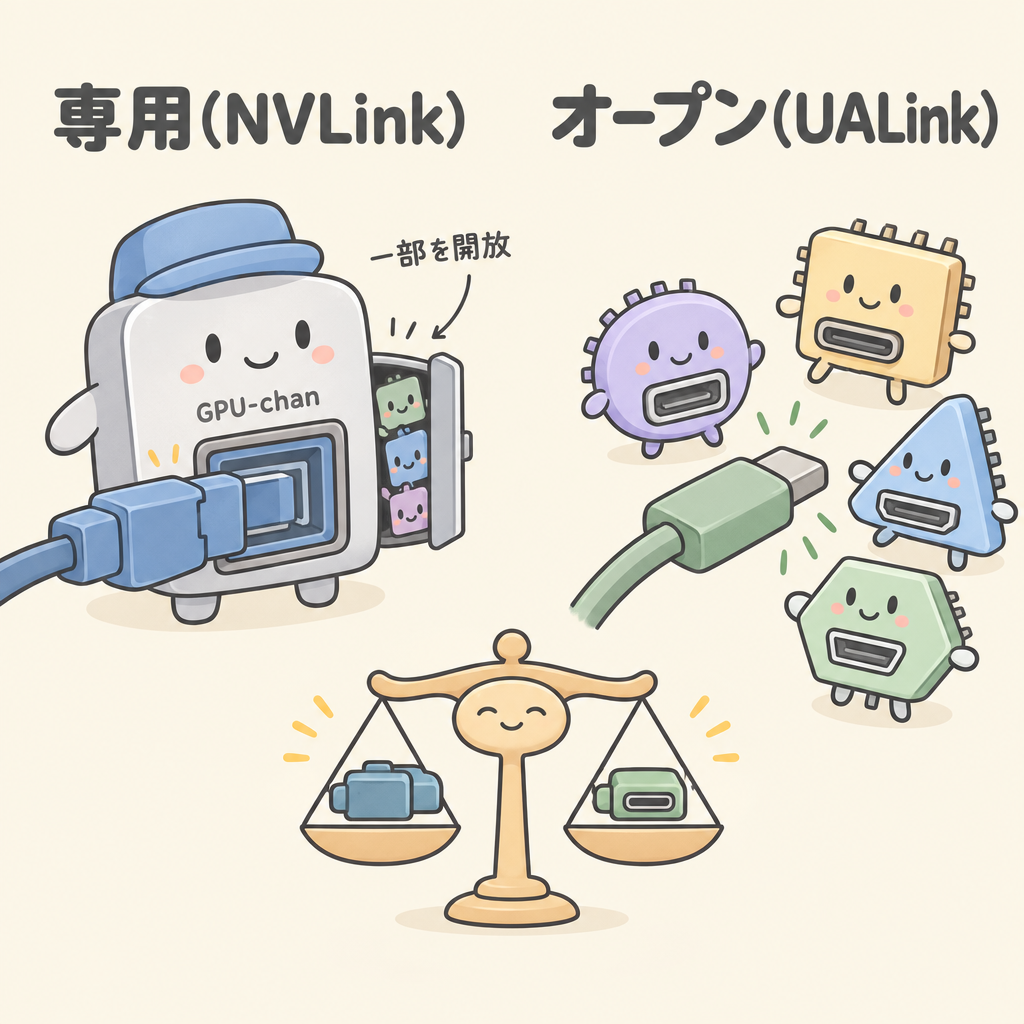
ラックの中でも起きている「専用 vs オープン」の構図
前回、ラックの外で「InfiniBand vs Ultra Ethernet」の対立を見ました。実はラックの中(スケールアップ)でもまったく同じ構図が起きています。
NVLink陣営(NVIDIA)
- 2016年から約10年の実績。NVL72として量産・出荷中
- 2025年にNVLink Fusionを発表。他社のCPUや専用チップもNVLinkにつなげるよう、一部を外部に開放
- MediaTek・Marvell・富士通・Qualcommなどが協業を表明
- 強み:「今すぐ動く完成品」
オープン規格陣営(UALinkほか)
- 2024年にUALinkコンソーシアムが発足(AMD・Intel・Google・Meta・Microsoft・HPE・Ciscoなどが参加)
- 2025年4月に仕様1.0を公開。最大1,024基のスケールアップを想定
- BroadcomはEthernetベースのスケールアップ(SUE)を提案
- AMDは72基構成のラック「Helios」を2026年に投入予定と発表
たとえ話:専用充電ケーブル vs USB-C
NVLinkは、1社の製品同士なら最高の性能が出る
専用コネクタです。UALinkは、どのメーカーの機器でも挿せる
USB-Cのような共通規格を目指しています。NVLink Fusionは、専用コネクタ側が「一部のメーカーには挿し口を貸します」と歩み寄った動きです。
ひとことメモ:オープン規格側はまだ「仕様と計画」が中心で、NVL72のような大規模な量産実績はこれからです。一方で、ハイパースケーラーが自社開発する専用チップ(TPU・Trainiumなど)は、それぞれ独自のスケールアップ網を持っています。発表ベースの計画と、出荷・稼働の実績は分けて見る必要があります。
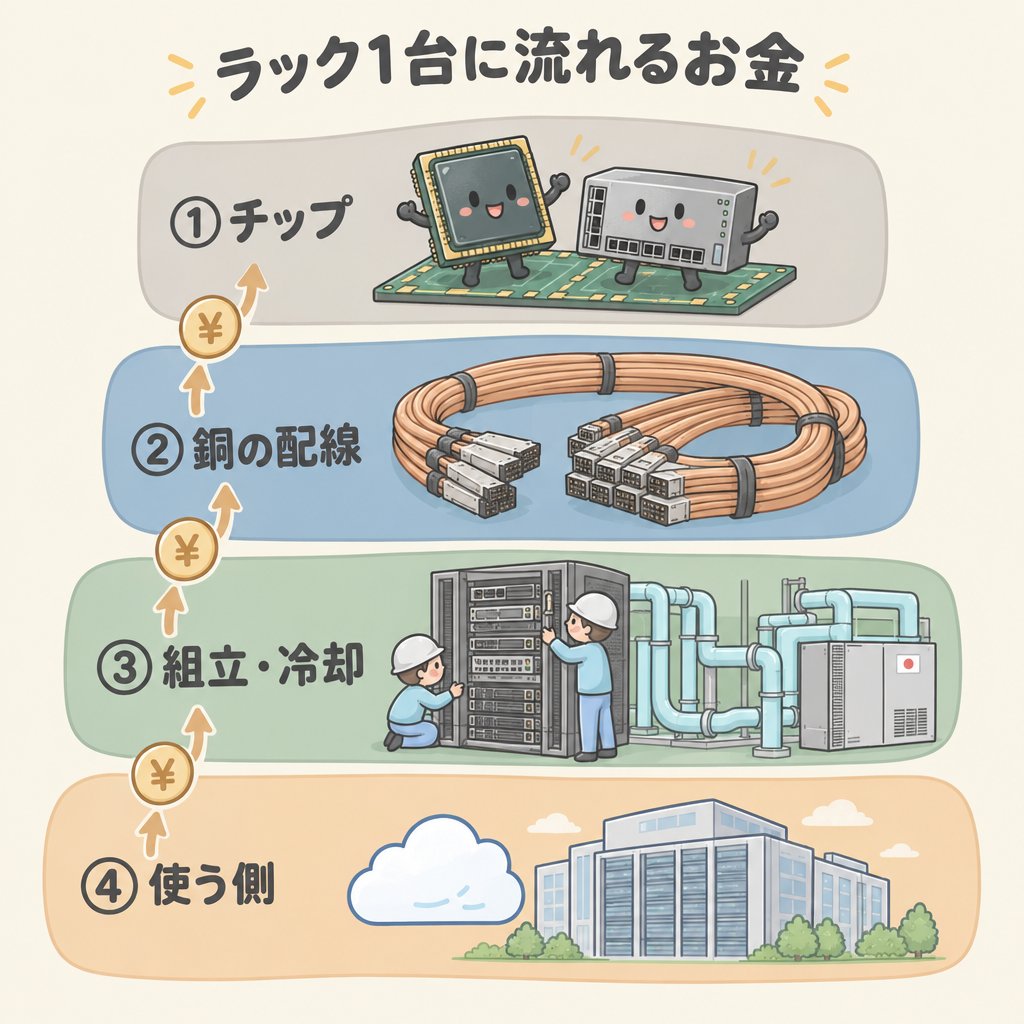
投資家向け:「1台の巨大GPU」を支えるお金の流れ
NVL72はラックが丸ごと1つの製品なので、GPU以外の部品(スイッチチップ、銅ケーブル、液冷、組み立て)にもお金が流れます。4層で整理しましょう。
①チップ(GPU・NVSwitch)
- NVIDIA(NVDA):GPU・NVSwitch・ラック設計を主導
- TSMC(TSM/台湾2330):製造と先端パッケージ(CoWoS)
- イビデン(4062):チップを載せるパッケージ基板
②ラック内の配線(銅の背骨)
- Amphenol(APH):NVL72の銅ケーブル・コネクタの主要供給元(報道ベース)
- Astera Labs(ALAB):信号をつなぐチップ。NVLink Fusion・UALinkの両方に参加
③ラックの組立・冷却・電源
- 鴻海(Foxconn)(台湾2317)/Quanta(台湾2382):ラックの組立
- Supermicro(SMCI)/Dell(DELL):AIサーバー・ラックの販売
- Vertiv(VRT)/ニデック(6594):液冷CDU・電源
④使う側・対抗する側
- Microsoft(MSFT)/Oracle(ORCL)/CoreWeave(CRWV):NVL72の大口導入者
- AMD(AMD):UALinkを推進し、72基のラックで対抗
- 富士通(6702):NVLink Fusionで自社CPUとの連携を表明
あなたにとって、この話は何を意味するか
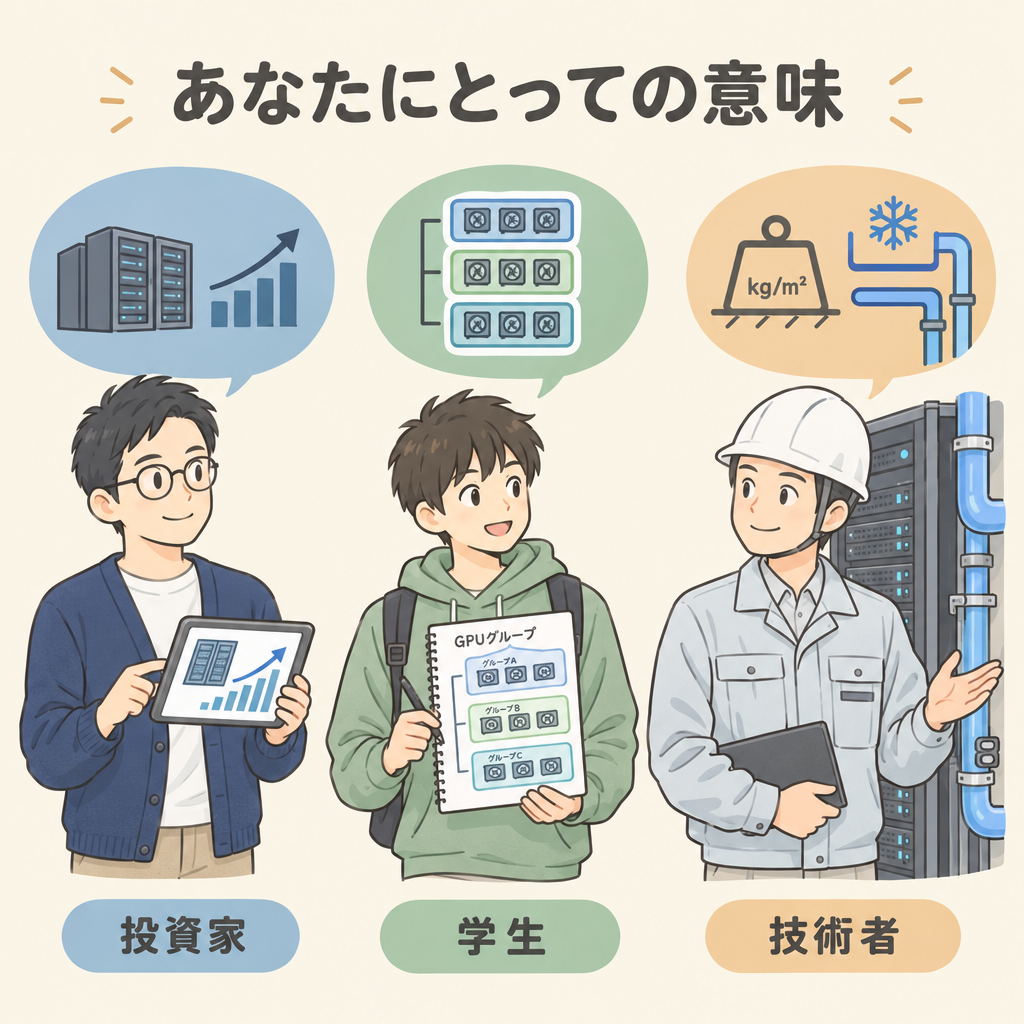
個人投資家の方へ
NVIDIAの強みは「速いGPU」だけではなく、
72基を1つにまとめるNVLink・NVSwitch・ソフトの一式にあります。競合がGPU単体で追いついても、ラック単位の完成度で差が残りやすい構造です。一方で、UALinkなどの
オープン規格がいつ量産に届くかは、この優位が続くかを測る物差しになります(→
「独占」は続くのか|参入障壁の判定法)。
理工系学生の方へ
「どの計算をどのGPUに分けるか」を考える並列化の設計は、AIエンジニアの中心的な仕事の1つです。NVLinkドメインの大きさは、その設計の前提条件になります。情報系なら分散学習、電気系なら高速信号伝送(SerDes)がそのまま活きる分野です。
電気・設備系の技術者の方へ
NVL72は「銅で72基をつなぐ」ためにGPUを1ラックに詰め込んだ結果、1ラック約120kW・液冷前提・1トン超になりました。つまり、ネットワークの都合が受電容量・冷却設計・床荷重を決めています。IT側の構成を知ることが、設備設計の出発点になる時代です。
よくある誤解を4つ解いておきます
誤解1:「NVLinkはInfiniBandの上位版」
役割が違います。NVLinkはラックの中(スケールアップ)、InfiniBandはラックの外(スケールアウト)を担当します。NVL72も、ラック同士はInfiniBandかEthernetでつなぎます。どちらか一方ではなく、両方を使います。
誤解2:「NVL72は、GPUを72個入れた棚にすぎない」
物理的に72個並べるだけなら昔のラックでもできます。NVL72の本質は、18個のNVSwitchで72基を総当たりにつなぎ、互いのメモリを直接読み書きできるようにした「論理的な結合」にあります。
誤解3:「スケールアップを大きくすれば、スケールアウトはいらなくなる」
最先端の学習には数万〜数十万基のGPUが必要です。NVLinkドメインが数百基に広がっても、その外側をつなぐネットワークは必要です。スケールアップが大きくなると、外に出す通信の「質」が変わるだけです。
誤解4:「NVLinkは学習用で、推論には関係ない」
巨大モデルやMoEモデルの推論では、1つのGPUにモデルが入り切らないため、
複数のGPUで分担してリアルタイムに通信します。NVIDIAは、NVL72を推論性能の大幅な向上の柱として打ち出しています(→
GB300(Blackwell Ultra)とは)。
まとめ:NVLinkは「ラックを1台の計算機」に変えた
NVLinkはGPU同士の専用配線。Blackwell世代で1.8TB/s、PCIe 5.0の約14倍
NVSwitch 18個が72基を総当たりでつなぎ、互いのHBMを直接読み書きできる「1つのメモリ空間」を作る
スケールアップ(ラック内)とスケールアウト(ラック外)では、GPUあたりの帯域に約9倍の差がある
頻繁で待てない通信(テンソル並列・MoE)は中へ、1ステップ1回の通信(データ並列)は外へ
「72」は、銅の到達距離・光の電力コスト・約120kWの電力と熱が釣り合う点
ラックの中でもNVLink vs UALinkという「専用 vs オープン」の構図がある
もっと深く知りたい方へ:4大ボトルネック別の専門ガイド
AIデータセンターは「計算・電力・冷却・通信」の4つで詰まります。気になる扉から進んでください。
よくある質問(FAQ)
Q1. NVLinkとは何ですか?
NVLinkは、NVIDIAが開発したGPU同士を直接つなぐ専用の高速接続技術です。Blackwell世代ではGPU1基あたり1.8TB/s(双方向)の帯域を持ち、汎用規格のPCIe 5.0 x16の約14倍にあたります。
Q2. NVSwitchとは何ですか?
NVSwitchは、多数のGPUのNVLinkを束ねて中継するスイッチチップです。GB200/GB300 NVL72では18個のNVSwitchが72基のGPUを総当たりでつなぎ、どのGPU同士も1回の中継で通信できるようにしています。
Q3. スケールアップとスケールアウトの違いは?
スケールアップは1つのまとまり(ラック)の中でGPUを太く密につなぐこと、スケールアウトはまとまりの数を増やしてネットワークでつなぐことです。AIデータセンターでは、ラック内をNVLink、ラック間をInfiniBandやEthernetでつなぐのが基本です。
Q4. NVL72の「72」は何の数字ですか?
NVLinkで直接つながるGPU(パッケージ)の数です。銅線が届く距離、光を使った場合の電力増加、1ラックで扱える電力と熱(約120kW級・液冷)という物理的な制約が釣り合う規模として、72基が採用されました。
Q5. NVLinkはPCIeの代わりになるのですか?
完全な代わりではありません。GPU同士の通信はNVLinkが担いますが、SSDやネットワークカード(NIC)などの周辺機器との接続には、今もPCIeが使われています。役割を分担していると考えるのが正確です。
Q6. UALinkとは何ですか?
AMD・Intel・Google・Meta・Microsoftなどが参加するUALinkコンソーシアムが定めた、スケールアップ用のオープン規格です。2025年4月に仕様1.0が公開され、最大1,024基のアクセラレータをつなぐことを想定しています。NVLinkへの対抗軸と位置づけられています。
次に読むべき記事
「ラックの中」を理解したら、次は物理・製品・外側・メモリへ。おすすめ順に並べています。
コメント