- NVIDIAの決算で「ネットワーク売上が過去最高」と聞くけれど、GPUの会社がなぜネットワークで稼ぐのか分からない
- 「InfiniBand」と「Ethernet」、どちらもケーブルでつなぐ通信なのに、何がそんなに違うのか想像できない
- 「Ultra Ethernet」「RoCE」「RDMA」など、カタカナとアルファベットが多すぎて、ニュースを読んでも頭に残らない
- AI関連株の中で、ネットワーク銘柄(Arista・Broadcom・フジクラなど)がどう位置づけられるのか、地図がほしい
AIの学習では、何千〜何万個ものGPUが「全員そろって、同時に」通信します。そのため、たった1台の遅れが全体を止めてしまいます。
この記事では、その仕組みを中学生でも分かる言葉で、図を使いながら1から整理します。
こんにちは。この記事は、AIデータセンターの「ネットワーク(通信)」の入門編です。GPUやHBMの話はよく聞くのに、それらをつなぐ道路の話はあまり語られません。ところが今、この「道路」がAIの性能とお金の流れを大きく左右するようになっています。読み終えるころには、InfiniBandとEthernetの違いを、自分の言葉で説明できるようになっているはずです。
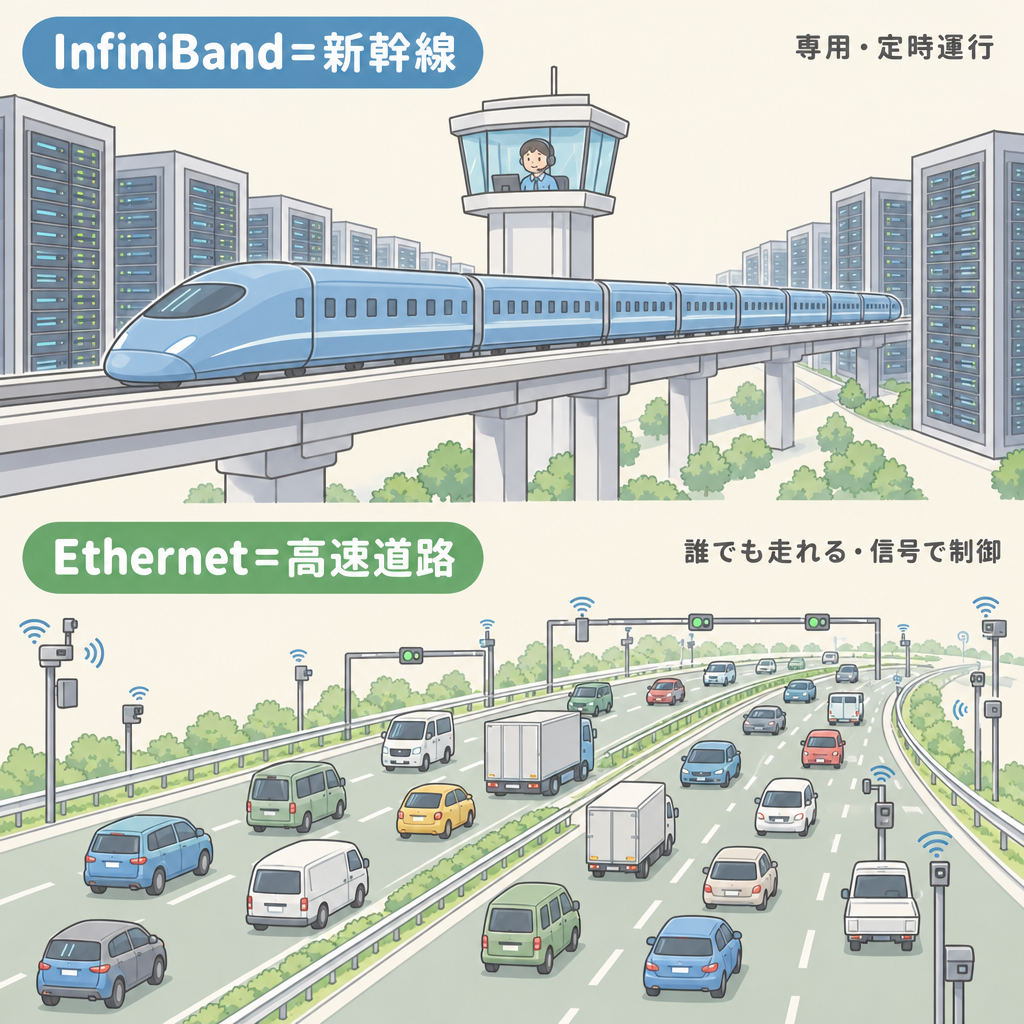
① InfiniBandは、スーパーコンピュータ向けに生まれた「最初からデータを落とさない」専用の通信規格です。現在はほぼNVIDIA(NVDA)1社が供給しています(2020年に旧Mellanoxの買収を完了)。
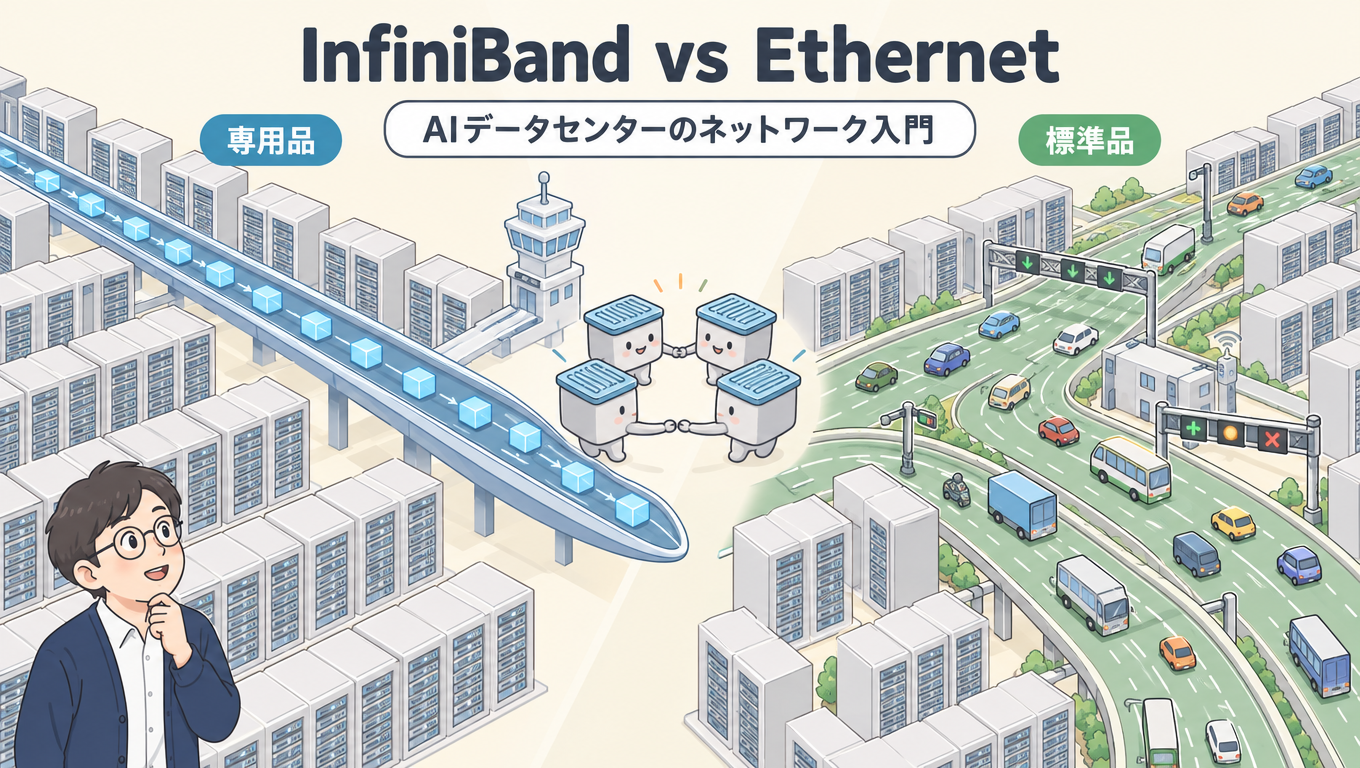
② Ethernetは、世界中のオフィスや家庭で使われている汎用の通信規格です。多くの企業が作れる一方、本来は「混んだらデータを捨てて送り直す」設計です。
③ AIの学習では、全GPUが計算結果を足し合わせるAll-Reduceを何度も繰り返します。一番遅いGPUを全員が待つので、平均の速さよりも「ばらつき(最悪値)」が性能を決めます。
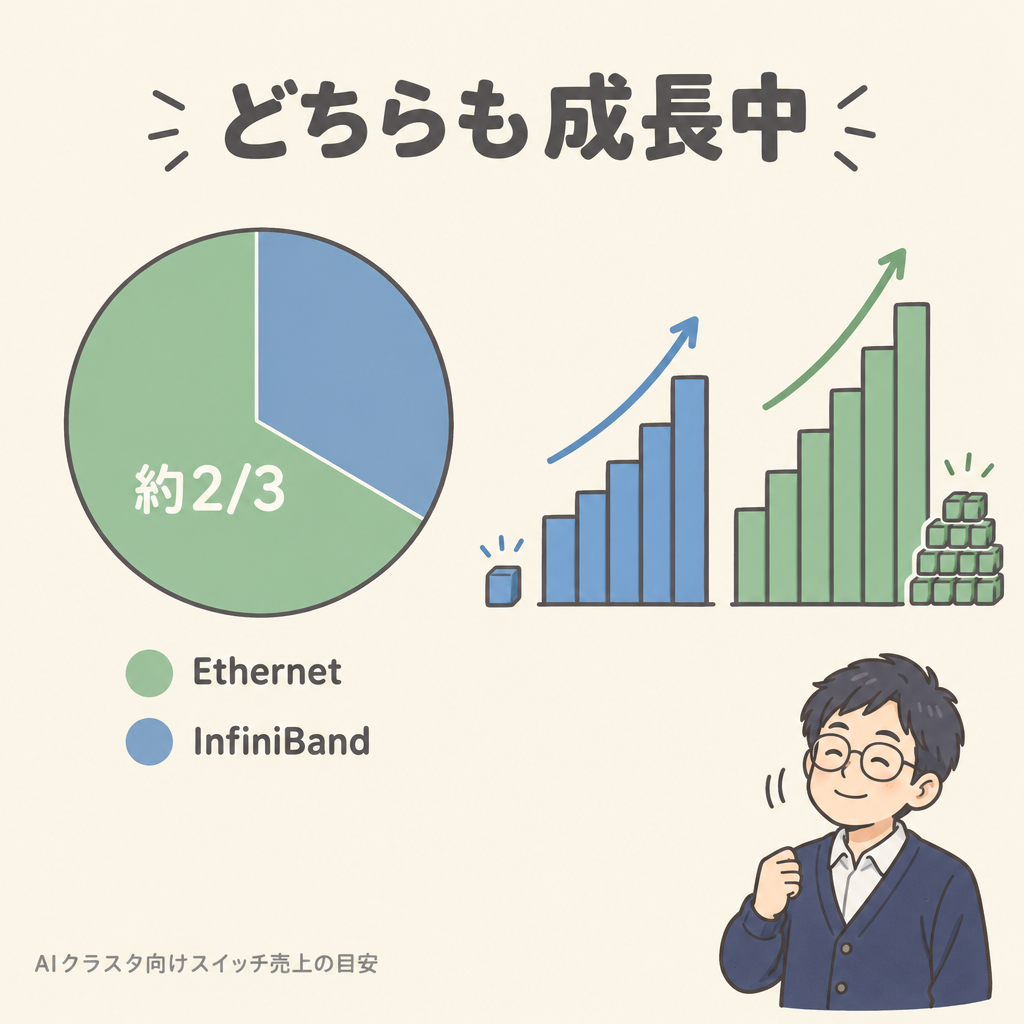
④ 市場では、InfiniBandの「完成された専用品」と、Ultra Ethernet陣営の「開かれた標準品」がぶつかっています。調査会社Dell’Oroによると、2026年1〜3月期はAIクラスタ向けデータセンタースイッチ売上の約3分の2をEthernetが占めました。一方でInfiniBandも前年同期比で3倍超に伸びています。「どちらかが消える」ではなく「両方伸びている」のが現在地です。
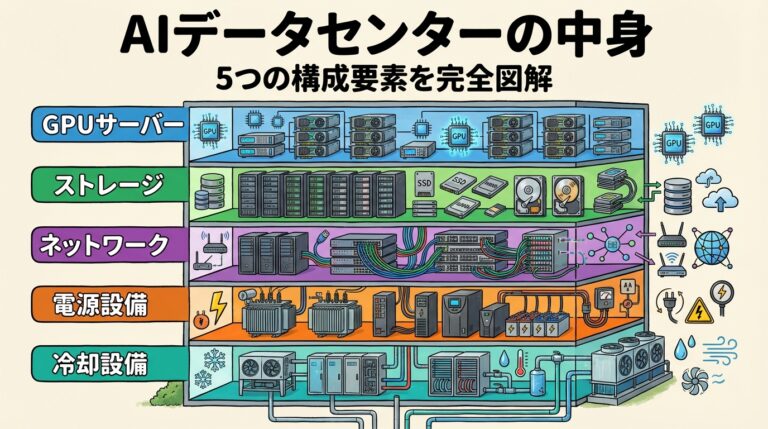
▶ AIデータセンターとは?従来型との違いと構造/ ▶ AIデータセンターの中身とは?5つの構成要素
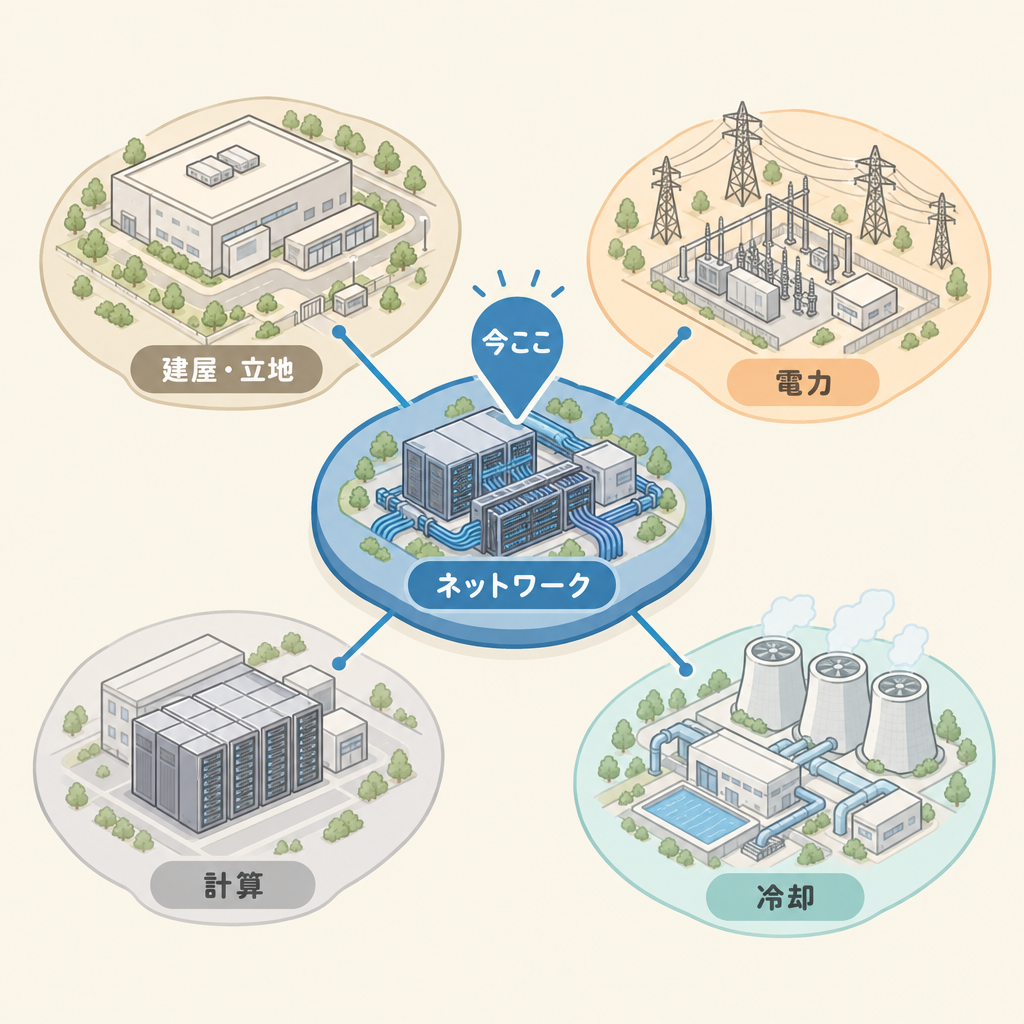
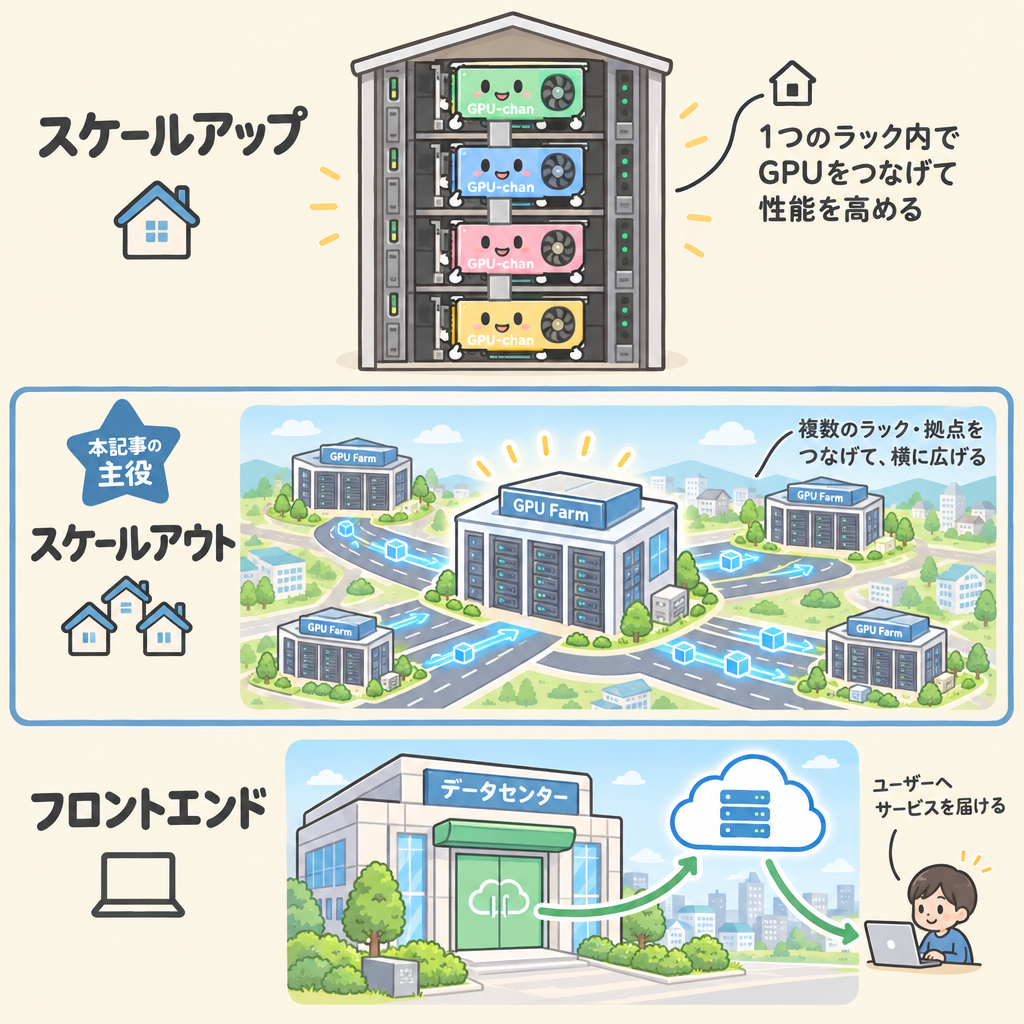
全体像:AIデータセンターには「3種類の道路」がある
「データセンターのネットワーク」とひとことで言っても、AIデータセンターでは役割のまったく違う道路が何本も並んでいます。InfiniBandとEthernetの話をする前に、「どの道路の話なのか」をはっきりさせておきましょう。
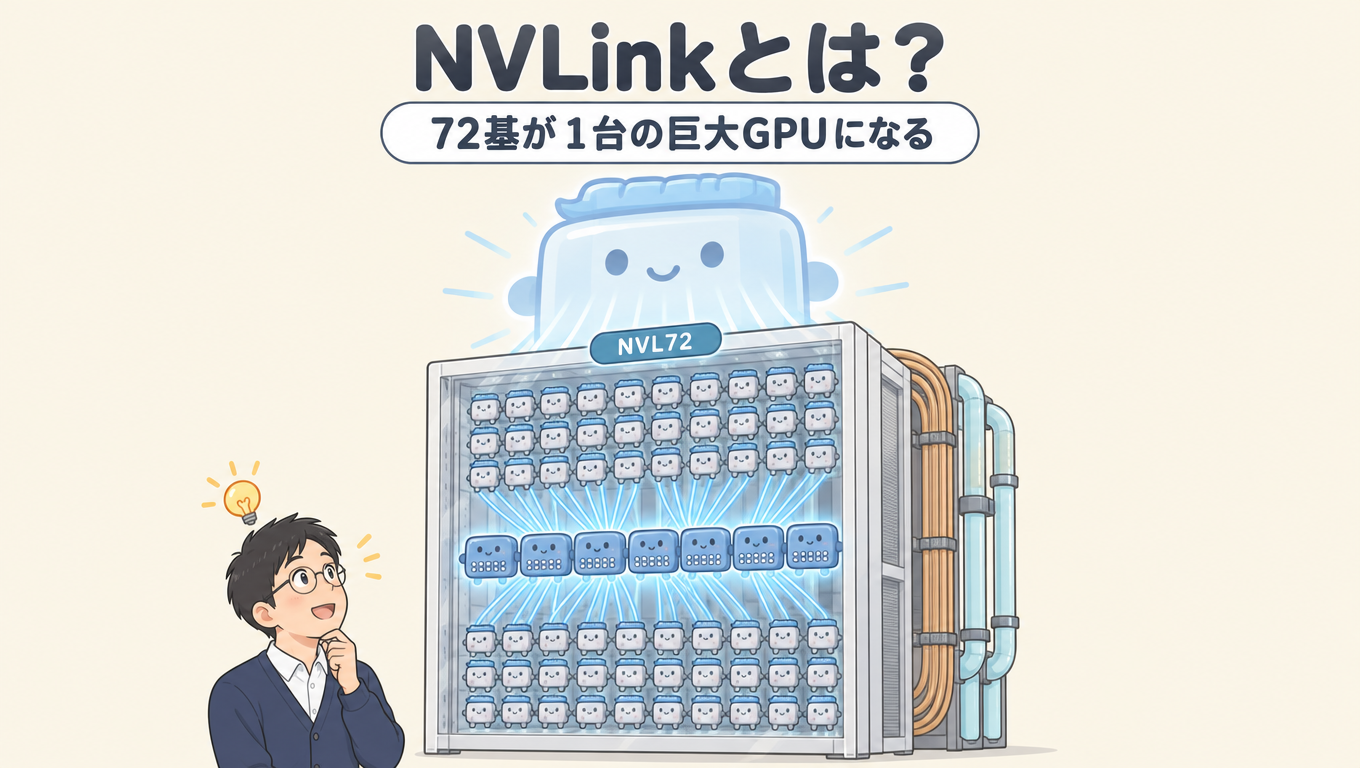
① スケールアップ
- ラック内のGPU同士を超高速で直結する
- 代表例:NVIDIAのNVLink(GB200/GB300 NVL72など)
- 数十個のGPUを「1つの巨大GPU」として動かす
② スケールアウト(本記事の主役)
- ラックとラック、数千〜数万GPUをつなぐ
- 「バックエンドネットワーク」とも呼ぶ
- InfiniBand vs Ethernetの戦場はここ
③ フロントエンド
- 利用者・インターネット・ストレージとつなぐ
- 従来DCとほぼ同じ一般的なEthernet
- 管理用のネットワークも別にある
NIC(ニック):サーバーについている「通信の出入り口」となる部品です。家でいえばLANの差し込み口にあたりますが、AI向けは1枚で400〜800Gb/s級の性能があります。
この記事で扱うのは、主に②スケールアウトです。GPUサーバーそのものの姿はGPUサーバーとは?、ラック単位の話はGPUラックとは?で詳しく解説しています。
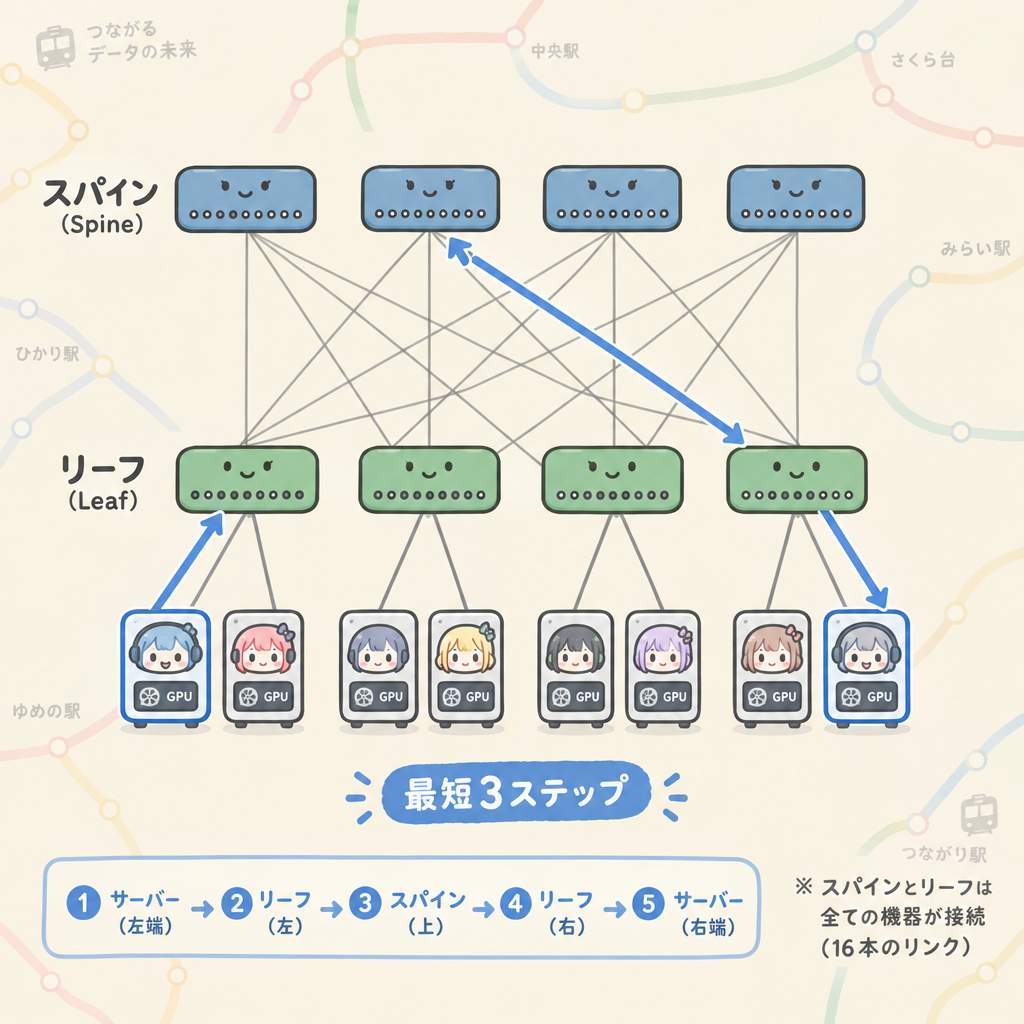
AIデータセンターの基本形「スパイン・リーフ構成」
何万台ものGPUをつなぐとき、ほぼ必ず使われる形が「スパイン・リーフ構成」です。スパイン(spine)は「背骨」、リーフ(leaf)は「葉っぱ」という意味です。
すべてのリーフが、すべてのスパインとつながる(網の目)
サーバー
サーバー
サーバー
サーバー
道が何本もあるので、1本が混んでも別ルートを使えます。
AI向けの工夫「レール最適化(Rail-Optimized)」
AIのGPUサーバーでは、GPU1個にNIC1枚がつくのが基本です。たとえば8GPUのサーバーなら、通信の出入り口が8つあります。そこで「各サーバーの1番GPUは全員リーフ1へ」「2番GPUは全員リーフ2へ」というように、同じ番号のGPUを同じ線路(レール)に並べるつなぎ方がよく使われます。同じ番号のGPU同士はスパインを通らずに話せるので、渋滞が起きにくくなります。
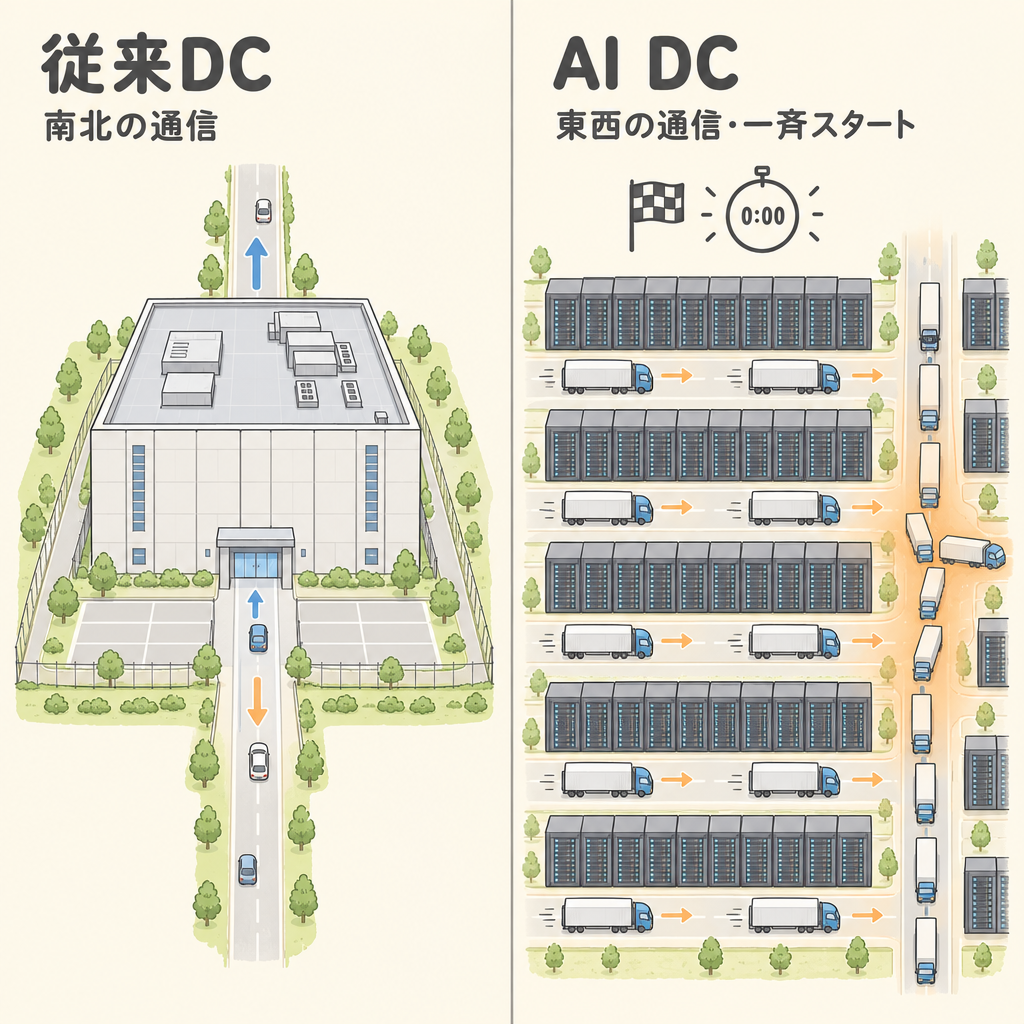
従来DC vs AI DC:ネットワークはここまで変わった
「DCのネットワーク」自体は昔からあります。AIで変わったのは、通信の量・向き・許されるミスの大きさです。
| 比較項目 | 従来DC | AI DC(学習用) | 何が変わった |
|---|---|---|---|
| サーバー1台の通信口 | 10〜25Gb/s × 1〜2本 | 400〜800Gb/s × 8本前後 | 桁違いに増加 |
| 通信の向き | 南北(利用者 ⇔ サーバー)中心 | 東西(GPU ⇔ GPU)中心 | DCの「中」が主戦場に |
| 通信のタイミング | バラバラ(各利用者が好きな時に) | 全GPUが一斉に | 瞬間的な大渋滞が起きる |
| データ欠け(パケットロス) | 送り直せばOK | 全体の足を引っ張る | 「落とさない」が必須に |
| 重視する指標 | 平均的な速さ・コスト | 最悪値(テールレイテンシ) | 評価の物差しが変わった |
| ネットワークの本数 | 基本1系統(+管理用) | スケールアップ・バックエンド・フロントエンド・ストレージ・管理 | 多層化・複雑化 |
テールレイテンシ:たくさん通信したときの、一番遅いグループの待ち時間です。「平均は速いけど、たまに極端に遅い」の「たまに」の部分を指します。AIではこれが主役になります。
RDMAとは?「CPUを通さず、メモリ同士が直接話す」仕組み
InfiniBandとEthernetの違いを理解するには、RDMA(Remote Direct Memory Access:遠くのメモリへの直接アクセス)を先に知っておくと近道です。AIのネットワークは、ほぼすべてこのRDMAを前提に作られています。
RDMAは、相手の机の引き出しまでつながった専用のパイプで書類を直接送り込むイメージです。窓口の人(CPU)は何もしなくてよいので、そのぶん本業に集中できます。
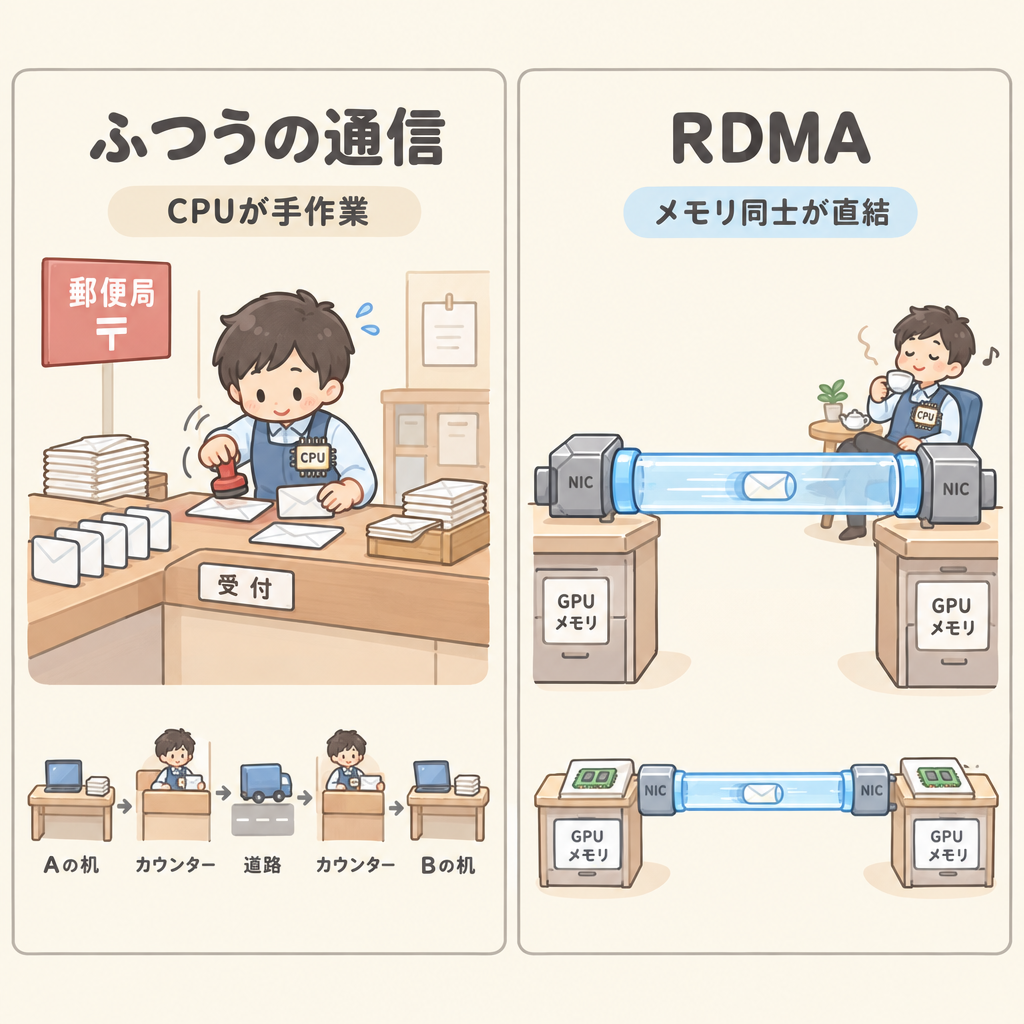
GPUDirect RDMA:GPUのメモリ同士が直接話す
AIでは、RDMAをもう一歩進めたGPUDirect RDMAが使われます。NICがCPU側のメモリも経由せず、GPUに載ったメモリ(HBM)から直接データを出し入れします。「AIの計算結果はGPUの中にある」ので、それをいちいちCPU側に移さないことが大きな時短になります。
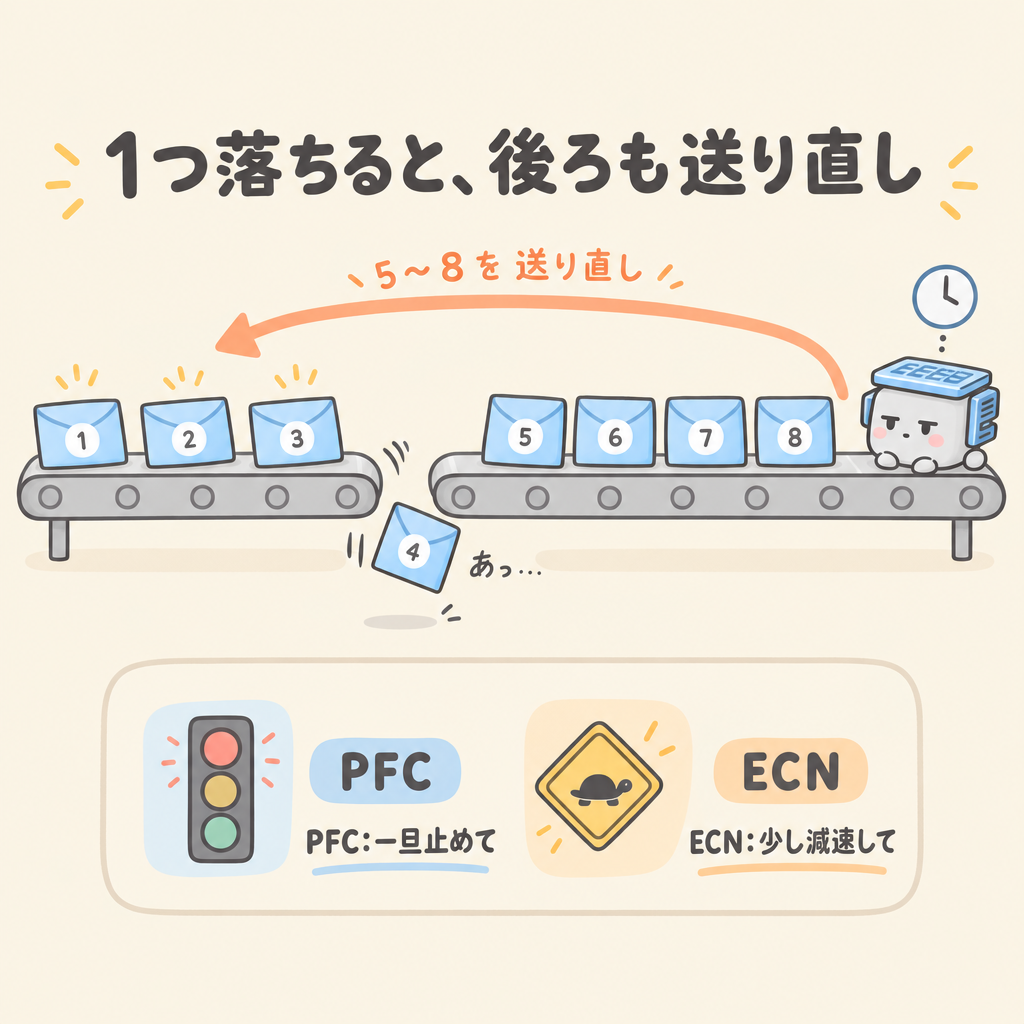
同じRDMAでも「道路の造り」が違う
PFC:スイッチが「今いっぱいだから一旦止めて」と手前の機器に合図する仕組み。
ECN:「混み始めたよ」と送り手に知らせて、送る速さを落としてもらう仕組み。
ロスレス:データ(パケット)を途中で捨てないこと。
RDMAは「届く前提」で最適化された仕組みです。途中で1つでもデータが欠けると、その後ろのデータもまとめて送り直しになることがあり、待ち時間が一気に跳ね上がります。この「たまに起きる大きな遅れ」がAIでは致命的になります。理由は次の章のAll-Reduceで説明します。
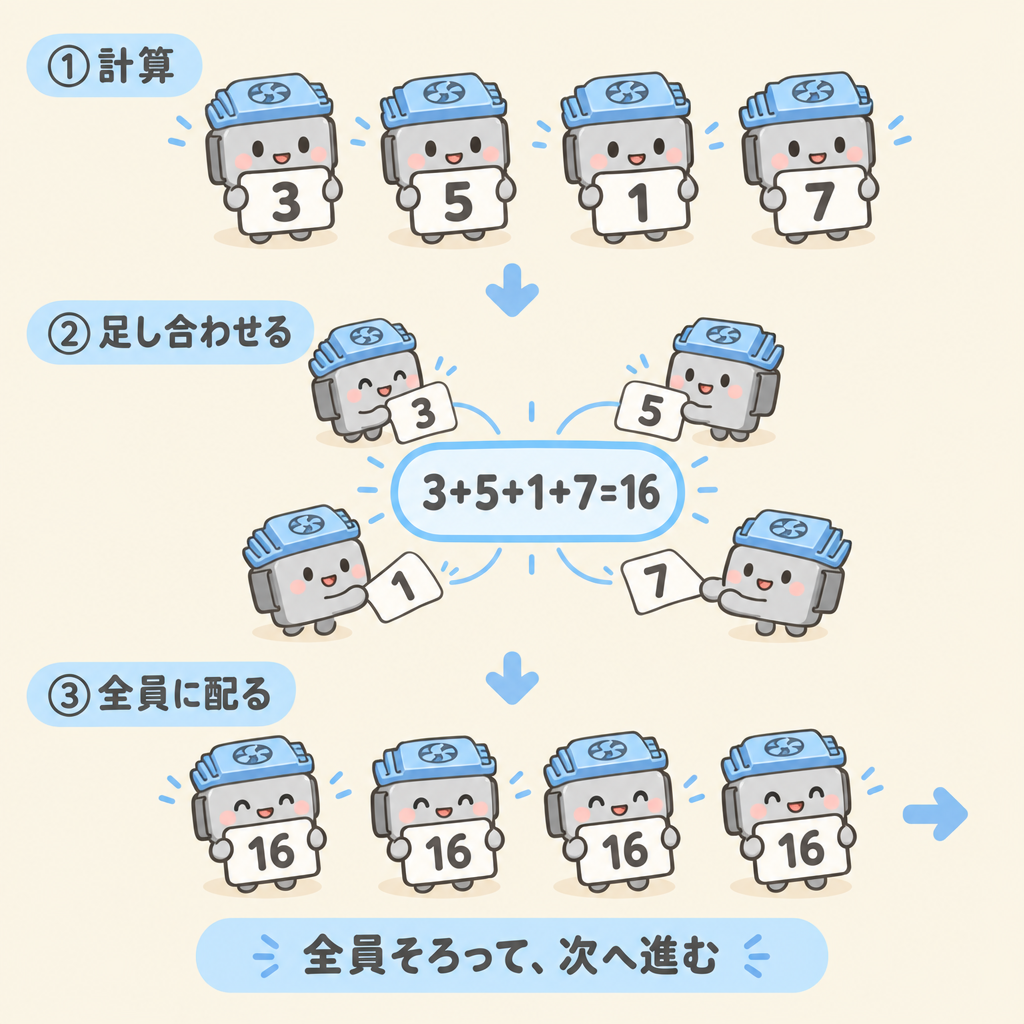
核心:なぜAIだけネットワーク要件が特殊なのか ―「All-Reduce」
ここがこの記事でいちばん大事な部分です。AIの学習では、大量のデータを何千個ものGPUに分けて同時に計算させます。ただし、各GPUが出した「修正の方向(勾配)」はバラバラなので、全員分を足し合わせて平均し、その結果を全員に配る必要があります。これがAll-Reduce(オール・リデュース)です。
1台でも数字が届かなければ、残り全員は待つしかありません。
実際には数字1個ではなく、モデルの大きさ分のデータが動きます。単純計算では、700億パラメータのモデルなら1回で約140GB(1パラメータ2バイトとして)の勾配をやりとりします。しかもこれを学習中に何十万回も繰り返します。(※実際はデータの分け方の工夫により、GPU1台あたりの通信量は構成によって変わります)
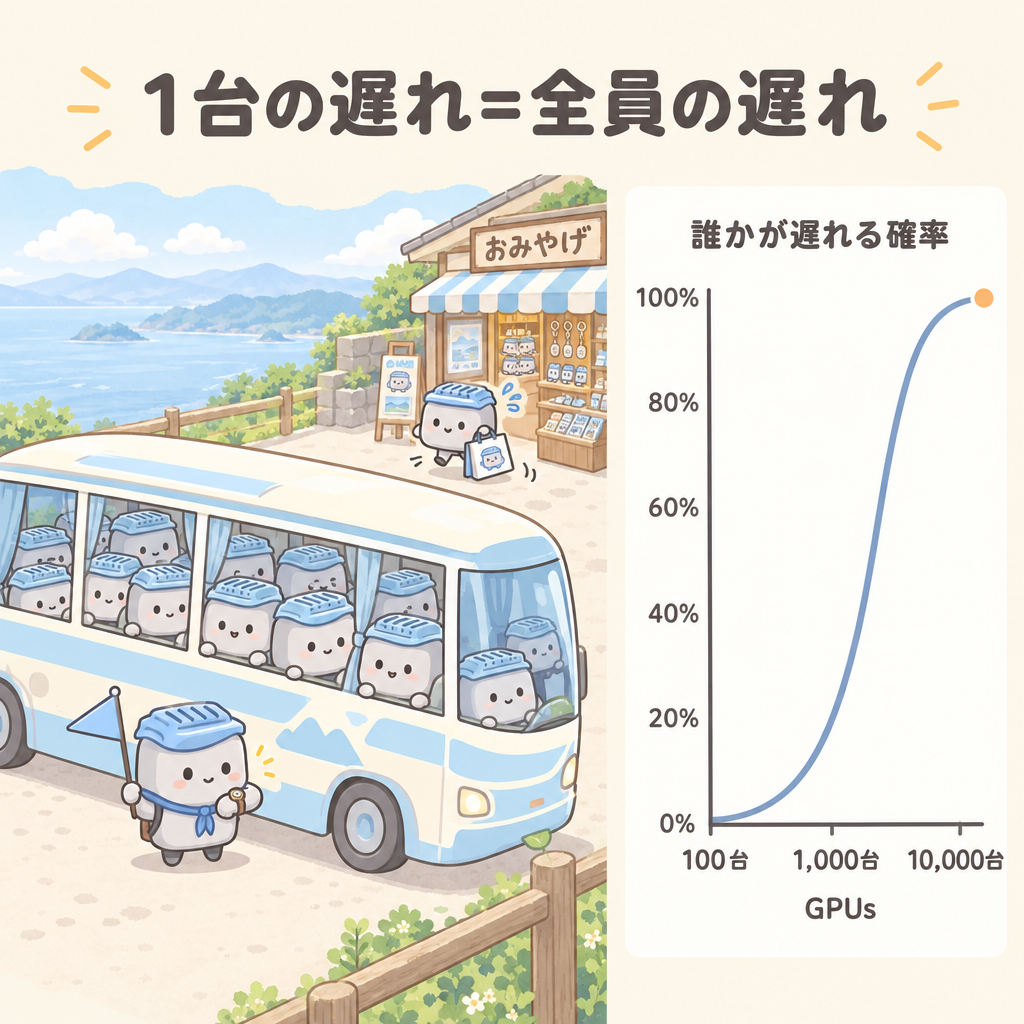
All-Reduceはまさにこの状態です。そして観光地(学習ステップ)は何十万か所もあります。
GPUが増えるほど「誰かが遅れる確率」は跳ね上がる
ここで、簡単な確率の思考実験をしてみます。各GPUの通信が、1ステップの中で「たまたま遅れる」確率を0.1%(1,000回に1回)とします。1台だけで見れば、ほとんど気にならない数字ですよね。ところが、全員そろうまで待つAll-Reduceでは「少なくとも1台が遅れる確率」が問題になります。
| GPU台数 | 1ステップで誰かが遅れる確率 | 意味 |
|---|---|---|
| 100台 | 約9.5% | 10回に1回ほど待たされる |
| 1,000台 | 約63% | 過半数のステップで待たされる |
| 10,000台 | 約99.995% | ほぼ毎回、誰かが遅れる |
| 100,000台 | ほぼ100% | 「最悪値」=「毎回の速さ」になる |
AIの通信は「渋滞を起こしやすい」性質を持つ
NCCL(ニッケル):NVIDIAが提供する、All-Reduceなどの「集団通信」を行うソフトウェアです。
InfiniBandとEthernetの違いを8つの視点で比較
ここまでの話を踏まえると、両者の違いは「速さ」よりも「生まれ育ち」と「思想」の違いだと分かります。
| 視点 | InfiniBand | Ethernet(AI向け) |
|---|---|---|
| ① 生まれ | 2000年ごろ。スパコン・高性能計算(HPC)向けの専用規格 | 1980年代。オフィスや家庭のLANから広がった汎用規格 |
| ② 供給企業 | 実質NVIDIA(旧Mellanox)1社 | Broadcom・Arista・Cisco・NVIDIA・Celesticaなど多数 |
| ③ データを捨てるか | 設計段階で捨てない(クレジット方式) | 本来は捨てる。PFC・ECNなどで後から捨てないようにする |
| ④ RDMA | 最初から組み込み済み | RoCE v2で対応。Ultra Ethernetで刷新中 |
| ⑤ 渋滞対策 | 混雑に応じた自動迂回、スイッチ内での足し算(SHARP) | 製品ごとに独自機能を搭載(NVIDIA Spectrum-Xなど)。Ultra Ethernetで標準化を進める |
| ⑥ 管理・運用 | 専用の管理ソフトで一括制御。専門人材が必要 | 既存DCの運用ノウハウ・人材を流用しやすい |
| ⑦ 調達・コスト | 1社依存(ロックイン)になりやすい | 競争があり、価格交渉・分散調達がしやすい |
| ⑧ 得意な場面 | 「すぐ・確実に」性能を出したい一体型の学習クラスタ、HPC | 自社で作り込めるハイパースケーラーの超大規模クラスタ |
Ethernet=高速道路です。どのメーカーの車でも走れて、道路も誰でも造れます。ただ、そのままでは渋滞や事故で遅れが出るので、AI用には「全車に自動運転と信号制御を入れて、新幹線並みの定時運行を目指す」改造をしています。その改造の標準ルールづくりが、次に紹介するUltra Ethernetです。
対立構図:「NVIDIAの専用品」vs「Ultra Ethernet陣営の標準品」
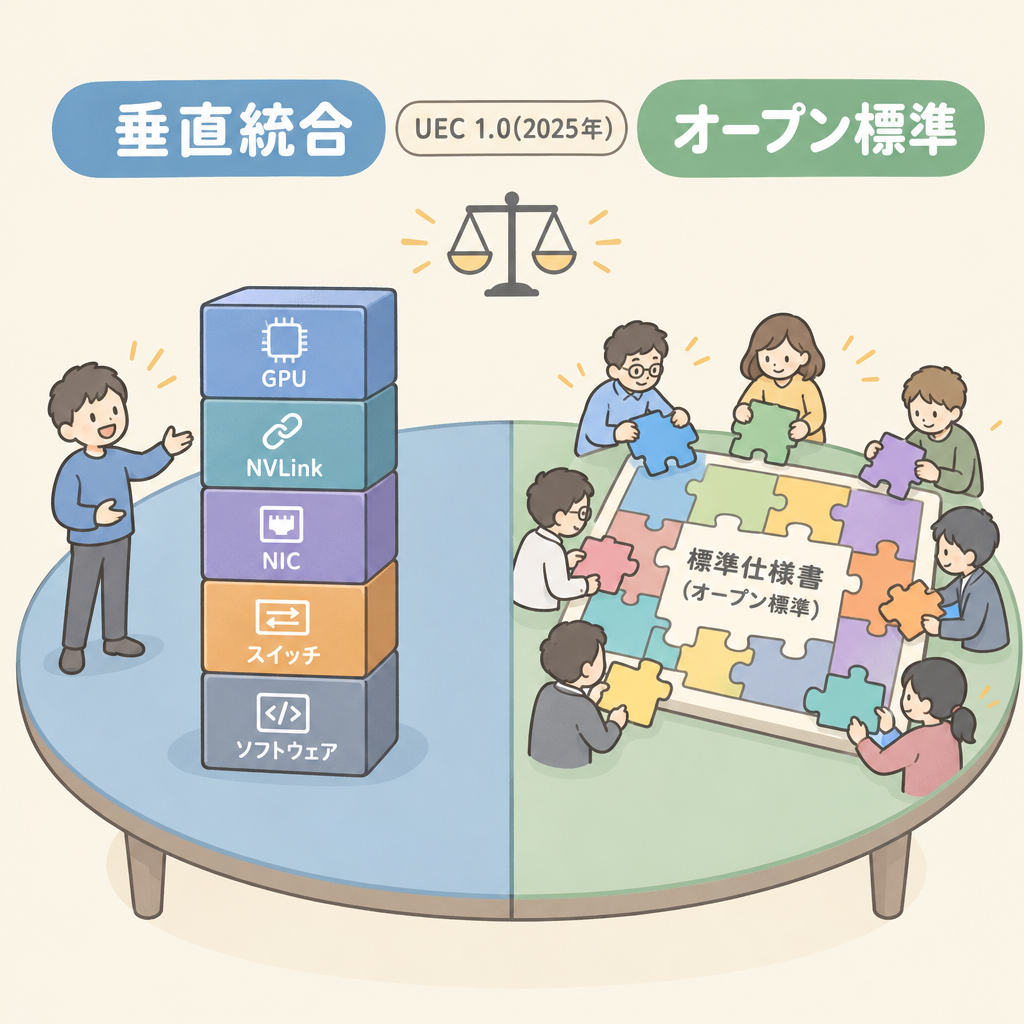
ニュースでは「InfiniBand vs Ethernet」と書かれがちですが、本当の対立軸は「1社が全部そろえて最適化する」か「みんなで標準を決めて部品を持ち寄る」かです。しかもNVIDIAは、InfiniBand(Quantum)とEthernet(Spectrum-X)の両方を売っている点が、この構図を分かりにくくしています。
NVIDIA陣営(垂直統合)
- GPU+NVLink+NIC+スイッチ+ソフト(NCCL)を一式で提供
- InfiniBand:Quantum-X800(800Gb/s×144ポート、SHARP v4搭載)
- Ethernet:Spectrum-X(AI向けに改造したEthernet。2025年10月にMeta・Oracleの採用を発表)
- 強み:「買えばすぐ性能が出る」完成度
Ultra Ethernet陣営(オープン標準)
- 2023年設立のUltra Ethernet Consortium(UEC)。Linux Foundation傘下
- 創設メンバー:AMD・Arista・Broadcom・Cisco・Eviden・HPE・Intel・Meta・Microsoft
- 2025年6月にUEC仕様1.0を公開(RDMA・渋滞制御などを刷新)
- 強み:複数社から調達でき、1社依存を避けられる
投資家向け:AIネットワークのお金の流れを4層で整理
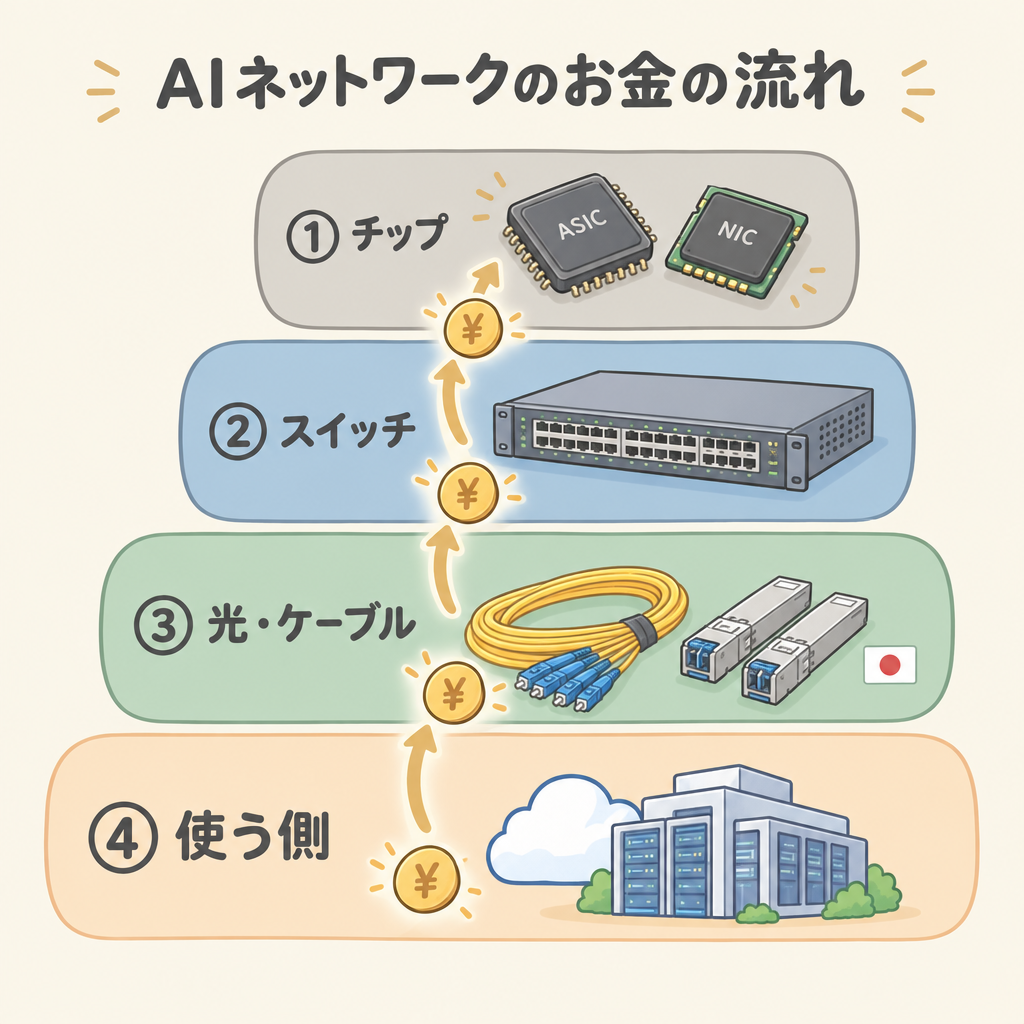
「InfiniBandかEthernetか」はどちらが勝っても、通信量そのものが増え続けることに変わりはありません。どの層に誰がいるかを地図にしておくと、ニュースの重みを判断しやすくなります。
①チップ(スイッチASIC・NIC)
- NVIDIA(NVDA):InfiniBand・Spectrum-X・ConnectX NIC
- Broadcom(AVGO):Ethernetスイッチチップ「Tomahawk」系の大手
- Marvell(MRVL):スイッチ・光通信向けチップ
- AMD(AMD):UEC対応のAI向けNIC
②スイッチ機器
- Arista Networks(ANET):ハイパースケーラー向けEthernetの代表格
- Celestica(CLS):自社ブランドなしの受託型スイッチ。2026年1〜3月期のAI向けEthernetで首位(Dell’Oro)
- Cisco(CSCO):同期間でシェア拡大が最大
③光・ケーブル(日本企業の出番)
- フジクラ(5803):DC内の高密度光ファイバー・コネクタ
- 古河電工(5801):光トランシーバー向けレーザー光源
- 住友電工(5802):化合物半導体・光デバイス
- Coherent(COHR):光トランシーバー大手
④使う側(方式を選ぶ人)
- Meta(META)/Microsoft(MSFT)/Oracle(ORCL):大口の買い手
- CoreWeave(CRWV):GPU専業クラウド(ネオクラウド)
- さくらインターネット(3778):国産GPUクラウド
③の光部品の会社については、フジクラ・古河電工・住友電工の企業分析で詳しく扱っています。NVIDIAを中心とした全体の取引構造はNVIDIA AI半導体のサプライチェーン全マップが参考になります。
あなたにとって、この話は何を意味するか
よくある誤解を4つ解いておきます
まとめ:AIのネットワークは「全員の歩調」を守る仕組み
基本形はスパイン・リーフ構成。AI向けには「レール最適化」を組み合わせる
RDMAでCPUを通さずGPUメモリ同士が直接話す。そのためデータを「捨てない」ことが前提になる
学習のAll-Reduceは全員そろうまで待つ仕組み。規模が大きいほどばらつき(テールレイテンシ)が性能を決める
対立の本質はNVIDIAの垂直統合 vs Ultra Ethernetのオープン標準。市場全体が拡大しており、両方が伸びている
よくある質問(FAQ)
メーカーで電気設計と品質保証に携わってきた経験をもとに、AIインフラを支える半導体・電力・冷却の仕組みを、図解でやさしく解説しています。
次に読むべき記事
ここまでで「InfiniBandとEthernetの違い」の全体像がつかめました。次は、つながりの深い記事で理解を一歩ずつ広げていきましょう。
テーマ別に、もっと深く学ぶ
気になるところから読んでも大丈夫です。どの記事も、はじめての方にもわかるように図解で書いています。
コメント