こんなモヤモヤ、ありませんか?
NVIDIAの決算で「ネットワーク売上が過去最高」と聞くけれど、GPUの会社がなぜネットワークで稼ぐのか分からない
「InfiniBand」と「Ethernet」、どちらもケーブルでつなぐ通信なのに、何がそんなに違うのか想像できない
「Ultra Ethernet」「RoCE」「RDMA」など、カタカナとアルファベットが多すぎて、ニュースを読んでも頭に残らない
AI関連株の中で、ネットワーク銘柄(Arista・Broadcom・フジクラなど)がどう位置づけられるのか、地図がほしい
実は、これらの疑問はすべて「All-Reduce(オール・リデュース)」 という1つの処理につながっています。「全員そろって、同時に」 通信します。そのため、たった1台の遅れが全体を止めてしまいます。
こんにちは。この記事は、AIデータセンターの「ネットワーク(通信)」 の入門編です。GPUやHBMの話はよく聞くのに、それらをつなぐ道路 の話はあまり語られません。ところが今、この「道路」がAIの性能とお金の流れを大きく左右するようになっています。読み終えるころには、InfiniBandとEthernetの違いを、自分の言葉で説明できるようになっているはずです。
あなたが今いる場所:AIインフラ > AIデータセンター入門 > InfiniBandとEthernet(DCネットワーク)
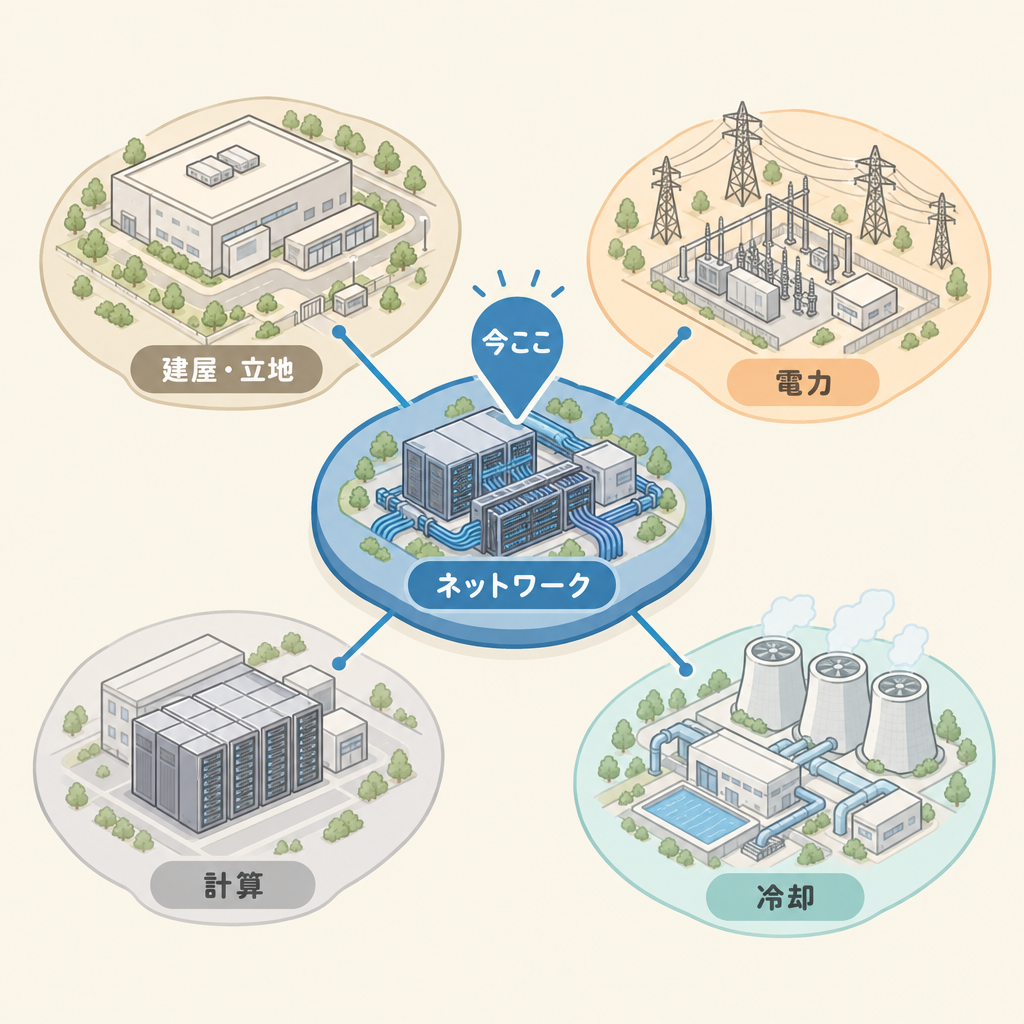
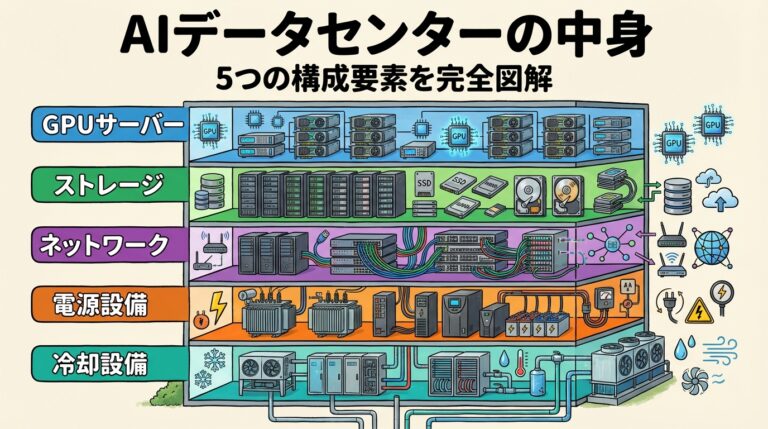
▼ AIデータセンターの5つの構成要素
建屋・立地
電力
冷却
計算(GPUサーバー)
ネットワーク ←ココ
▼ DCができるまで(ライフサイクル)
立地・用地確保
電力確保(系統接続)
設計・建設
設備・IT機器搭載 ←ココ
運用・サービス提供
ひとことメモ: ネットワークは「IT機器を載せる段階」の話に見えます。ただ実際は、ケーブルの長さの制約がラックの並べ方を決め、それが電力や冷却の設計にも影響します。そのため設計・建設の段階から関わるテーマ です。
先に結論:この記事の答え
① InfiniBand は、スーパーコンピュータ向けに生まれた「最初からデータを落とさない」専用の通信規格です。現在はほぼNVIDIA(NVDA) 1社が供給しています(2020年に旧Mellanoxの買収を完了)。
② Ethernet は、世界中のオフィスや家庭で使われている汎用の通信規格です。多くの企業が作れる一方、本来は「混んだらデータを捨てて送り直す」設計です。
③ AIの学習では、全GPUが計算結果を足し合わせるAll-Reduce を何度も繰り返します。一番遅いGPUを全員が待つ ので、平均の速さよりも「ばらつき(最悪値)」 が性能を決めます。
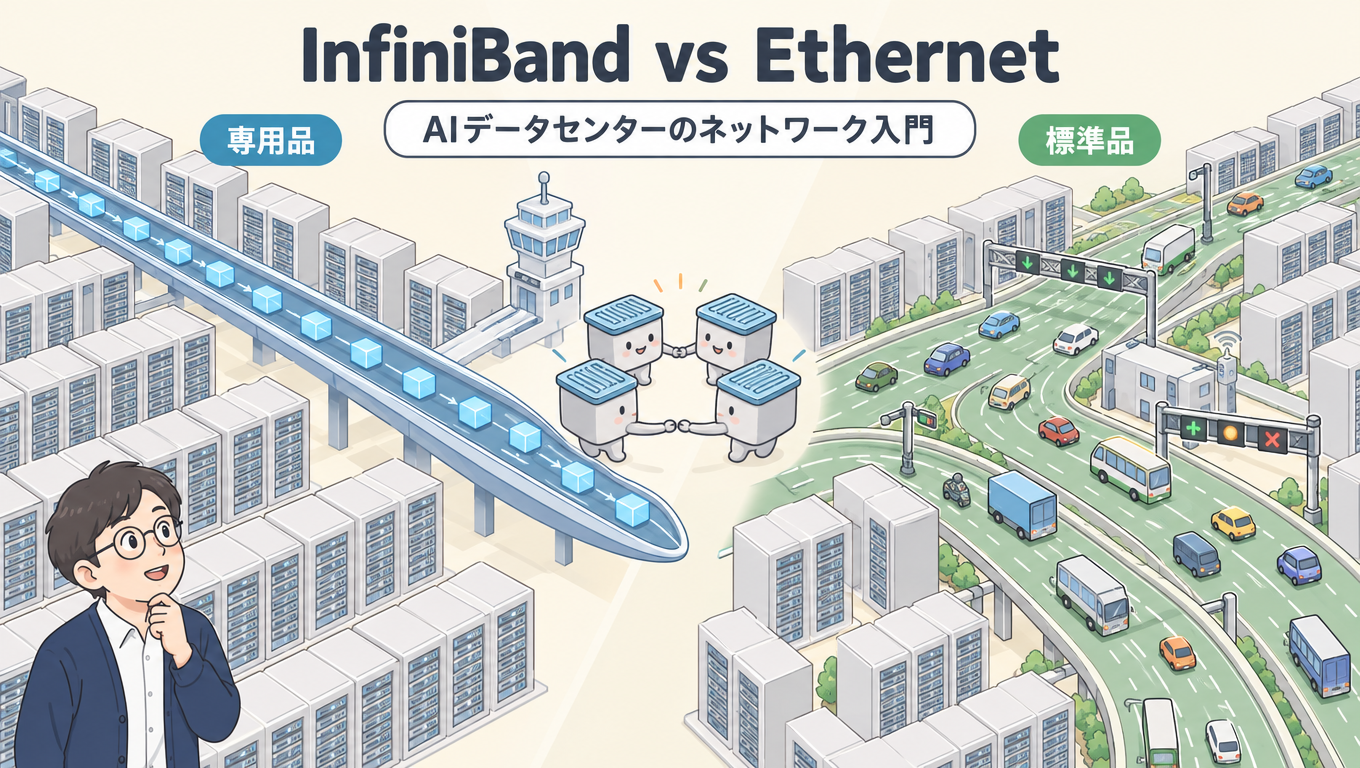
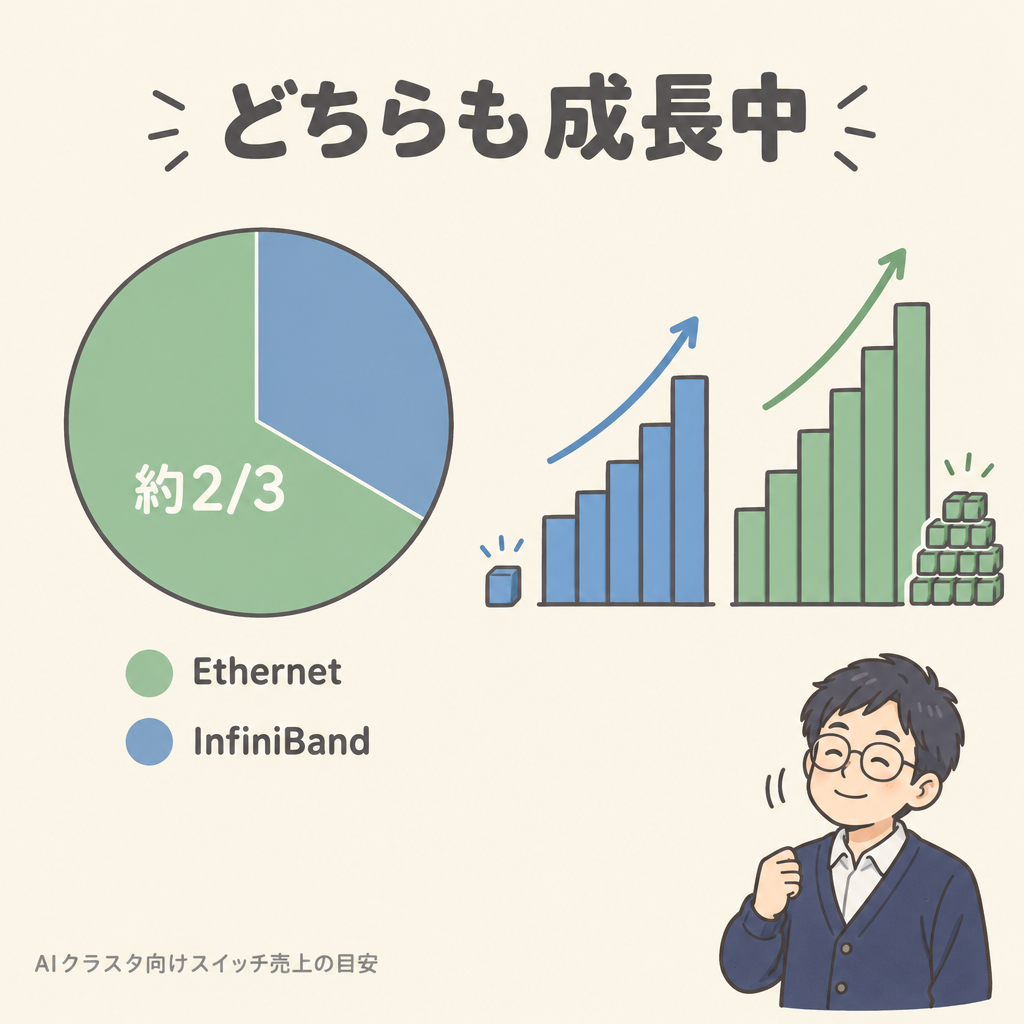
④ 市場では、InfiniBandの「完成された専用品」 と、Ultra Ethernet陣営の「開かれた標準品」 がぶつかっています。調査会社Dell’Oroによると、2026年1〜3月期はAIクラスタ向けデータセンタースイッチ売上の約3分の2をEthernet が占めました。一方でInfiniBandも前年同期比で3倍超に伸びています。「どちらかが消える」ではなく「両方伸びている」 のが現在地です。
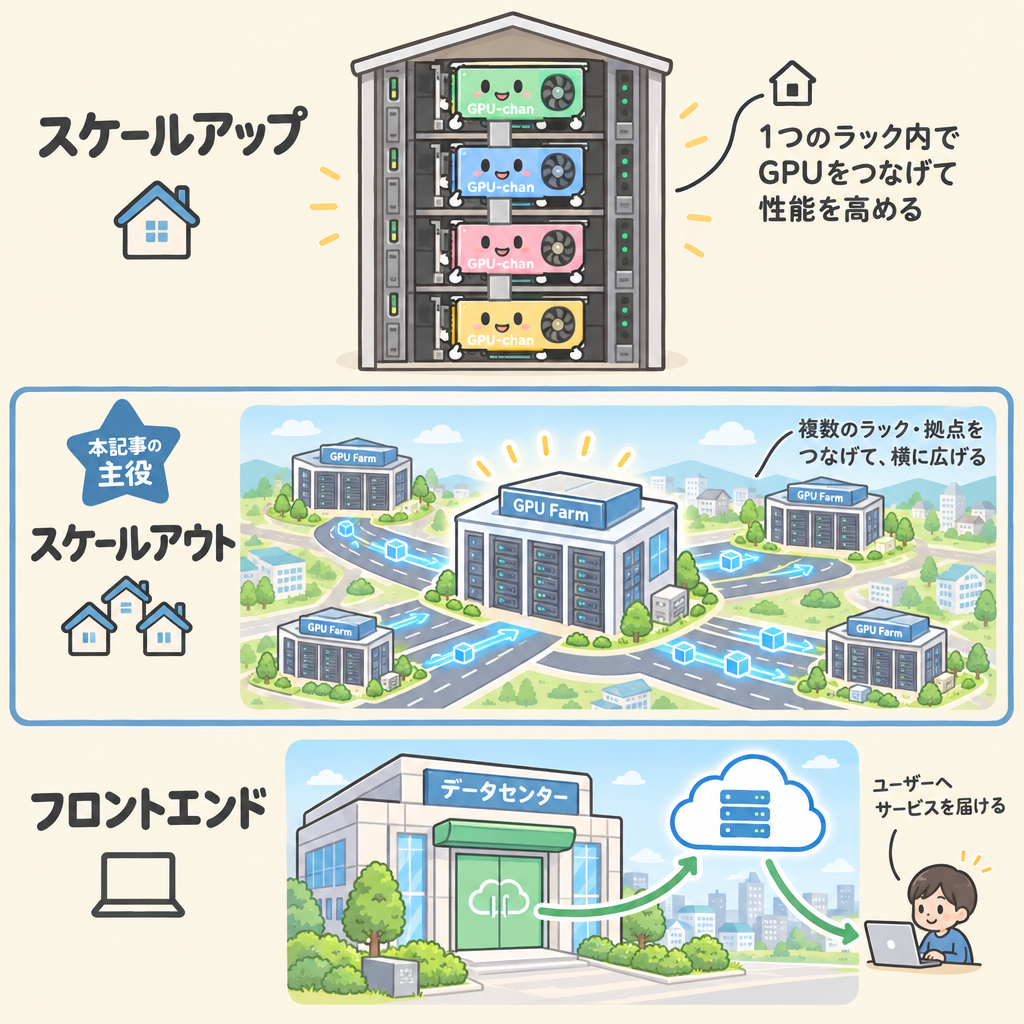
全体像:AIデータセンターには「3種類の道路」がある 「データセンターのネットワーク」とひとことで言っても、AIデータセンターでは役割のまったく違う道路 が何本も並んでいます。InfiniBandとEthernetの話をする前に、「どの道路の話なのか」をはっきりさせておきましょう。
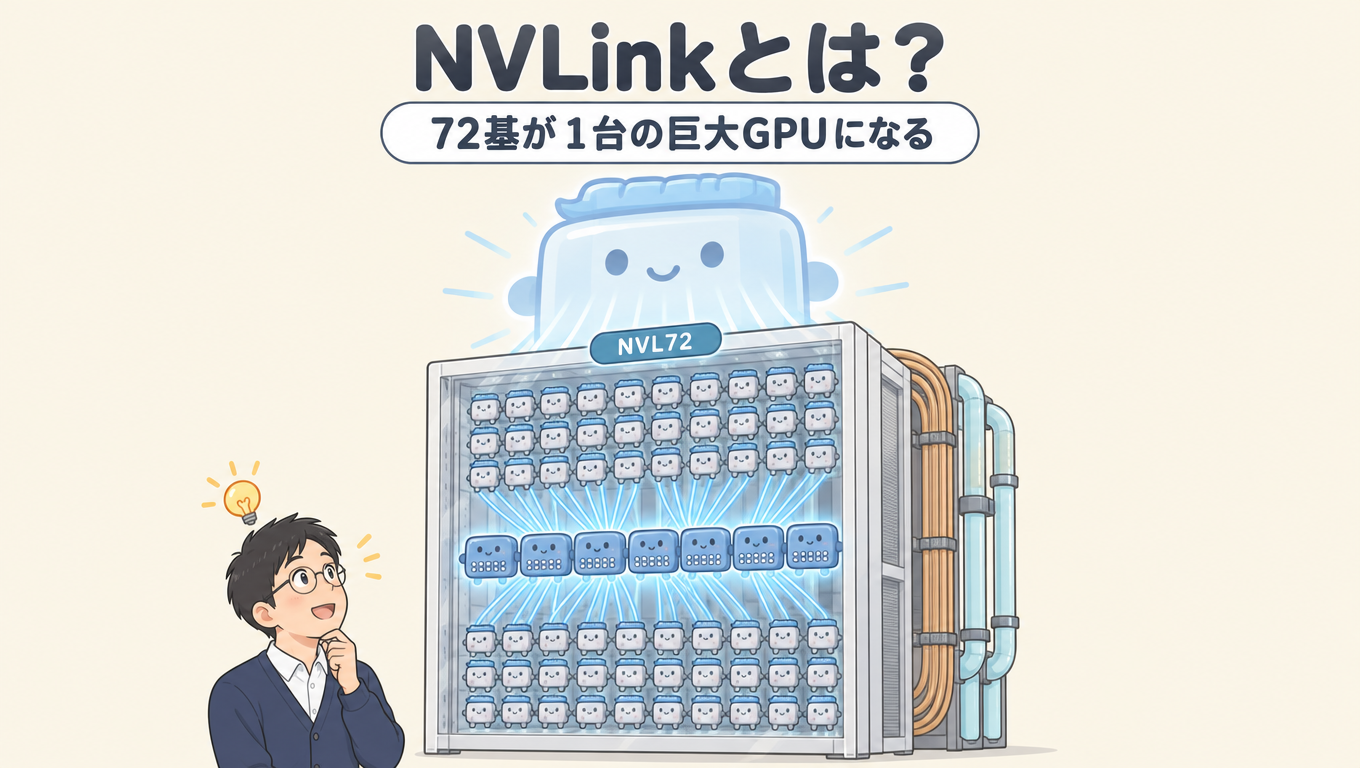
① スケールアップ
ラック内のGPU同士を超高速で直結する
代表例:NVIDIAのNVLink (GB200/GB300 NVL72など)
数十個のGPUを「1つの巨大GPU」として動かす
② スケールアウト(本記事の主役)
ラックとラック、数千〜数万GPUをつなぐ
「バックエンドネットワーク」とも呼ぶ
InfiniBand vs Ethernet の戦場はここ
③ フロントエンド
利用者・インターネット・ストレージとつなぐ
従来DCとほぼ同じ一般的なEthernet
管理用のネットワークも別にある
用語ミニ解説
スケールアップ :1つのまとまり(ラック)の中身を強くすること。
スケールアウト :まとまりの数を増やして横に広げること。
NIC(ニック) :サーバーについている「通信の出入り口」となる部品です。家でいえばLANの差し込み口にあたりますが、AI向けは1枚で400〜800Gb/s級の性能があります。
この記事で扱うのは、主に②スケールアウト です。GPUサーバーそのものの姿はGPUサーバーとは? 、ラック単位の話はGPUラックとは? で詳しく解説しています。
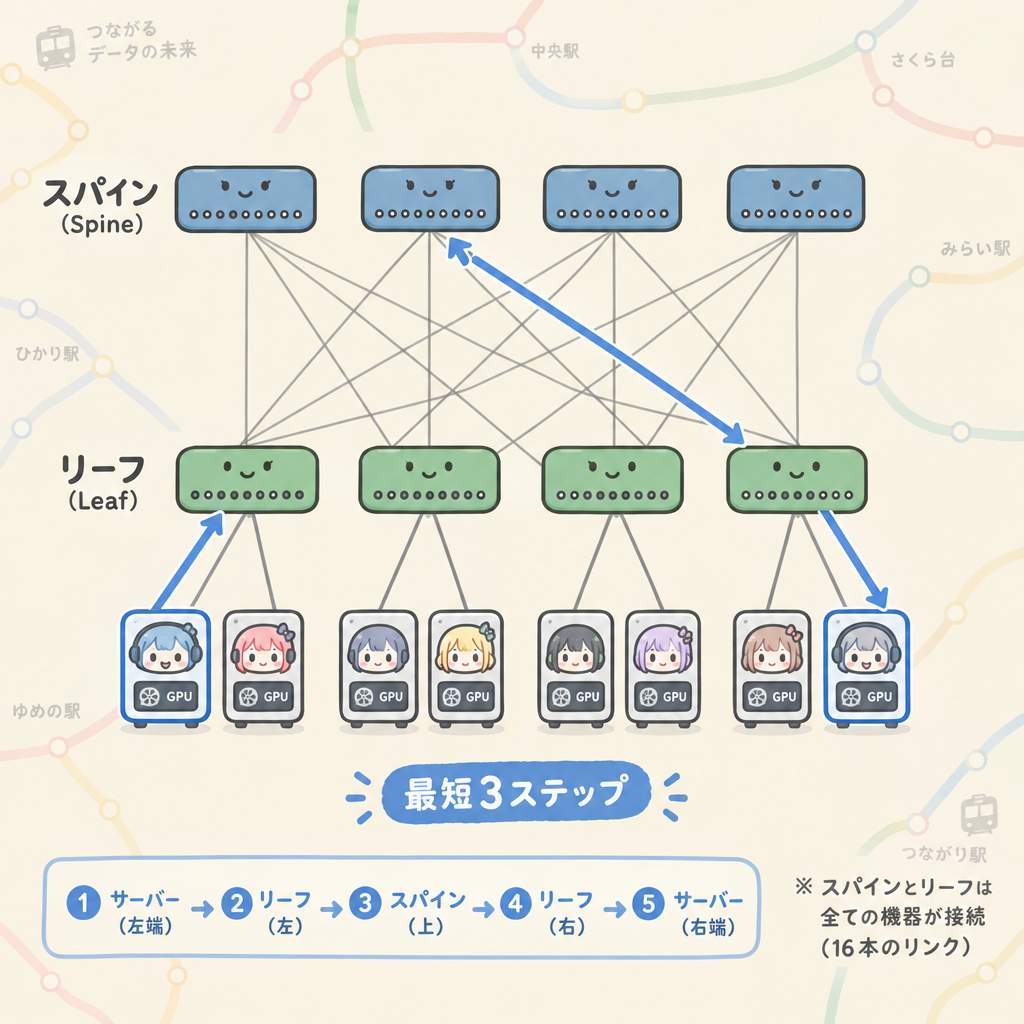
AIデータセンターの基本形「スパイン・リーフ構成」 何万台ものGPUをつなぐとき、ほぼ必ず使われる形が「スパイン・リーフ構成」 です。スパイン(spine)は「背骨」、リーフ(leaf)は「葉っぱ」という意味です。
スパイン・リーフ構成のイメージ図
▼ スパインスイッチ(背骨:リーフ同士を中継)
╳ ╳ ╳ ╳ ╳ ╳すべてのリーフが、すべてのスパインとつながる(網の目)
▼ リーフスイッチ(葉:サーバーが直接つながる)
| | | |
GPU
GPU
GPU
GPU
どのサーバー同士も「リーフ → スパイン → リーフ」 の最大3段で届きます。
たとえ話:駅と環状線
リーフは
各町の最寄り駅 、スパインは
すべての駅に乗り入れている何本もの環状線 です。どの町からどの町へも「最寄り駅 → 環状線 → 目的地の駅」の1回乗り換えで行けます。環状線が複数あるので、1本が満員でも別の線に乗れます。
AI向けの工夫「レール最適化(Rail-Optimized)」 AIのGPUサーバーでは、GPU1個にNIC1枚 がつくのが基本です。たとえば8GPUのサーバーなら、通信の出入り口が8つあります。そこで「各サーバーの1番GPUは全員リーフ1へ」「2番GPUは全員リーフ2へ」というように、同じ番号のGPUを同じ線路(レール)に並べる つなぎ方がよく使われます。同じ番号のGPU同士はスパインを通らずに話せるので、渋滞が起きにくくなります。
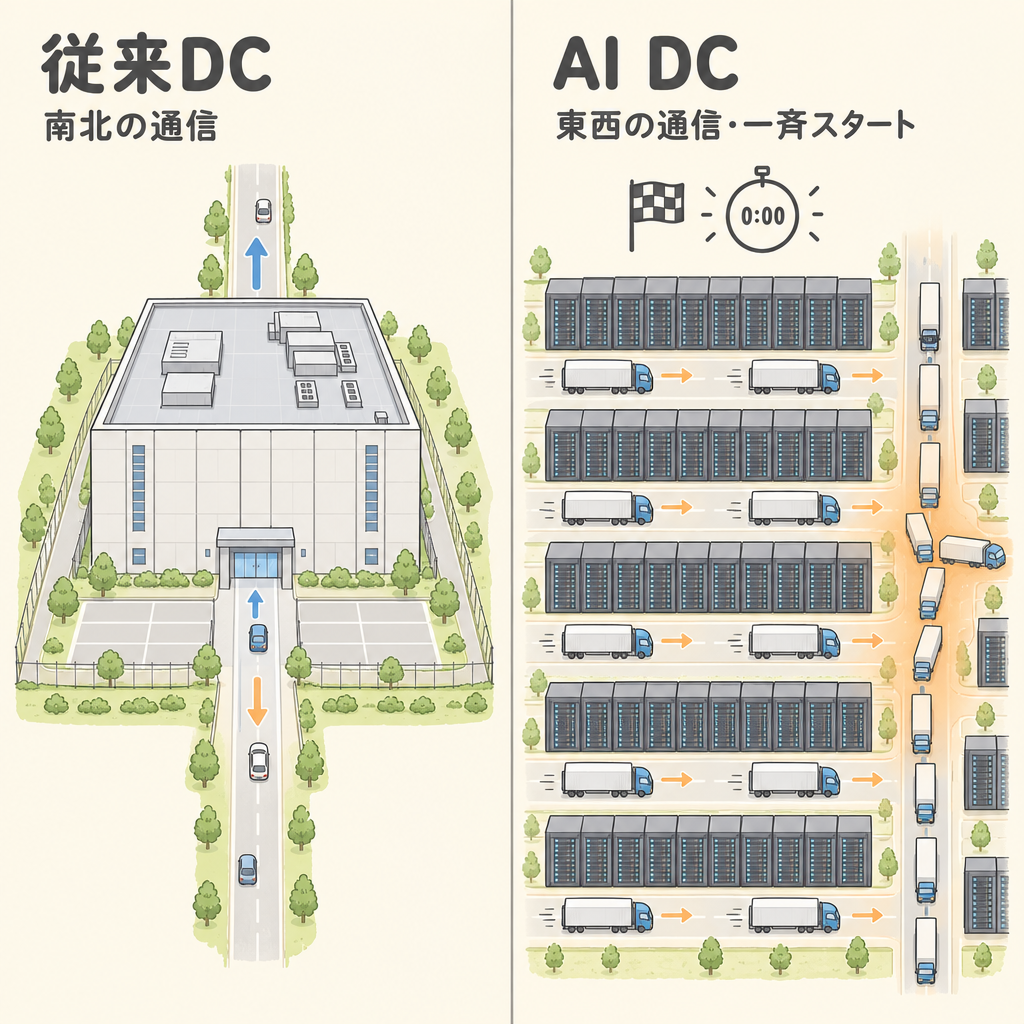
従来DC vs AI DC:ネットワークはここまで変わった 「DCのネットワーク」自体は昔からあります。AIで変わったのは、通信の量・向き・許されるミスの大きさ です。
比較項目
従来DC
AI DC(学習用)
何が変わった
サーバー1台の通信口
10〜25Gb/s × 1〜2本
400〜800Gb/s × 8本前後
桁違いに増加
通信の向き
南北(利用者 ⇔ サーバー)中心
東西(GPU ⇔ GPU)中心
DCの「中」が主戦場に
通信のタイミング
バラバラ(各利用者が好きな時に)
全GPUが一斉に
瞬間的な大渋滞が起きる
データ欠け(パケットロス)
送り直せばOK
全体の足を引っ張る
「落とさない」が必須に
重視する指標
平均的な速さ・コスト
最悪値(テールレイテンシ)
評価の物差しが変わった
ネットワークの本数
基本1系統(+管理用)
スケールアップ・バックエンド・フロントエンド・ストレージ・管理
多層化・複雑化
※数値は一般的な構成の目安です。GPU世代・構成によって異なります。
用語ミニ解説
レイテンシ :データが届くまでの「待ち時間」。
テールレイテンシ :たくさん通信したときの、
一番遅いグループの待ち時間 です。「平均は速いけど、たまに極端に遅い」の「たまに」の部分を指します。AIではこれが主役になります。
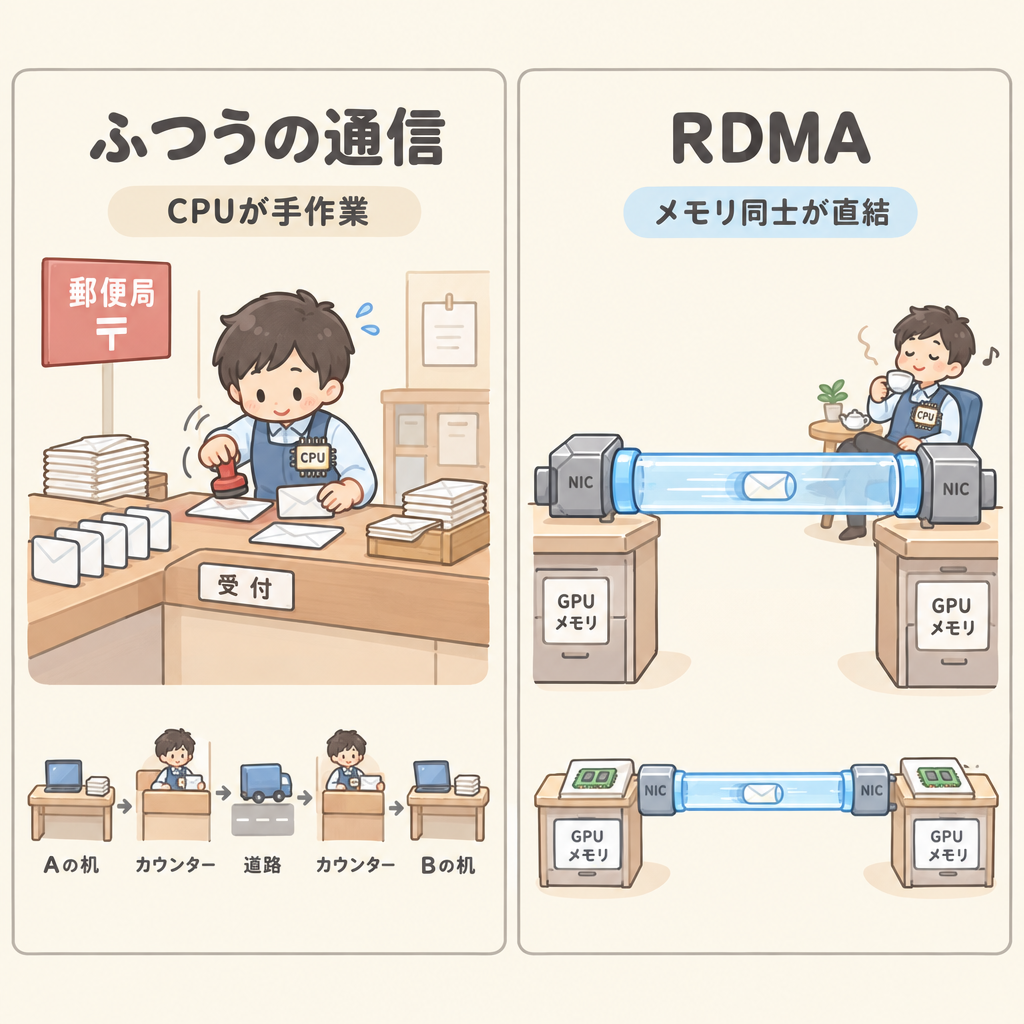
RDMAとは?「CPUを通さず、メモリ同士が直接話す」仕組み InfiniBandとEthernetの違いを理解するには、RDMA(Remote Direct Memory Access:遠くのメモリへの直接アクセス) を先に知っておくと近道です。AIのネットワークは、ほぼすべてこのRDMAを前提に作られています。
ふつうの通信(TCP/IP)
送り手のメモリ
↓
CPU・OSがデータをコピー&包装
↓
NIC → ネットワーク → NIC
↓
CPU・OSが開封&コピー
↓
受け手のメモリ
途中でCPUが何度も手作業 をするため、時間がかかり、待ち時間もばらつきます。
RDMA
送り手のメモリ(GPUメモリ)
↓ 直接
NICが自分で読み出す
↓ ネットワーク
NICが自分で書き込む
↓ 直接
受け手のメモリ(GPUメモリ)
CPUは素通り(手を動かさない)
NICがメモリ同士を直結 するので、速く、待ち時間も安定します。
たとえ話:郵便局の窓口 vs 専用の気送管
ふつうの通信は、手紙を
郵便局の窓口(CPU) に持っていき、係の人が封筒に入れて宛名を書き、相手の町の郵便局でまた開けて届ける仕組みです。窓口が混めば待たされます。
RDMAは、相手の机の引き出しまでつながった
専用のパイプ で書類を直接送り込むイメージです。窓口の人(CPU)は何もしなくてよいので、そのぶん本業に集中できます。
GPUDirect RDMA:GPUのメモリ同士が直接話す AIでは、RDMAをもう一歩進めたGPUDirect RDMA が使われます。NICがCPU側のメモリも経由せず、GPUに載ったメモリ(HBM)から直接 データを出し入れします。「AIの計算結果はGPUの中にある」ので、それをいちいちCPU側に移さないことが大きな時短になります。
同じRDMAでも「道路の造り」が違う
InfiniBandのRDMA
RDMAを前提にゼロから設計 されています。送る前に「受け手に空きがあるか」を確かめる仕組み(クレジット方式)があるので、そもそもデータがあふれて捨てられない 設計です。
EthernetのRDMA(RoCE v2)
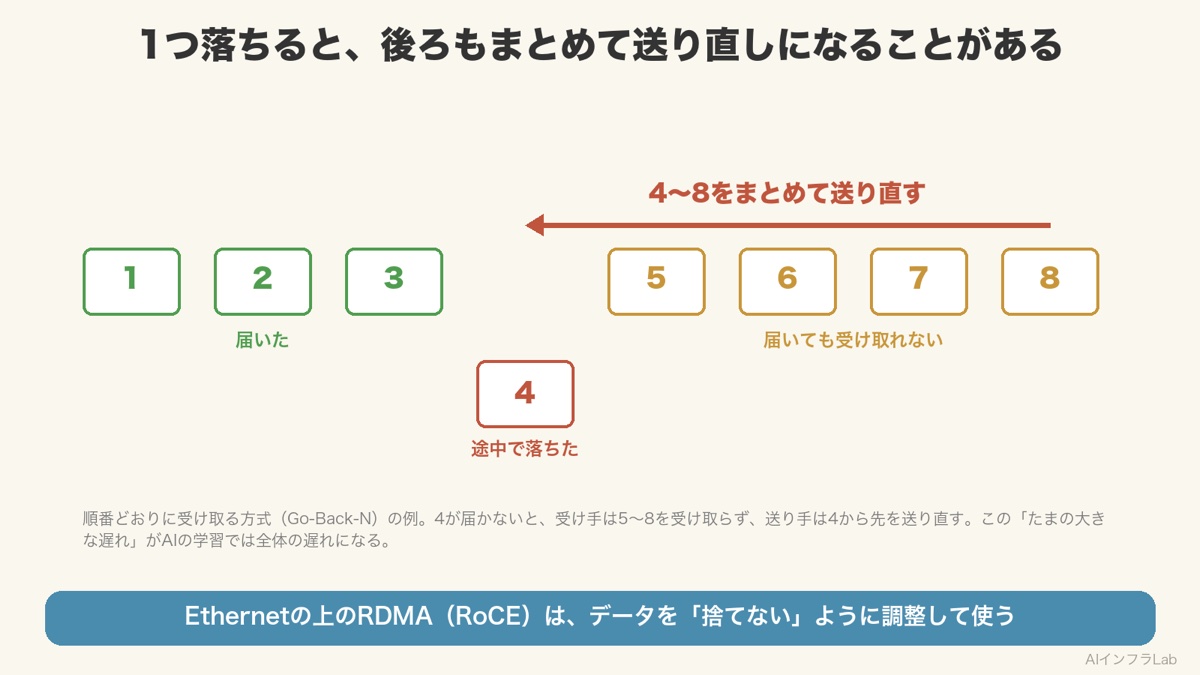
Ethernetの上でRDMAを動かす方式です。Ethernetは本来「混んだら捨てる」 設計なので、PFC やECN といった追加の仕組みで「捨てない道路」に作り変えます。その調整には腕前が必要です。
用語ミニ解説
RoCE(ロッキー) :RDMA over Converged Ethernet。EthernetでRDMAを使う規格です。
PFC :スイッチが「今いっぱいだから一旦止めて」と手前の機器に合図する仕組み。
ECN :「混み始めたよ」と送り手に知らせて、送る速さを落としてもらう仕組み。
ロスレス :データ(パケット)を途中で捨てないこと。
なぜ「捨てない」ことがそこまで大事なのか? 待ち時間が一気に跳ね上がります 。この「たまに起きる大きな遅れ」がAIでは致命的になります。理由は次の章のAll-Reduce で説明します。
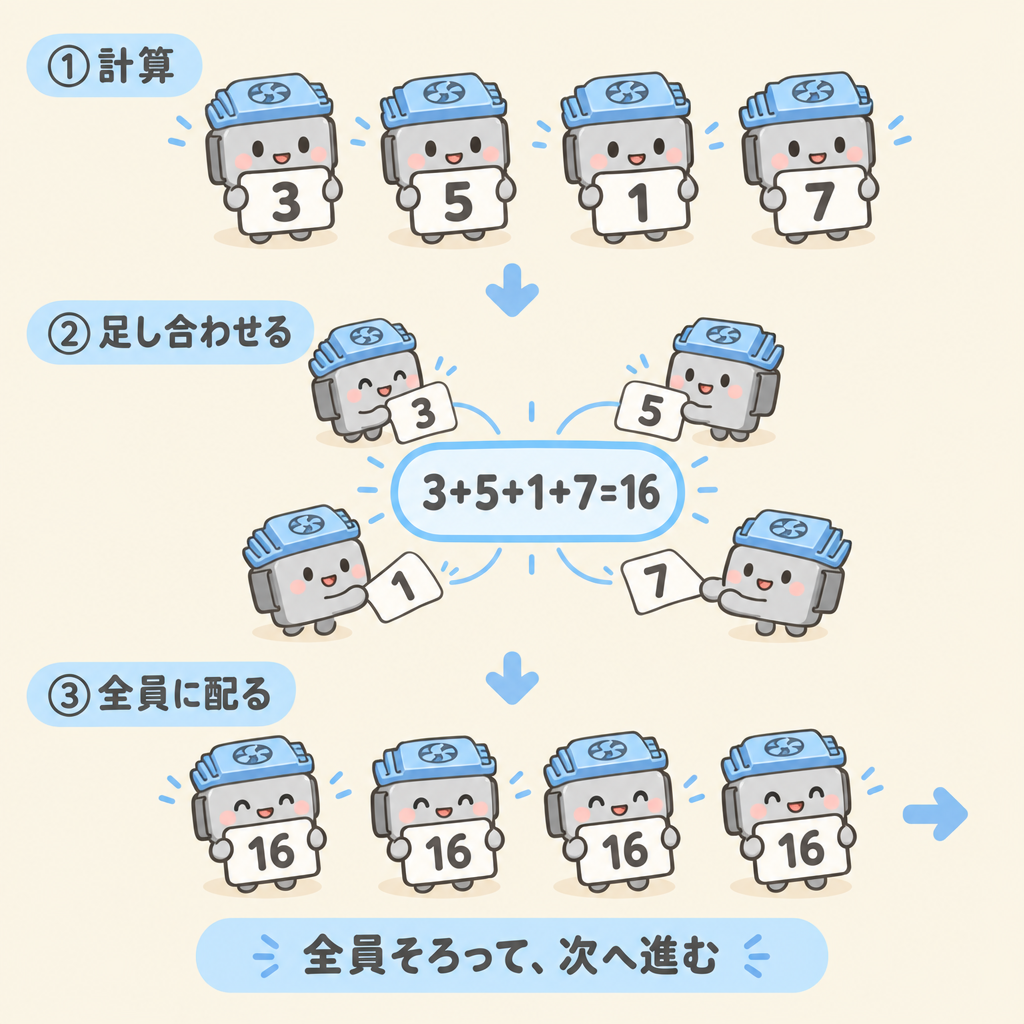
核心:なぜAIだけネットワーク要件が特殊なのか ―「All-Reduce」 ここがこの記事でいちばん大事な部分です。AIの学習では、大量のデータを何千個ものGPUに分けて 同時に計算させます。ただし、各GPUが出した「修正の方向(勾配)」はバラバラなので、全員分を足し合わせて平均し、その結果を全員に配る 必要があります。これがAll-Reduce(オール・リデュース) です。
All-Reduceを4つのGPUで図解
STEP 1:それぞれが自分の担当データで計算(数字=計算結果)
STEP 2:全員でネットワーク越しに足し合わせる(Reduce) 3+5+1+7=16
STEP 3:合計(または平均)を全員に配る(All)
全員が同じ「16」を持てたら、そろって次の計算へ進みます。1台でも数字が届かなければ、残り全員は待つしかありません。
実際には数字1個ではなく、モデルの大きさ分のデータが動きます。単純計算では、700億パラメータのモデルなら1回で約140GB (1パラメータ2バイトとして)の勾配をやりとりします。しかもこれを学習中に何十万回も 繰り返します。(※実際はデータの分け方の工夫により、GPU1台あたりの通信量は構成によって変わります)
たとえ話:団体旅行のバス
1万人の団体旅行で、観光地ごとに「全員がバスに戻ったら出発」というルールがあるとします。9,999人が5分前に戻っていても、
1人がお土産屋で10分遅れたら、全員が10分待ちます 。
All-Reduceはまさにこの状態です。そして観光地(学習ステップ)は何十万か所もあります。
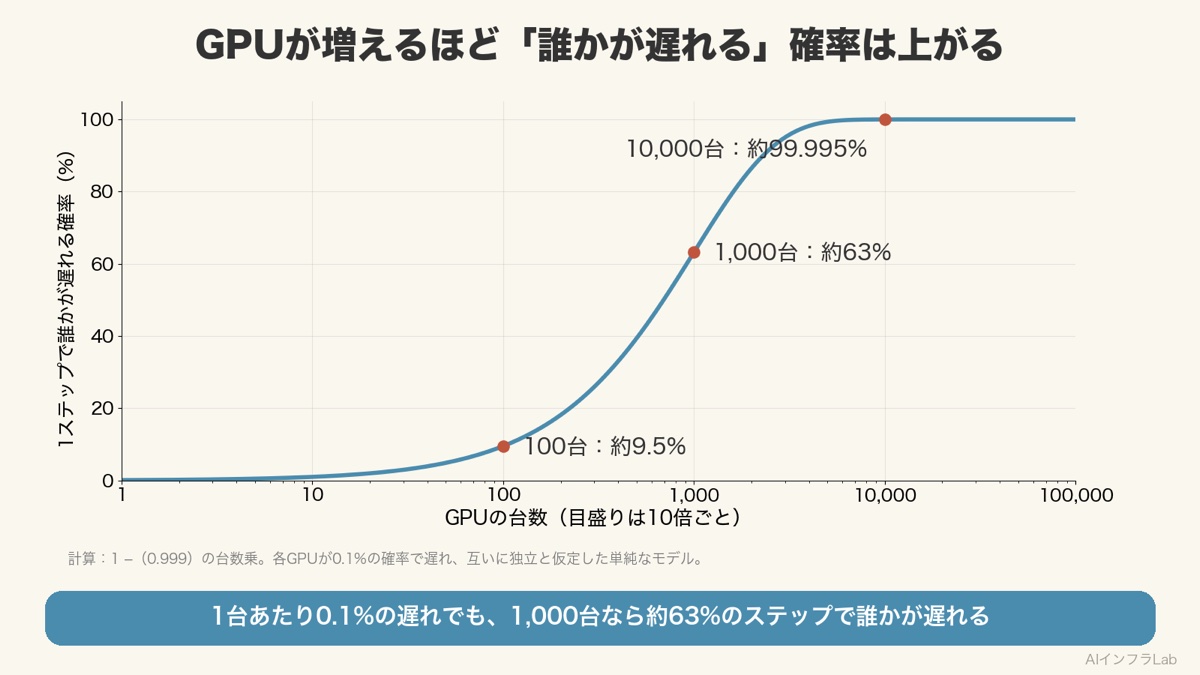
GPUが増えるほど「誰かが遅れる確率」は跳ね上がる ここで、簡単な確率の思考実験をしてみます。各GPUの通信が、1ステップの中で「たまたま遅れる」確率を0.1%(1,000回に1回) とします。1台だけで見れば、ほとんど気にならない数字ですよね。ところが、全員そろうまで待つ All-Reduceでは「少なくとも1台が遅れる確率」が問題になります。
少なくとも1台が遅れる確率 = 1 −(0.999)GPU台数
GPU台数
1ステップで誰かが遅れる確率
意味
100台 約9.5% 10回に1回ほど待たされる 1,000台 約63% 過半数のステップで待たされる 10,000台 約99.995% ほぼ毎回、誰かが遅れる 100,000台 ほぼ100% 「最悪値」=「毎回の速さ」になる
※各GPUの遅れが互いに独立に起きると仮定した単純化モデルです。実際の遅れの確率はシステムによって異なります。
ここが本質: 規模が大きくなると、「めったに起きない遅れ」が「毎回起きる遅れ」に変わります 。だからAIのネットワークでは、平均の速さより「ばらつきの小ささ(テールレイテンシ)」 が性能を決めます。通信を待っている間、1台数百万円のGPUが何もせず止まっています。
AIの通信は「渋滞を起こしやすい」性質を持つ
一斉に始まる
全GPUが同じ瞬間に通信を始めるので、ふだんは空いている道が一瞬で満杯になります。
巨大な流れが少数
大きなデータの流れが少数あるだけなので、ルートの振り分け(ECMP)で偶然同じ道に集中すると大渋滞になります。
段数が多い
代表的な「リング方式」では、GPUが増えるほど受け渡しの回数が増え、1回ごとの遅れが積み重なります。
ECMP :複数ある同じ長さの道に、通信を振り分ける仕組み。小さな通信がたくさんあればうまく散らばりますが、巨大な通信が少しだけだと「くじ引き」で偏りやすくなります。NCCL(ニッケル) :NVIDIAが提供する、All-Reduceなどの「集団通信」を行うソフトウェアです。
InfiniBandとEthernetの違いを8つの視点で比較 ここまでの話を踏まえると、両者の違いは「速さ」よりも「生まれ育ち」と「思想」 の違いだと分かります。
視点
InfiniBand
Ethernet(AI向け)
① 生まれ 2000年ごろ。スパコン・高性能計算(HPC)向けの専用規格 1980年代。オフィスや家庭のLANから広がった汎用規格 ② 供給企業 実質NVIDIA(旧Mellanox)1社 Broadcom・Arista・Cisco・NVIDIA・Celesticaなど多数 ③ データを捨てるか 設計段階で捨てない (クレジット方式)本来は捨てる。PFC・ECNなどで後から捨てないように する ④ RDMA 最初から組み込み済み RoCE v2で対応。Ultra Ethernetで刷新中 ⑤ 渋滞対策 混雑に応じた自動迂回、スイッチ内での足し算(SHARP) 製品ごとに独自機能を搭載(NVIDIA Spectrum-Xなど)。Ultra Ethernetで標準化を進める ⑥ 管理・運用 専用の管理ソフトで一括制御。専門人材が必要 既存DCの運用ノウハウ・人材を流用しやすい ⑦ 調達・コスト 1社依存(ロックイン)になりやすい 競争があり、価格交渉・分散調達がしやすい ⑧ 得意な場面 「すぐ・確実に」性能を出したい一体型の学習クラスタ、HPC 自社で作り込めるハイパースケーラーの超大規模クラスタ
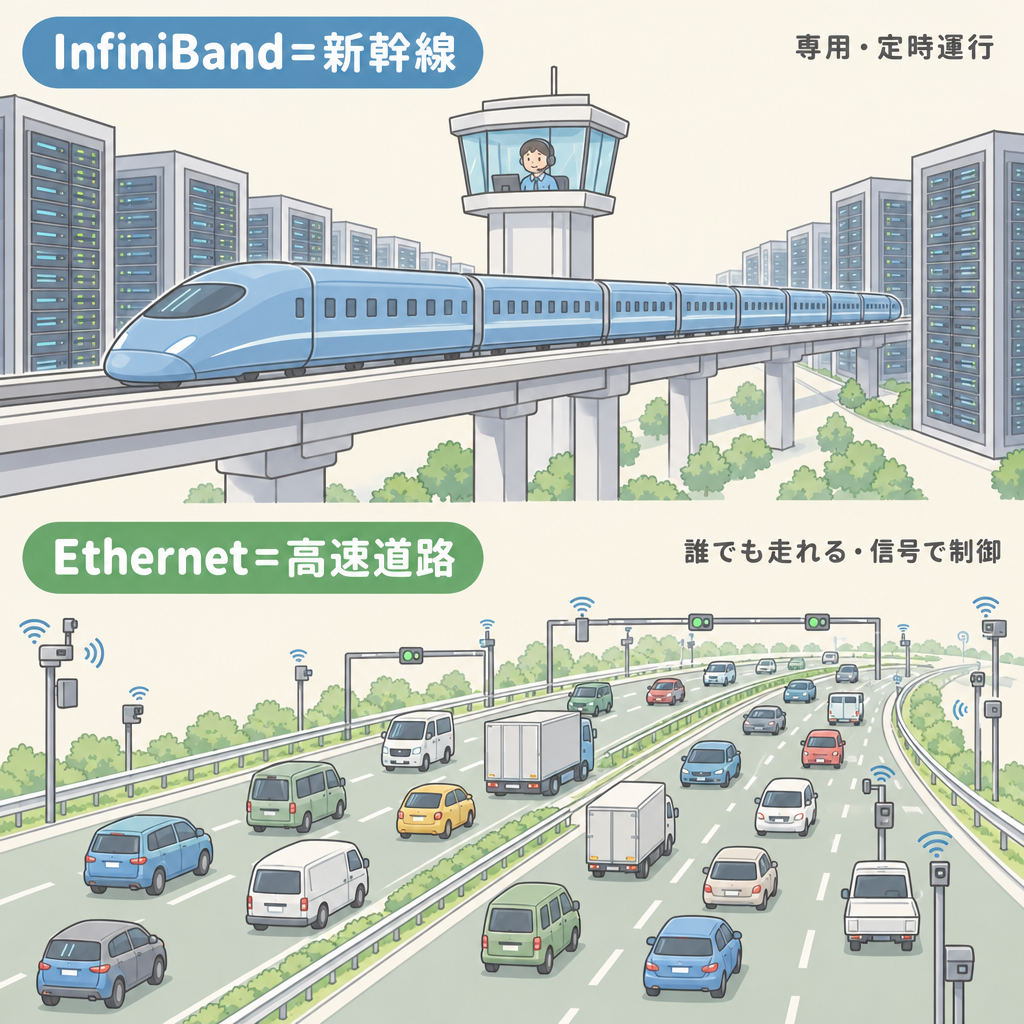
たとえ話:新幹線 vs 高速道路
InfiniBand=新幹線 です。専用の線路と中央の運行管理があるので、時刻表どおりに走ります。ただし線路も車両も1社の規格です。
Ethernet=高速道路 です。どのメーカーの車でも走れて、道路も誰でも造れます。ただ、そのままでは渋滞や事故で遅れが出るので、AI用には「全車に自動運転と信号制御を入れて、新幹線並みの定時運行を目指す」改造をしています。その改造の標準ルールづくりが、次に紹介する
Ultra Ethernet です。
SHARP :NVIDIAのInfiniBandスイッチにある機能で、All-Reduceの「足し算」をスイッチの中で済ませ、通信の量を減らします。「道路が荷物を運ぶだけでなく、途中で仕分けもしてくれる」イメージです。
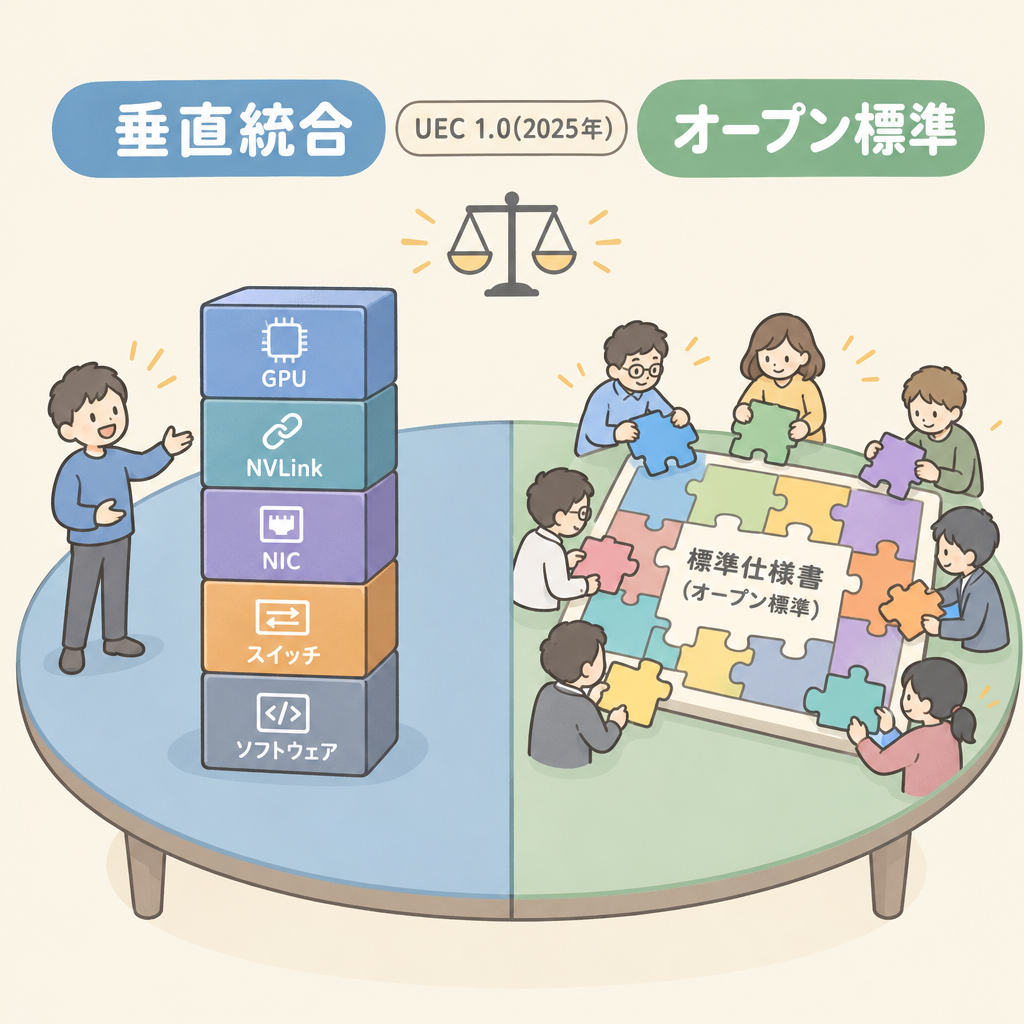
対立構図:「NVIDIAの専用品」vs「Ultra Ethernet陣営の標準品」 ニュースでは「InfiniBand vs Ethernet」と書かれがちですが、本当の対立軸は「1社が全部そろえて最適化する」か「みんなで標準を決めて部品を持ち寄る」か です。しかもNVIDIAは、InfiniBand(Quantum)とEthernet(Spectrum-X)の両方を売っている 点が、この構図を分かりにくくしています。
NVIDIA陣営(垂直統合)
GPU+NVLink+NIC+スイッチ+ソフト(NCCL)を一式で提供
InfiniBand:Quantum-X800 (800Gb/s×144ポート、SHARP v4搭載)Ethernet:Spectrum-X (AI向けに改造したEthernet。2025年10月にMeta・Oracleの採用を発表)強み:「買えばすぐ性能が出る」完成度
Ultra Ethernet陣営(オープン標準)
2023年設立のUltra Ethernet Consortium(UEC)。Linux Foundation傘下
創設メンバー:AMD・Arista・Broadcom・Cisco・Eviden・HPE・Intel・Meta・Microsoft
2025年6月にUEC仕様1.0 を公開(RDMA・渋滞制御などを刷新)
強み:複数社から調達でき、1社依存を避けられる
対立の流れ(時系列)
2000年ごろ
InfiniBand規格が誕生。スパコンの世界で広がる
2019年3月発表 → 2020年4月完了
NVIDIAがInfiniBand最大手のMellanoxを約69億ドルで買収
2023年7月
Ultra Ethernet Consortium設立を発表。NVIDIA自身も2024年に参加
2024年3月
Metaが2.4万GPU級のクラスタを2つ公開(1つはRoCE=Ethernet、1つはInfiniBand)。Llama 3の学習はEthernet側で実施
2025年10月
Meta・OracleがNVIDIA Spectrum-X(Ethernet)の採用を発表
2026年6月
Dell’Oroが、1〜3月期のAIクラスタ向けスイッチ売上の約3分の2がEthernetと発表。InfiniBandも800Gb/s品の立ち上がりで3倍超に
2026年8月
Metaが「100万GPU規模のEthernet」向けの独自転送方式「MetaRoCE」を発表
約2/3
AIクラスタ向けDCスイッチ売上に占めるEthernetの割合
出典:Dell’Oro Group(2026年1〜3月期)
148億ドル
NVIDIAのデータセンター向けネットワーク売上(1四半期・過去最高)
出典:NVIDIA 2027年度第1四半期決算(2026年2〜4月)※NVLink等を含む
1.6Tb/s
次の主役となるスイッチ速度(2026年後半に本格化見込み)
出典:Dell’Oro Group(2026年6月)
ひとことメモ: 148億ドルは1ドル150円換算で
約2.2兆円 です。3か月で、日本の大手電機メーカー1社の年間売上に迫る規模をネットワークだけで稼いでいる計算になります。「GPUの会社」というより「AIの工場一式を売る会社」と見たほうが実態に近いです。詳しくは
NVIDIA本体の徹底分析 で解説しています。
2026年9月の最新の調査: Dell’Oro Groupの2026年4〜6月期の調査では、AI向けのバックエンドのネットワーク(GPUどうしをつなぐ側)のスイッチ売上が、初めてフロントエンド(利用者やストレージとつなぐ側)を上回りました 。Ethernetのスイッチの売上ではCelesticaが首位、NVIDIAが僅差の2位で、1.6Tb/sのスイッチはサンプル出荷が始まり、2026年後半に立ち上がる見込みです。
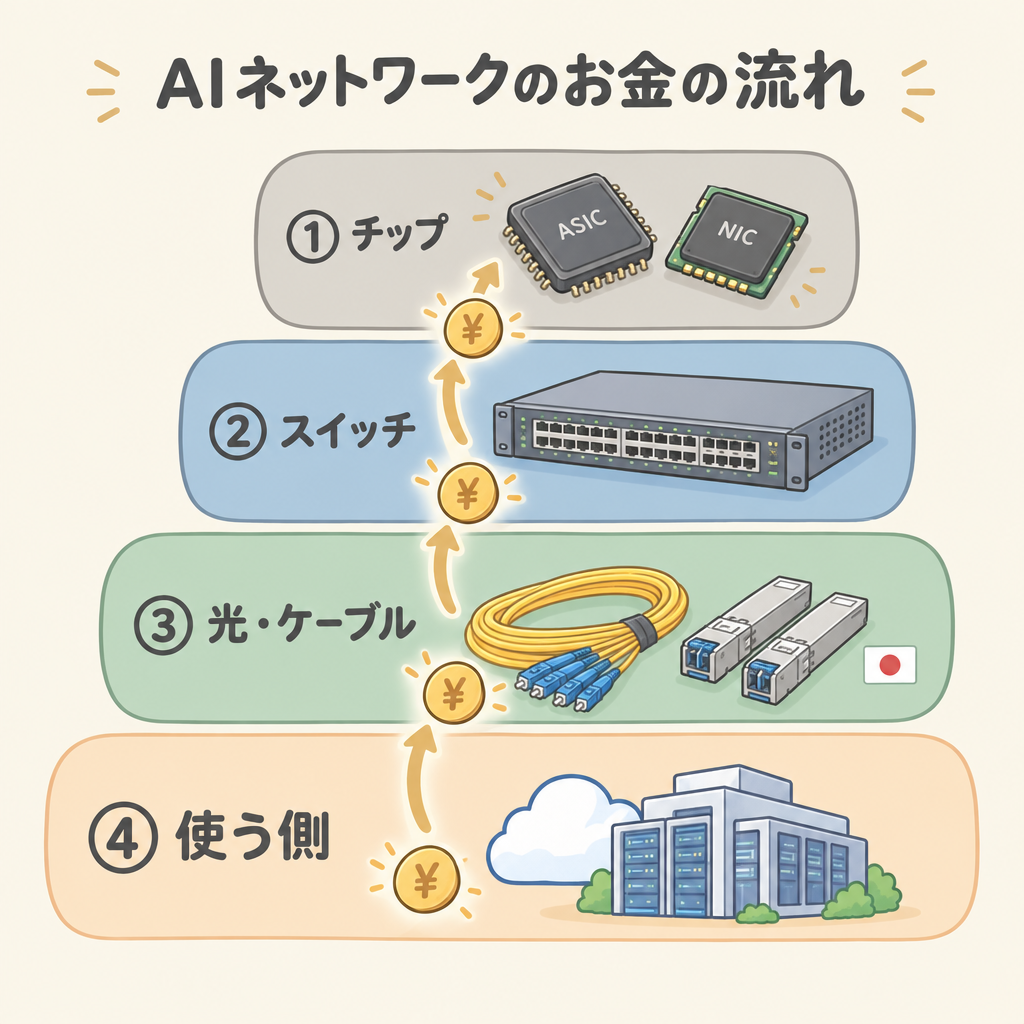
投資家向け:AIネットワークのお金の流れを4層で整理 「InfiniBandかEthernetか」はどちらが勝っても、通信量そのものが増え続ける ことに変わりはありません。どの層に誰がいるかを地図にしておくと、ニュースの重みを判断しやすくなります。
①チップ(スイッチASIC・NIC)
NVIDIA (NVDA):InfiniBand・Spectrum-X・ConnectX NICBroadcom (AVGO):Ethernetスイッチチップ「Tomahawk」系の大手Marvell (MRVL):スイッチ・光通信向けチップAMD (AMD):UEC対応のAI向けNIC
②スイッチ機器
Arista Networks (ANET):ハイパースケーラー向けEthernetの代表格Celestica (CLS):自社ブランドなしの受託型スイッチ。2026年1〜3月期のAI向けEthernetで首位(Dell’Oro)Cisco (CSCO):同期間でシェア拡大が最大
③光・ケーブル(日本企業の出番)
フジクラ (5803):DC内の高密度光ファイバー・コネクタ古河電工 (5801):光トランシーバー向けレーザー光源住友電工 (5802):化合物半導体・光デバイスCoherent (COHR):光トランシーバー大手
④使う側(方式を選ぶ人)
Meta (META)/Microsoft (MSFT)/Oracle (ORCL):大口の買い手CoreWeave (CRWV):GPU専業クラウド(ネオクラウド)さくらインターネット (3778):国産GPUクラウド
投資判断の前に: この表は「構造上、恩恵を受けやすい位置」を示したもので、特定銘柄を推奨するものではありません。「NVIDIAやMetaの取引先」という言葉だけでは利益率は分かりません(→
「大手の取引先」という情報の読み方 )。発表ベースの期待と、受注・売上に表れた実需は分けて見ましょう(→
実需と思惑を見分ける手順 )。
③の光部品の会社については、フジクラ ・古河電工 ・住友電工 の企業分析で詳しく扱っています。NVIDIAを中心とした全体の取引構造はNVIDIA AI半導体のサプライチェーン全マップ が参考になります。
あなたにとって、この話は何を意味するか
個人投資家の方へ
決算で見るべきなのは「InfiniBand対Ethernetの勝敗」ではなく、
AI向けネットワーク全体がどれだけ伸びているか と、
その中で誰の取り分が動いているか です。Dell’Oroのデータでは、同じ四半期の中でも上位ベンダーの順位が入れ替わっています。先行指標の読み方は
受注残・稼働率・BBレシオ が参考になります。
理工系学生の方へ
AIネットワークは情報系(通信プロトコル・分散処理)と電気系(高速信号・光)の交差点 です。「All-Reduceの通信時間をどう縮めるか」は、アルゴリズム・スイッチ設計・光部品のどこからでも取り組めるテーマで、就職先の幅も広い分野です。
電気・設備系の技術者の方へ
ネットワークは「IT側の話」に見えますが、銅ケーブルは数メートルしか届かない という物理の制約があります。これがラックの配置を決め、GPUの密集を生み、電力密度と液冷の必要性 に直結します。光トランシーバーの消費電力と発熱も、ラック全体の熱計算で無視できない大きさです。
よくある誤解を4つ解いておきます
誤解1:「InfiniBandはもう古く、Ethernetに負けた」
割合ではEthernetが上回っていますが、InfiniBandも2026年1〜3月期に売上が3倍超に伸びています。市場全体が急拡大しているので「両方伸びている」 が正確です。
誤解2:「帯域(Gb/s)が大きいほうが速い」
800Gb/s同士でも、渋滞時のばらつき で実際の学習速度は大きく変わります。AIでは「最高速度」より「最悪の遅れの小ささ」が重要です。
誤解3:「InfiniBand=NVIDIA、Ethernet=反NVIDIA」
NVIDIAはEthernet(Spectrum-X)でもAI向けスイッチの上位ベンダーです。対立軸は企業ではなく「垂直統合かオープン標準か」 です。
誤解4:「NVLinkとInfiniBandは同じもの」
NVLinkはラック内(スケールアップ) 、InfiniBand・Ethernetはラック間(スケールアウト) の道路です。役割も距離も違います。なお、スケールアップ側でも「NVLink vs オープン規格(UALinkなど)」という似た対立があります。
まとめ:AIのネットワークは「全員の歩調」を守る仕組み
AI DCのネットワークはスケールアップ・スケールアウト・フロントエンド の多層構造。InfiniBand vs Ethernetの戦場はスケールアウト スパイン・リーフ構成 。AI向けには「レール最適化」を組み合わせるRDMA でCPUを通さずGPUメモリ同士が直接話す。そのためデータを「捨てない」ことが前提になるAll-Reduce は全員そろうまで待つ仕組み。規模が大きいほどばらつき(テールレイテンシ) が性能を決めるNVIDIAの垂直統合 vs Ultra Ethernetのオープン標準 。市場全体が拡大しており、両方が伸びている
もっと深く知りたい方へ:4大ボトルネック別の専門ガイド
AIデータセンターは「計算・電力・冷却・通信」の4つで詰まります。気になる扉から進んでください。
よくある質問(FAQ)
Q1. InfiniBandとは何ですか?
InfiniBandは、スーパーコンピュータやAIデータセンターで計算機同士をつなぐための専用の高速通信規格です。データを途中で捨てない設計と、CPUを通さずにメモリ同士が直接やりとりするRDMAを標準で備えています。現在の主な供給元はNVIDIA(旧Mellanox)です。
Q2. InfiniBandとEthernetの一番大きな違いは?
思想の違いです。InfiniBandは「最初からデータを落とさない」専用設計で、1社がまとめて最適化しています。Ethernetは「混んだら捨てて送り直す」汎用設計を、PFCやECNなどの追加機能でAI向けに作り変えたもので、多くの企業が製品を供給しています。
Q3. All-Reduceとは何ですか?
AIの学習で、各GPUが計算した結果(勾配)を全員分足し合わせ、その結果を全GPUに配り直す処理です。全員がそろうまで次に進めないので、1台の通信の遅れが全体の遅れになります。
Q4. RoCEとは何ですか?
RDMA over Converged Ethernetの略で、Ethernetの上でRDMAを使えるようにした規格です。AI向けEthernetの多くはRoCE v2を使っています。性能を出すには、データを捨てないようにするネットワークの細かい調整が必要です。
Q5. Ultra Ethernetとは何ですか?
AMD・Broadcom・Arista・Cisco・Meta・Microsoftなどが参加するUltra Ethernet Consortium(UEC)が定めた、AI・HPC向けの新しいEthernet規格です。2025年6月に仕様1.0が公開され、RDMAや渋滞制御を最初から作り直しています。
Q6. 結局、どちらが勝つのですか?
2026年時点では、AIクラスタ向けスイッチ売上の約3分の2をEthernetが占めています(Dell’Oro)。一方、InfiniBandも「すぐ確実に性能を出したい」用途で伸びています。市場全体が急拡大しているので、当面は用途に応じた使い分けが続くと見るのが自然です。
Q7. InfiniBandの読み方は?
インフィニバンドと読みます。「無限(infinite)」と「帯域(band)」を組み合わせた名前で、スーパーコンピュータやAIの計算機どうしをつなぐ通信の規格です。
Q8. InfiniBand over Ethernet(Ethernetの上でInfiniBandの仕組みを使う)とは?
InfiniBandと同じRDMA(メモリどうしの直接のやりとり)をEthernetの上で動かす方式が RoCE(RDMA over Converged Ethernet)です。AI向けのEthernetの多くは RoCE v2 を使っています。
この記事のテーマを、本でもっと深く PR(アフィリエイト広告)
ネットワークの両端にあるGPUの側から、理解を深めたい方に。本書(技術評論社)は、GPUの超並列処理の仕組みやデバイスメモリ、CPUとGPU間のデータ伝送を解説した技術書で、RoCE(Remote DMA on Converged Ethernet)のコラムも収めています。
楽天ブックス
¥3,608 (2026/10/18 08:16時点 | 楽天市場調べ)
ポチップ
S
シラス
電験三種・QC検定1級 / メーカーでパワエレ設計・品質保証 実務10年
メーカーで回路設計と生産技術(品質改善)に携わってきた経験をもとに、AIインフラを支える半導体・電力・冷却の仕組みを、図解でやさしく解説しています。
テーマ別に、もっと深く学ぶ 気になるところから読んでも大丈夫です。どの記事も、はじめての方にもわかるように図解で書いています。
AIデータセンターをもっと深く
つまずきやすい「違い」を解決
あわせて知りたい、隣のテーマ

 ポチップ
コメント