「学習はクラウド、推論はエッジ」──この説明、もう何度も読みましたよね。
たしかに教科書的には正解です。でも、この一文で分かった気になった直後に、こんな疑問が湧いてきませんか。
・じゃあ「エッジ」ってどこまでの処理を指す のか?データセンター需要は減るのでは?
実は、この3つの疑問に「クラウド vs エッジ」の2分割図では答えられません。ロボットの中身は2層ではなく、時間軸の違う3層でできている からです。
そして最も意外な事実がこれです。ロボットの中で、AI推論は「最も遅い層」です。
あなたが今いる場所:AIインフラ > フィジカルAI > 学習と推論の分担
▼ 知能の循環(学習から現実世界へ、そして戻る)
学習(データセンター) ←ココ
シミュレーション
推論(エッジ) ←ココ
制御・駆動
現実世界での動作
センサーで観測→学習へ
▼ サプライチェーン(上流→下流)
半導体・電子部品
センサー・アクチュエータ
ロボット本体
システム統合(SIer)
現場・運用
先に結論:正しい図は「2分割」ではなく「時間の3層」
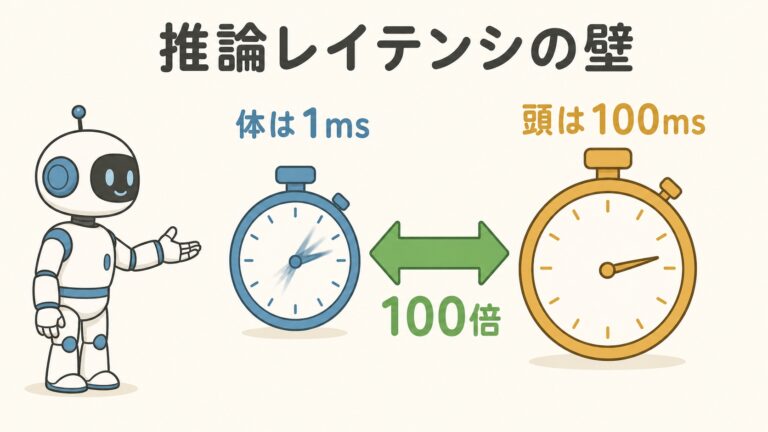
① 学習はDC: 数万時間の映像を処理する学習は、電力・冷却が潤沢なデータセンターでしかできない。② 推論は現場: クラウド往復の数十msでは、物理現象に間に合わない。体内で完結させるしかない。③ しかしAIは最速ではない: AI推論は10Hz級(0.1秒に1回) 。その下でモーター制御がkHz級(0.001秒に1回) 回っている。AIは「方針」を出す係で、体を支えているのは古典制御。 ④ DC需要は減らない: 推論が現場へ出ても、現場で集めたデータが学習へ還流するため、DC側の計算需要はむしろ増える。
5〜50Hz
ロボット用AIモデルが
※VLAモデルの出力周波数は業界レポートおよび公開論文ベース(π0で50Hz、産業用途の報告例で5〜15Hz)。サーボの電流ループ周期は各社サーボ技術資料ベース。いずれも機種・実装により大きく異なります。
まず基本|「学習」と「推論」は何が違うのか
用語解説:学習(トレーニング)と推論(インファレンス)
学習 は、大量のデータからAIの「勘どころ」を作る作業。時間をかけて何度も計算をやり直します。推論 は、できあがったAIに実際の入力を通して答えを出させる作業。1回きりですが、速さが命です。
クラウド(学習)
電力・冷却は追加投資で増やせる
数日〜数週間かけてよい
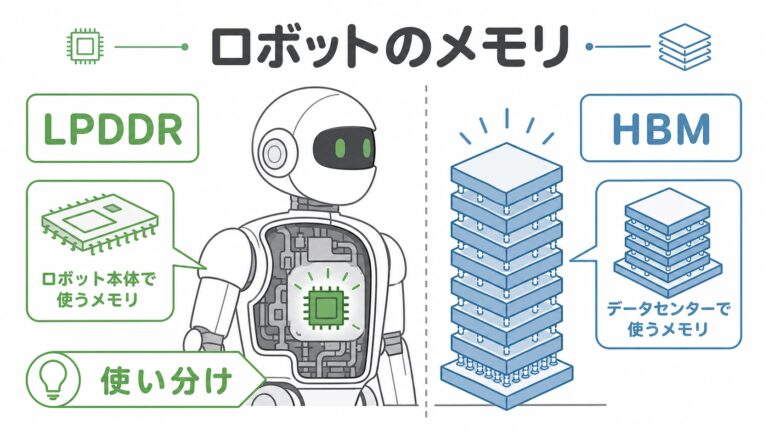
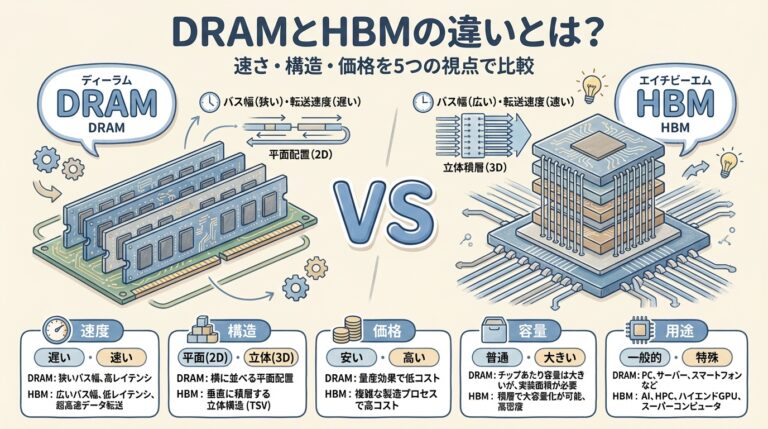
HBM搭載GPUが主役
1回失敗してもやり直せる
エッジ(推論)
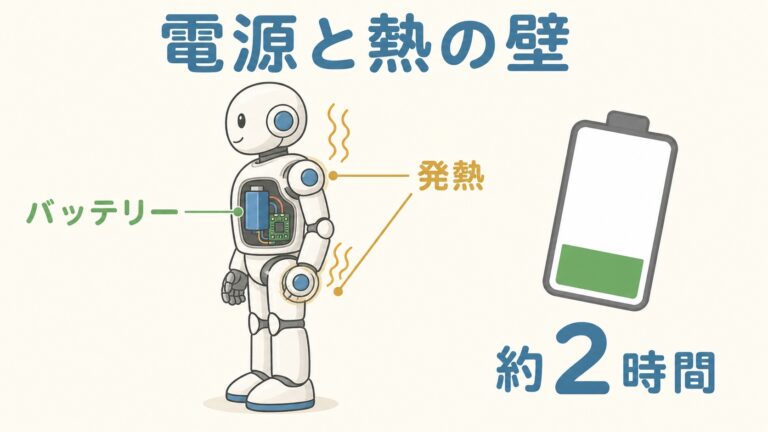
電池で動くため電力が有限
ミリ秒単位の応答が必須
LPDDR搭載SoCが主役
失敗=転倒・衝突で取り返しがつかない
ここまでは、どの解説記事にも書いてある内容です。学習側の環境についてはGPUサーバーとは? やAIデータセンターの5つの構成要素 で詳しく整理しています。
問題は、この2分割図がロボットに当てはめた瞬間に破綻することです。 次章から本題に入ります。
⏱️ 独自視点①|ロボットの中は「2層」ではなく「時間の3層」 「エッジで推論する」と一括りにされますが、ロボットの体内では時間スケールが3桁ずつ違う処理が同時並行で走っています。 これを1つの箱に押し込んで語るから、話が噛み合わなくなるのです。
層
やっていること
周期の目安
担当ハード
第1層 「コップを取る」など 5〜50Hz AI推論チップ 第2層 関節をどう動かすか 数百Hz〜1kHz 制御用MCU 第3層 モーターに流す電流を kHz〜十kHz級 モータードライバ
※周期は代表的な実装例。機種・用途により大きく異なります(要確認)。
たとえ話:現場監督と職人
AIは現場監督 です。「あの棚から箱を降ろして」と1秒に数回だけ指示を出す。実際に手を動かし、バランスを取り、風でよろけた瞬間に足を踏ん張るのは職人(制御ループ) 。監督が転倒を防いでいるわけではありません。安定性は下の2層=古典的な制御工学とパワー半導体の仕事 なのです。
この構造が分かると、企業の見え方が変わります。NVIDIAが握っているのは第1層だけ 。第2層はルネサス(6723)などのMCU、第3層はローム(6963)や富士電機(6504)のパワー半導体の領域です。SiC・GaNの記事 が、なぜフィジカルAIの必読記事になるのかもここで繋がります。
なぜ推論はクラウドに戻れないのか|3つの理由
理由1:往復時間が物理現象に負ける
通信が高速化しても、「往復」という行為そのものが数十ms消費します。 第2層の制御が1msで回っている世界に、数十msの遅れは持ち込めません。5G・6Gで帯域が増えても、光の速度と経路の段数は変わらないので、この壁は原理的に残ります。
理由2:切れた瞬間に凶器になる
クラウド依存の家電なら、通信が切れても「動かない」で済みます。しかし100kgの機械が人の隣で動いている最中に判断が止まれば、それは事故です。 「通信断でも安全に停止できる」ことが機能安全の前提であり、判断の中核をネットワークの向こうに置くという設計自体が採りにくいのです。
理由3:送るほうが電気を食う場合がある
見落とされがちですが、
高解像度の映像を無線で送り続ける電力は、決して小さくありません。 電池が有限なロボットにとって、「送って考えてもらう」ことが必ずしも省電力にならない。ここは
ローカルAI が選ばれる理由とも重なります。
加えて、工場やオフィスの映像を外部に出せないというデータ主権の問題 もあります。技術・安全・電力・法務の4方向から、推論は現場に押し込まれているのです。
独自視点②|エッジは「小さいデータセンター」ではない よくある誤解が「エッジ=DCを縮小したもの」というイメージです。しかし両者は設計思想が逆向き で、縮小コピーではありません。
設計項目
データセンター
ロボット(エッジ)
向きの違い
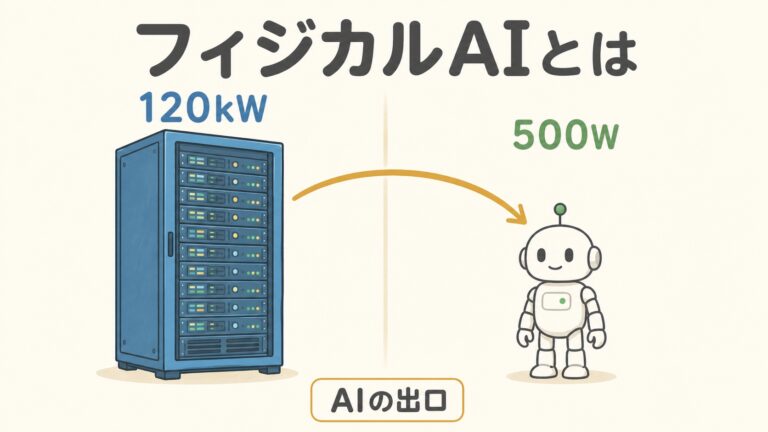
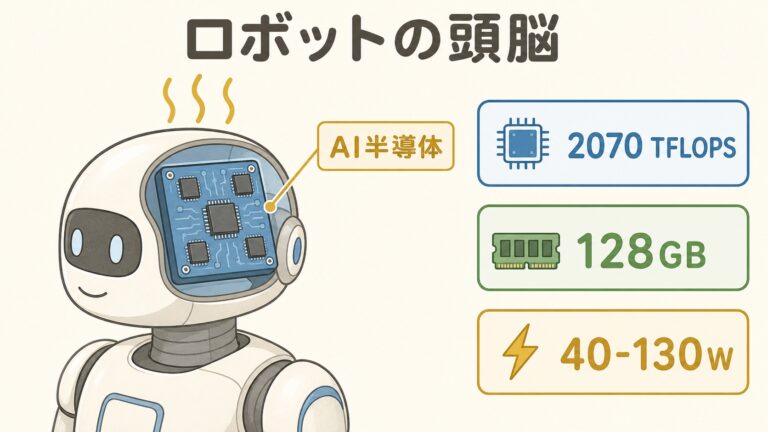
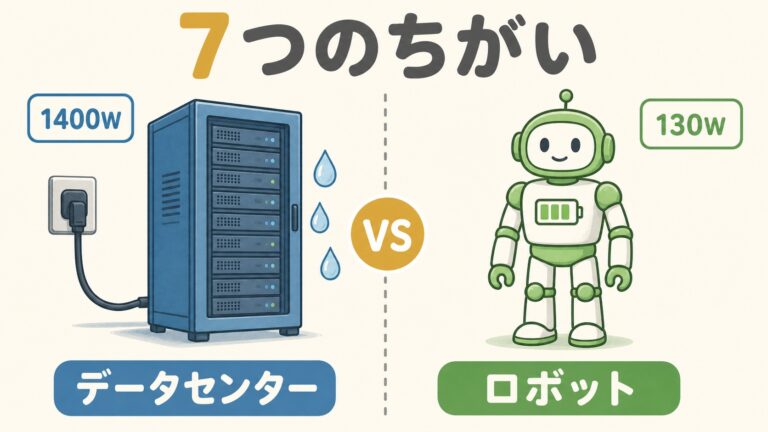
最適化の軸 総処理量 1回の応答時間 真逆 まとめ処理 まとめるほど有利 まとめられない 効率化の常識が通じない メモリ HBM(TB/秒級) LPDDR5X(273GB/秒) 桁で劣る 電力 ラック120kW超 チップ40〜130W 約1000分の1 故障時 別ノードへ逃がす 逃がし先がない 冗長化できない
※エッジ側の数値はNVIDIA Jetson Thor公称値(128GB LPDDR5X/273GB/s/40〜130W)。DC側はGB300 NVL72に関する各社報道ベース。
一番効く違いは「まとめられない」こと
データセンターのGPUは、多数の依頼をまとめて一気に処理することで効率を稼いでいます(バッチ処理)。ところがロボットは「いま目の前にある1枚の映像」を今すぐ処理するしかない。 まとめる相手がいないのです。「TOPSの数字が大きいチップ=ロボットで速い」とは限らない のは、この構造が理由です。
メモリの選び方の詳細はHBM vs LPDDR vs SOCAMM 、モデルを小さくする発想はSLM(小規模言語モデル)の仕組み で解説しています。
実は拠点も2つではない|シミュレーションという第3のDC 「クラウドとロボット」の2拠点で考えると、もう一つの巨大な計算需要を見落とします。それがシミュレーション です。
用語解説:Sim-to-Real(シム・トゥ・リアル)
仮想空間でロボットを何万回も動かして学習させ、その成果を実機に移すやり方です。実機で1万回転ばせると壊れますが、仮想空間なら壊れません。ただし仮想と現実のズレの分だけ、実機では失敗します。
重要なのは、このシミュレーションがまた別種のデータセンター負荷 だという点です。学習用GPUが「行列計算」を回すのに対し、シミュレーションは物理演算と映像生成を大量に回します。つまりフィジカルAIは、DC側に「学習用」と「シミュレーション用」の二重の需要を作ります。
NVIDIAが「3つのコンピューター」(学習・シミュレーション・実機)という言い方をしているのも、この構造を指しています。本サイトの関心はモデルの中身ではなく、この3拠点それぞれが要求する電力・冷却・メモリです。
独自視点③|推論が現場に出ても、DC需要は減らない 投資判断で最も重要なのがここです。「エッジ推論が普及するとデータセンターは不要になるのでは?」という問いに対する答えは、構造的に「逆」 です。
データ還流のループ(フライホイール)
1. DCで学習したAIをロボットに載せる2. ロボットが現場で働き、センサーで現実を記録し続ける 3. 失敗事例・想定外の状況がデータとしてDCへ戻る4. DCで再学習・再シミュレーション → 1へ戻る
つまり「現場で動くロボットの台数」が、そのままDC側の学習データ供給量になります。 ロボットが増えるほど、DCの計算需要は増える。エッジとDCは奪い合いではなく、掛け算の関係 です。
現実世界のセンサーデータは、テキストと比べて桁違いに重いのが特徴です。映像・深度・力覚・関節角度が同時に、しかも高頻度で記録される。インターネット上のテキストデータが枯渇し始めたと言われる中で、ロボットは「新しいデータの油田」 として位置づけられています。
ただし冷静に見るべき点
この還流が本格的に回るには、ロボットが十分な台数、実際に現場で稼働している必要があります。 2026年時点で、ヒューマノイドの量産規模はまだ限定的です。「データ還流でDC需要が爆発する」というシナリオは方向性として妥当でも、時間軸は数年単位で見るべき で、現時点の各社決算に大きく効いているわけではありません。
DC側の電力制約についてはAIデータセンターはなぜ電気を食うのか となぜ”電力”で詰まるのか をあわせてどうぞ。
「時間の3層」を誰が握っているのか 先ほどの3層構造を、企業の地図に重ねると見え方が変わります。NVIDIAが支配しているのは第1層のみ で、第2層・第3層は日本企業が伝統的に強い領域です。
第1層:意図(AI推論)
NVIDIA (NVDA):Jetson系で事実上の標準Qualcomm (QCOM):エッジAI SoCソシオネクスト (6526):カスタムSoC設計※メモリはLPDDR系。国内では車載・産業向けの採用実績が鍵
第2層:軌道(制御・センサー)
ルネサス (6723):制御用MCU安川電機 (6506):サーボ制御の中核オムロン (6645):FA制御・センサーソニーG (6758):イメージセンサー首位村田製作所 (6981):慣性センサー
第3層:電流(パワー・駆動)
ローム (6963):SiC・モータードライバ富士電機 (6504):パワー半導体三菱電機 (6503):パワー半導体・サーボニデック (6594):モーターハーモニック (6324):波動歯車減速機
実需と思惑の分け方
第2層・第3層の企業は、現時点でも産業用ロボットや工作機械、車載向けで実需の売上が立っています。 ここが「フィジカルAI関連」の名前だけで動いているテーマ株との決定的な違いです。逆に言えば、ヒューマノイド向けの上乗せがどれだけ乗ったかは、各社IRの受注高で個別に確認するしかありません。 「関連」と報じられただけの銘柄と、既存事業で稼いでいる銘柄を混ぜないでください。※本記事は特定銘柄の売買を推奨するものではありません。証券コード・業績は執筆時点のものです。最新のIR資料をご確認ください。
この構造が、あなたにとって持つ意味
投資家の方へ
「エッジAIが伸びるからDC株は売り」という発想は、データ還流の構造を見落としています。 両者は掛け算です。また、AI推論チップ(第1層)だけに注目すると勝者はNVIDIA1社に見えますが、第2層・第3層まで含めると日本企業の取り分が明確に存在します。
学生・院生の方へ
「AI=機械学習の研究室」と決めつける必要はありません。第2層の制御工学、第3層のパワーエレクトロニクスは、フィジカルAIの土台そのものです。 しかも、AIができる人より圧倒的に人数が少ない。希少性という意味では、こちらのほうが有利になる場面があります。
製造業の技術者の方へ
サーボ制御やインバータの実務経験は、そのままフィジカルAIの第2層・第3層のスキルです。「AIについていけない」と感じる必要はまったくありません。 むしろ、上に載るAIの都合(10Hzで指令が来る)を知っておくと、社内での立ち位置が一段クリアになります。
よくある3つの誤解
誤解1:通信が速くなればクラウド推論に戻る 往復の遅延はゼロにならず 、通信断時の安全性も担保できません。判断の中核は現場に残り続けます。誤解2:エッジ推論が普及するとDCは不要になる ロボットが増えるほど学習データが増えて需要が拡大 します。誤解3:AIチップが速ければロボットは俊敏になる 第2層・第3層の制御周期とモーターの応答 です。AIを高速化しても、動きの滑らかさは変わりません。
この記事のテーマを、本でもっと深く PR(アフィリエイト広告)
現場で動くAIを、社会実装の側から考えたい方に。本書(インプレス)には「社会実装の設計図――AIエージェントと世界理解で身体を動かす」の章があり、現場への実装力や、人と機械の役割の再設計も取り上げられています。
¥2,200 (2026/10/05 21:03時点 | Amazon調べ)
ポチップ
S
シラス
電験三種・QC検定1級 / メーカーでパワエレ設計・品質保証 実務10年
メーカーで回路設計と生産技術(品質改善)に携わってきた経験をもとに、AIインフラを支える半導体・電力・冷却の仕組みを、図解でやさしく解説しています。
テーマ別に、もっと深く学ぶ 気になるところから読んでも大丈夫です。どの記事も、はじめての方にもわかるように図解で書いています。
フィジカルAIをもっと深く
つまずきやすい「違い」を解決
あわせて知りたい、隣のテーマ








コメント