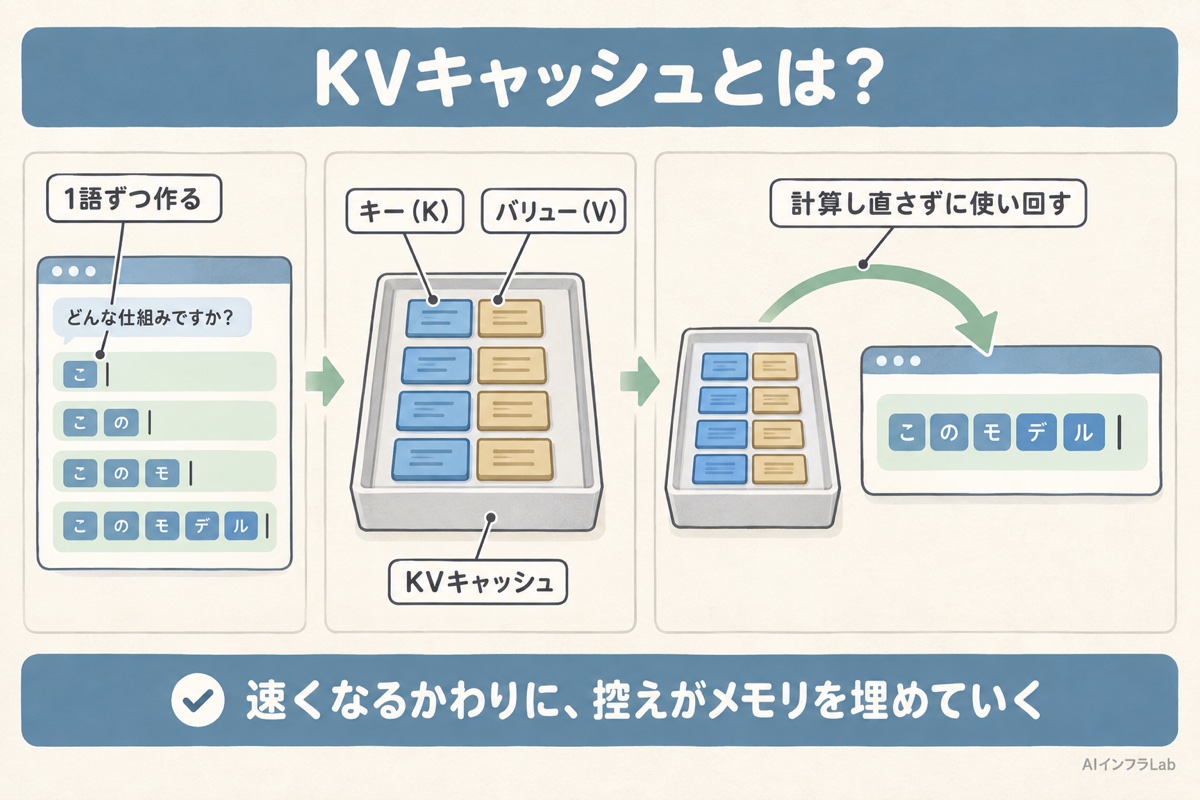
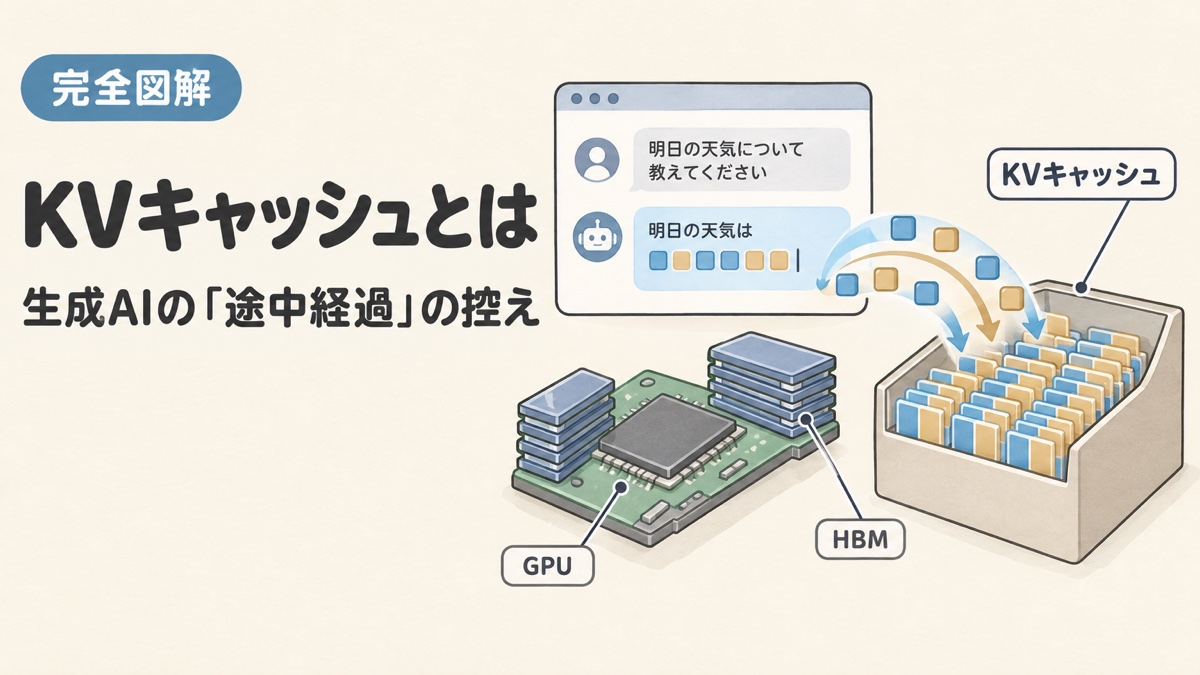
KVキャッシュとは、ChatGPT のような生成AIが文章を1語ずつ作るときに、それまでの文章について計算した結果(キーとバリュー)を、メモリの中に控えておくものです。計算をやり直さずに済むぶん速くなります。
代わりに、会話が長くなるほど、使う人が増えるほど、控えはふくらむ。AIの推論でHBMが足りない、SSDが足りないというニュースの裏には、この控えがあります。大きさの目安、むだを減らす工夫、置き場所を広げる動きの順に見ます。
先に見たい節 なぜ大きくなるか/むだを減らす工夫/置き場所を広げる
あなたが今いる場所:AIインフラ > AIデータセンター入門 > KVキャッシュとは
AIデータセンターの5つの構成要素
計算(GPUサーバー)
記憶(メモリ・ストレージ) ←ココ
通信(ネットワーク)
電力供給
排熱処理(冷却)
KVキャッシュの置き場所(速い順)
HBM
CPUの横のメモリ
CXLのメモリ
SSD
KVキャッシュとは
先に結論
KVキャッシュとは、生成AIが次の1語を作るために使う、それまでの文章の「キー(K)」と「バリュー(V)」という計算結果を、GPUのメモリに控えておくものです。
生成AIは、文章を1語(1トークン)ずつ作り、そのたびに前の文章全体を振り返ります。KVキャッシュがあれば、前の文章の計算をやり直さずに済みます。そのかわり、控えの量は文章の長さと同時に使う人の数に比例して増え、GPUのメモリ(HBM)をすぐに埋めてしまいます。そこで、メモリのむだを減らすソフトの工夫と、控えをCPUのメモリやSSDにまで広げて置く仕組みが進んでいます。
用語メモ:トークン
生成AIが文章を扱うときの最小の単位。日本語では、おおよそ1〜数文字にあたります。
用語メモ:推論
学習を終えたAIのモデルに質問を入れて、答えを作らせること。ChatGPTに質問して答えが返ってくるのが推論です。
生成AIは、文章をどう作っているのか
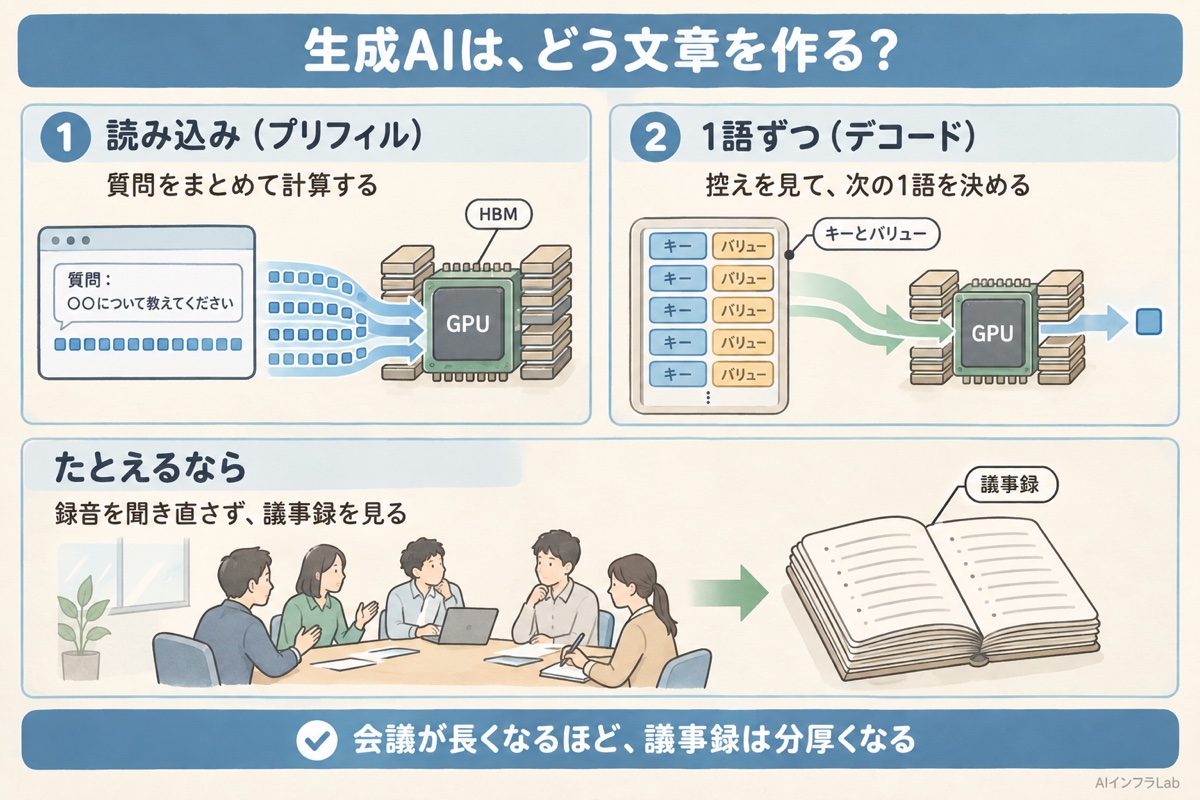
生成AIは、質問の文章を読み込んだあと、答えを1語ずつ作っていきます。次の1語を決めるたびに、それまでのすべての語との関係を計算します(アテンションと呼ばれる計算)。
1. 読み込み(プリフィル)
質問の文章を一度にまとめて読み込み、各語のキーとバリューを計算します。まとめて計算できるので、GPUの計算の力を存分に使えます。
2. 1語ずつ作る(デコード)
答えを1語作るたびに、新しい語のキーとバリューを計算し、それまでの全部のキーとバリューと照らし合わせて、次の1語を決めます。
ここで、前の語のキーとバリューを毎回計算し直すと、文章が長くなるほど計算がふくらみます。そこで、一度計算したキーとバリューをメモリに控えておき、次の語でそのまま使います。この控えが KV キャッシュです。
たとえるなら
長い会議の議事録です。発言のたびに会議の最初から録音を聞き直すのではなく、要点を議事録に書き留めておけば、次の発言のときは議事録を見るだけで済みます。そのかわり、会議が長くなるほど議事録は分厚くなります。
用語メモ:キー(K)とバリュー(V)
アテンションの計算で、各語について作る2種類のデータ。キーは「どの語と関係が深いかを探すための目印」、バリューは「その語が持つ中身」にあたります。
KVキャッシュはなぜ大きくなるか
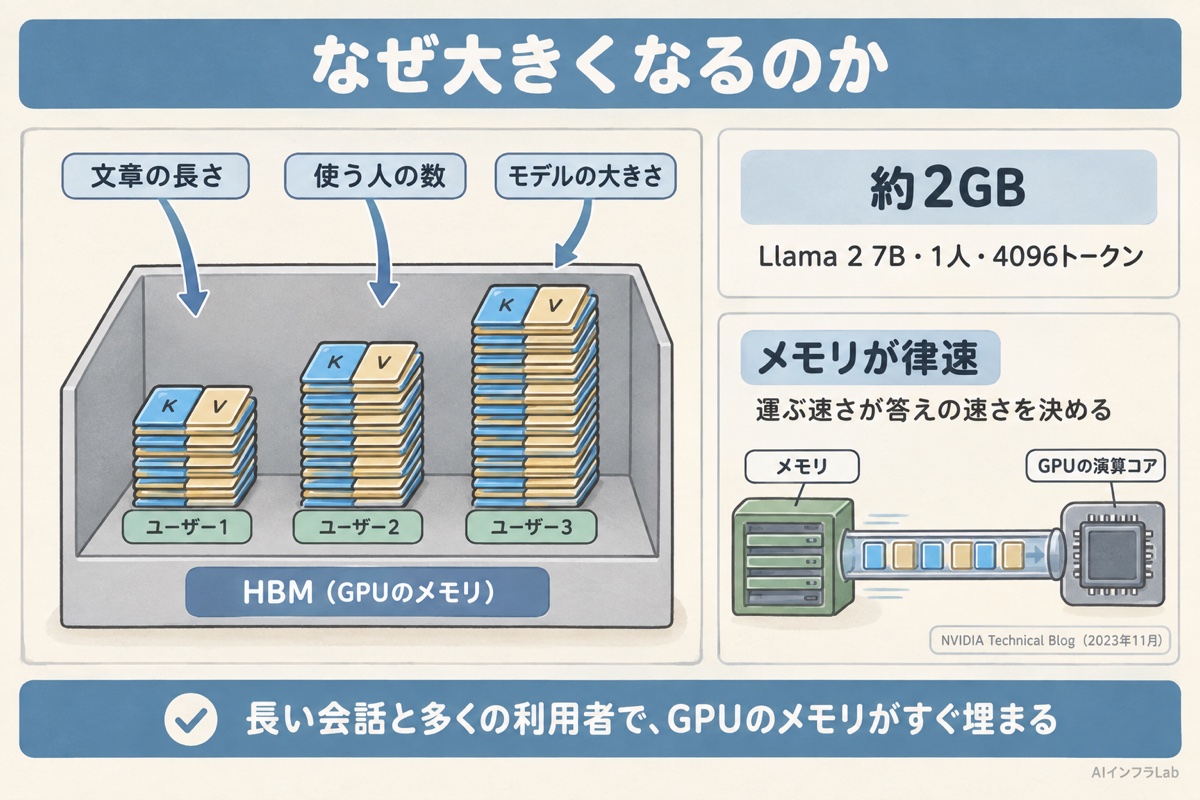
KVキャッシュの大きさは、次のものに比例して増えます。
| 大きくなる要因 |
理由 |
| 文章の長さ | 1語ごとにキーとバリューを控えるので、長い会話・長い資料ほど大きくなる |
| 同時に使う人の数 | 1人ずつ別の控えが要る |
| モデルの層の数・幅 | 大きなモデルほど、1語あたりの控えが大きい |
| 数字の細かさ(精度) | 16ビットより8ビットのほうが小さく済む |
NVIDIA は、Llama 2 7B というモデルを16ビットで動かし、1人で4096トークンの文章を扱う場合、KVキャッシュが約2GBになると計算しています。同時に使う人が増えたり、文章がさらに長くなったりすると、その分だけ増えていきます。
約2GB
Llama 2 7B(16ビット)で、1人・4096トークンを扱うときの KV キャッシュの大きさ
出典:NVIDIA Technical Blog(2023年11月17日)
さらに、1語ずつ作るデコードでは、毎回この控えをメモリから読み出す必要があり、計算の速さよりもメモリからデータを運ぶ速さが、答えの出る速さを決めます。NVIDIA は、デコードを「メモリが律速の処理」と説明しています。
電源の設計者がこの節を読むなら、まず見たいのは計算の回数ではなく、メモリとGPUの間を行き来するデータの量です。データを動かすことにも電気がかかる。運ぶ量が増える処理は、答えの速さと同時に、電力の見積もりも変えるからです。

あわせて読みたい
【完全図解】HBMとは?読み方・仕組みとGPUに必要な理由をやさしく解説
GPUの隣にある「AI最重要メモリ」、HBMの仕組み
メモリのむだを減らす工夫
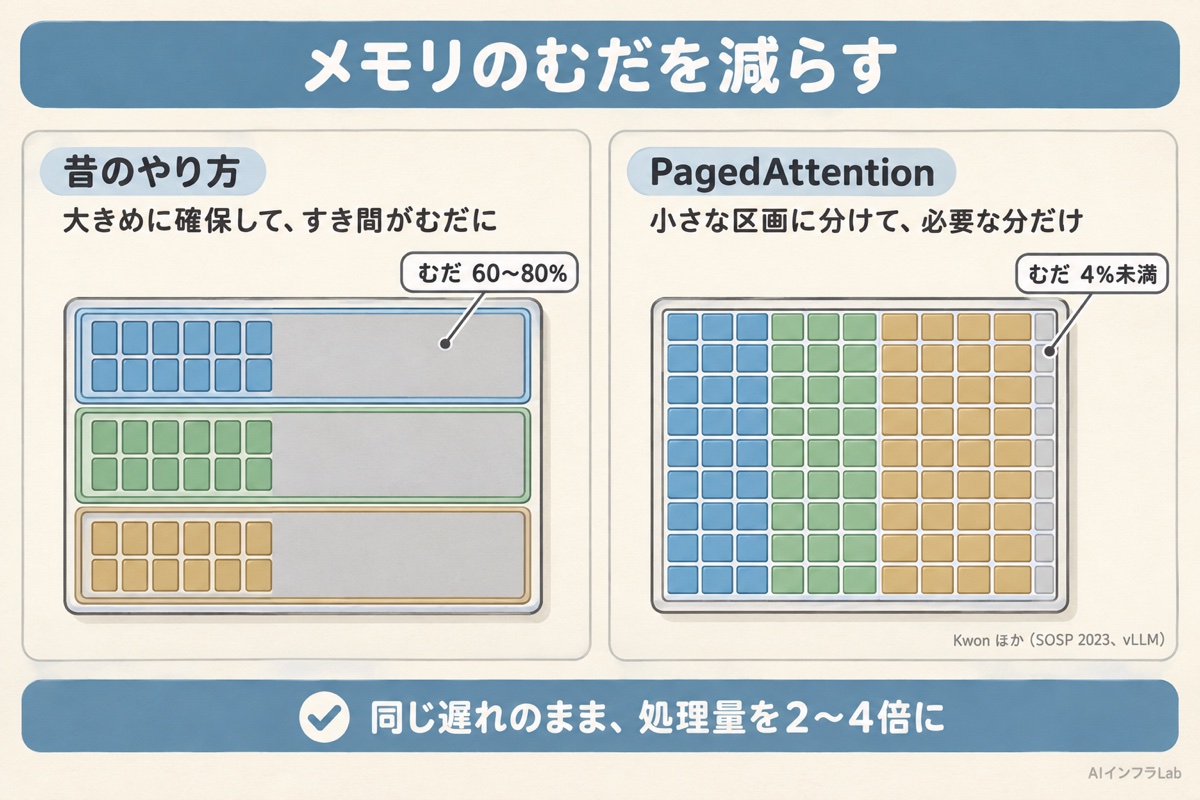
KVキャッシュは、答えがどれだけ長くなるか前もってわからないので、昔のやり方では大きめの場所を先に確保していました。その結果、使われない場所が多く残っていました。
1. 小さな区画に分けて管理する(PagedAttention)
パソコンのOSがメモリを小さなページに分けて管理するように、KVキャッシュを小さな区画に分け、必要な分だけ割り当てます。
2. 同じ部分は共有する
多くの人が同じ前置きの文章を使う場合、その部分の控えを1つにまとめて共有します。
3. 控えを小さくする
キーとバリューの数を減らすモデルの設計や、数字を8ビットなどに縮める工夫で、1語あたりの控えを小さくします。
2023年に発表された vLLM という仕組みの論文では、それまでのシステムが KV キャッシュのメモリの60〜80%をむだにしていたのに対し、PagedAttention でむだを4%未満に減らし、同じ遅れのまま処理量を2〜4倍にしたと報告しています。
60〜80%→4%未満
KV キャッシュのメモリのむだ(既存のシステム→PagedAttention を使う vLLM)
出典:Kwon ほか(SOSP 2023)
KVキャッシュの置き場所を広げる
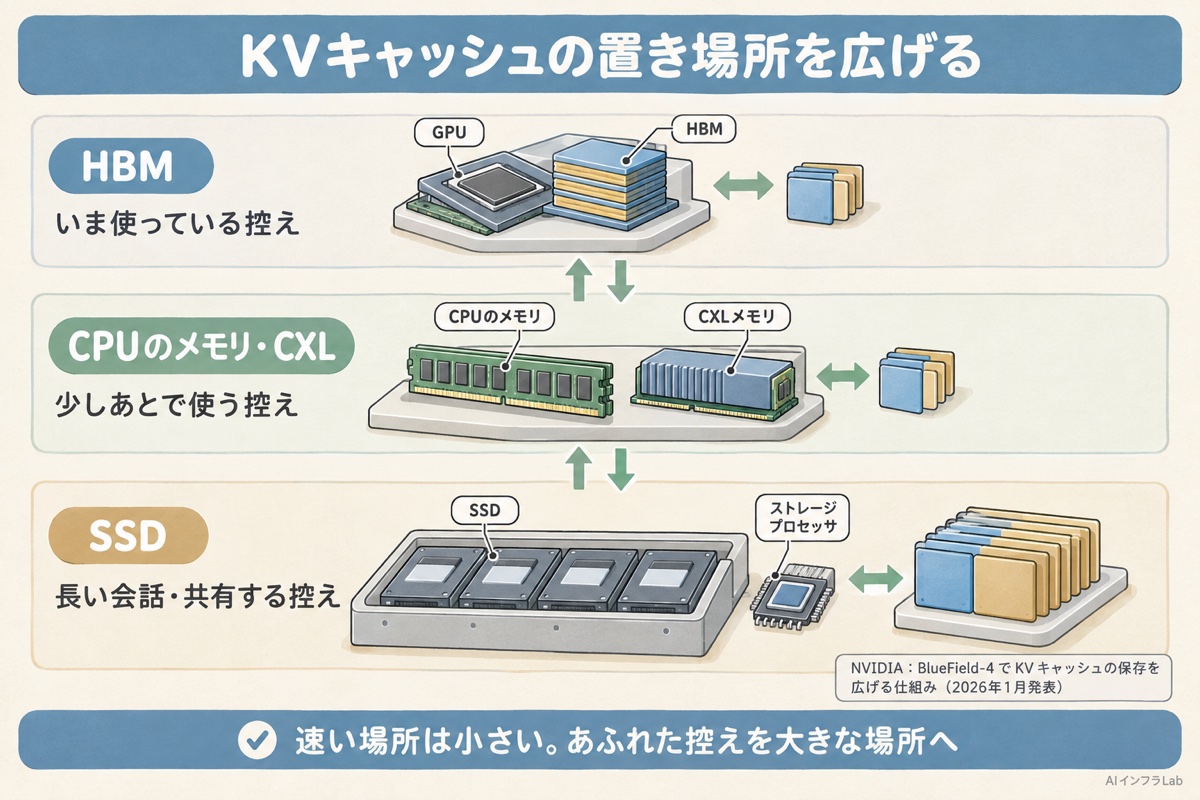
いちばん速いのはGPUのそばのHBMですが、容量に限りがあります。そこで、すぐには使わない控えを、より大きく安い場所に移しておき、必要になったら戻す仕組みが進んでいます。
| 置き場所 |
速さ |
容量 |
役目 |
| HBM(GPUのそば) | いちばん速い | 小さい | いま使っている控え |
| CPUの横のメモリ・CXLのメモリ | 速い | 中くらい | 少しあとで使う控え |
| SSD(ストレージ) | 遅め | 大きい | 長い会話の続きや、共有する控え |
NVIDIA は2026年1月の CES で、KV キャッシュを GPU に長く置いておくことはできないとして、データ処理用のチップ BlueField-4 を使い、KV キャッシュの容量を増やしてラックをまたいで共有するストレージの仕組み(Inference Context Memory Storage Platform)を発表しました。提供は2026年後半としていました(発表の時点)。
あわせて読みたい
【完全図解】AIデータセンターの消費電力とは?なぜ電気を食うのか、電力需要の構造をやさしく整理
AIはなぜこんなに電気を食うのか。需要の構造を整理
KVキャッシュとメモリ・SSDの需要
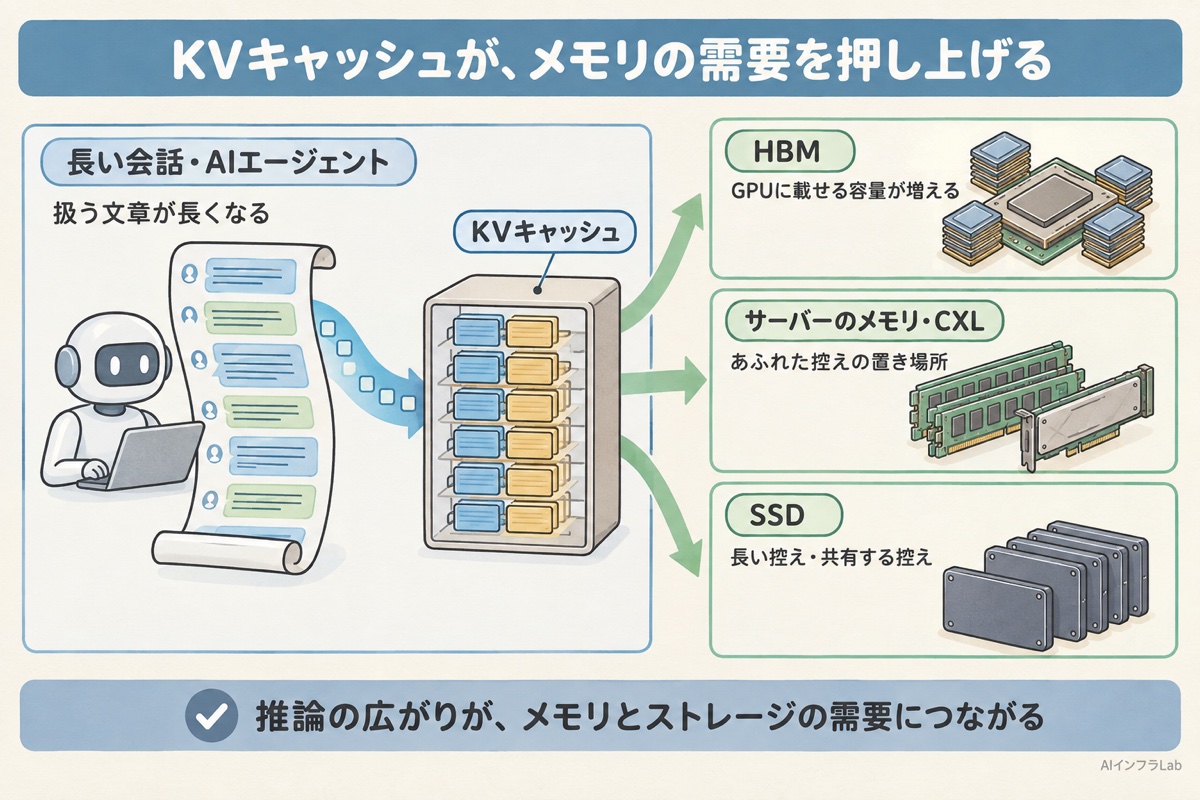
1. HBMをもっと大きく
1つのGPUにより多くの控えを置けるよう、GPUに載せるHBMの容量は世代ごとに増えています。
2. サーバーのメモリとCXL
あふれた控えを置く場所として、CPUの横のメモリや CXL のメモリの出番が増えます。
3. SSDの需要
長い会話の控えや共有する控えを置く場所として、大容量のSSDの需要も増えます。
AIエージェントのように、何段階も考えたり、長い資料を読んだりする使い方が増えるほど、扱う文章は長くなり、KVキャッシュは大きくなります。AIの推論の広がりが、メモリとストレージの需要を押し上げる理由の1つがここにあります。
調査会社の発表を読んで、筆者が目を止めた一文があります。TrendForce(トレンドフォース)の2026年9月21日の発表は、データセンター向けSSDの値上がりの理由の1つに、KVキャッシュをメモリから大容量のQLCのSSDへ逃がす使い方を挙げていました。ソフトの中の仕組みの名前が、SSDの値段の説明にまで出てくるようになったということです。
あわせて読みたい
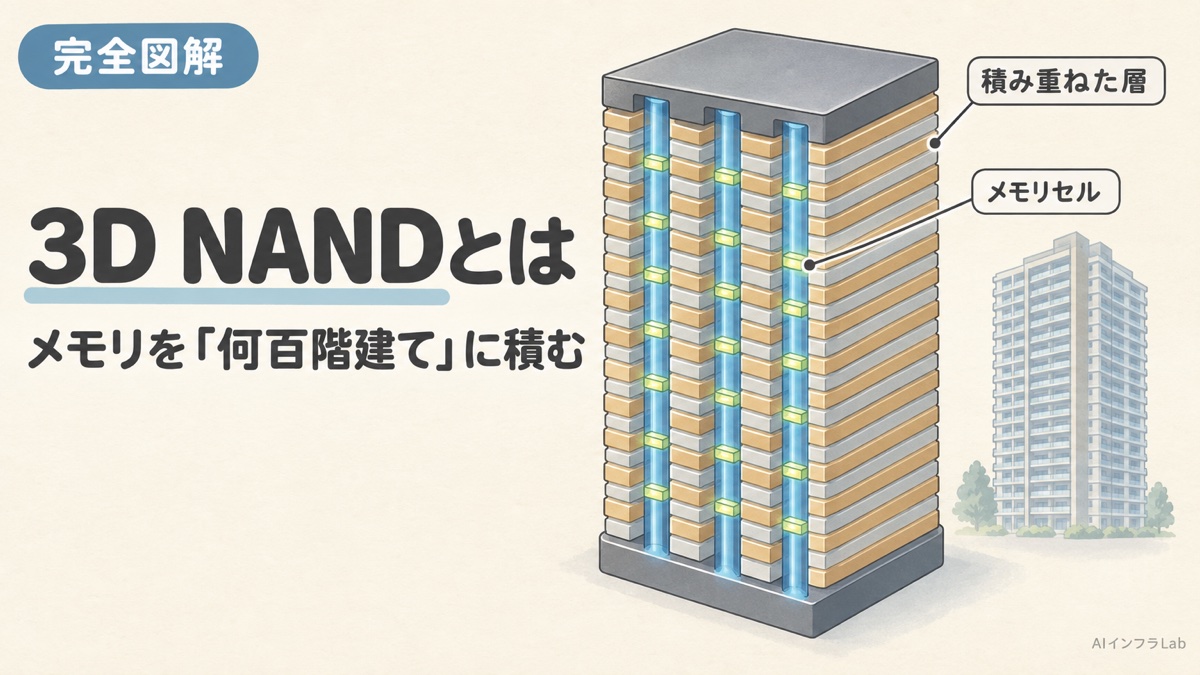
3D NANDとは?NAND型フラッシュメモリを「何百階建て」に積む仕組みと、AIでSSDが足りない理由
メモリを「何百階建て」に積む、3D NANDの仕組み
KVキャッシュを知ると、何が見えてくるか
あなたにとっての意味
仕事で関わる方へ:インフラ・ソフトのどの仕事でも、生成AIの推論の速さと費用は、計算の力だけでなく「控えをどこに、どれだけ置けるか」で決まると知っておくと、GPUやメモリの選び方の話がわかりやすくなります。
投資家の方へ:推論の需要が増えるほど、HBMだけでなく、サーバーのメモリ・CXL・SSDまで需要が広がります。メモリとストレージの会社のニュースを、KVキャッシュという1本の線でつなげて読めます。
学生・就活中の方へ:KVキャッシュは、AIの仕組み(アテンション)と、コンピューターの仕組み(メモリの階層・ページング)がつながるテーマです。情報系の学生にとって、AIとシステムの両方を学ぶ入口になります。
よくある誤解
誤解1:KVキャッシュは、AIが会話を長く覚えておく記憶
1回の会話(推論)の途中の計算結果の控えです。モデルが学習した知識とは別のものです。
誤解2:GPUの計算が速ければ、答えも速く出る
1語ずつ作る段階では、控えをメモリから運ぶ速さが答えの速さを決めます。
誤解3:KVキャッシュはGPUの中にしか置けない
CPUのメモリや SSD に移して、必要なときに戻す仕組みが進んでいます。
まとめ
- KVキャッシュは、生成AIが次の1語を作るために、前の文章の計算結果を控えておくもの
- 文章の長さと同時に使う人の数に比例して大きくなる(Llama 2 7B・4096トークンで約2GB)
- 1語ずつ作る段階は、メモリから運ぶ速さが答えの速さを決める
- PagedAttention などで、メモリのむだを大きく減らせる(60〜80%→4%未満、vLLM の論文)
- 控えの置き場所は HBM から CPU のメモリ・SSD へ広がり、メモリの需要を押し上げる
よくある質問
Q. KVキャッシュとは何ですか?
A. 生成AIが文章を1語ずつ作るときに、それまでの文章について計算したキーとバリューを、メモリに控えておくものです。
Q. なぜKVキャッシュでメモリが足りなくなるのですか?
A. 控えの量が、文章の長さと同時に使う人の数に比例して増え、GPUのメモリをすぐに埋めてしまうためです。
Q. KVキャッシュはどこに置かれますか?
A. 主にGPUのそばのHBMですが、あふれた分をCPUのメモリやSSDに移して置く仕組みも進んでいます。
Q. KVキャッシュのむだを減らす方法は?
A. 小さな区画に分けて必要な分だけ割り当てる PagedAttention や、同じ部分の共有、控えを小さくする工夫があります。
この記事のテーマを、本でもっと深くPR(アフィリエイト広告)
この記事で見た「生成AIが文章を作る仕組み」を、モデルの側から知りたい方に。本書(翔泳社)は、大規模言語モデルを仕組みから解説するソフトウェア開発の入門書で、「Transformer」「学習」「プロンプトエンジニアリング」「言語モデルAPI」などの章があります。
¥3,366 (2026/10/07 01:15時点 | Amazon調べ)
 ポチップ
S
シラス
電験三種・QC検定1級 / メーカーでパワエレ設計・品質保証 実務10年
メーカーで回路設計と生産技術(品質改善)に携わってきた経験をもとに、AIインフラを支える半導体・電力・冷却の仕組みを、図解でやさしく解説しています。
テーマ別に、もっと深く学ぶ
気になるところから読んでも大丈夫です。どの記事も、はじめての方にもわかるように図解で書いています。
AIデータセンターをもっと深く
つまずきやすい「違い」を解決
あわせて知りたい、隣のテーマ


コメント