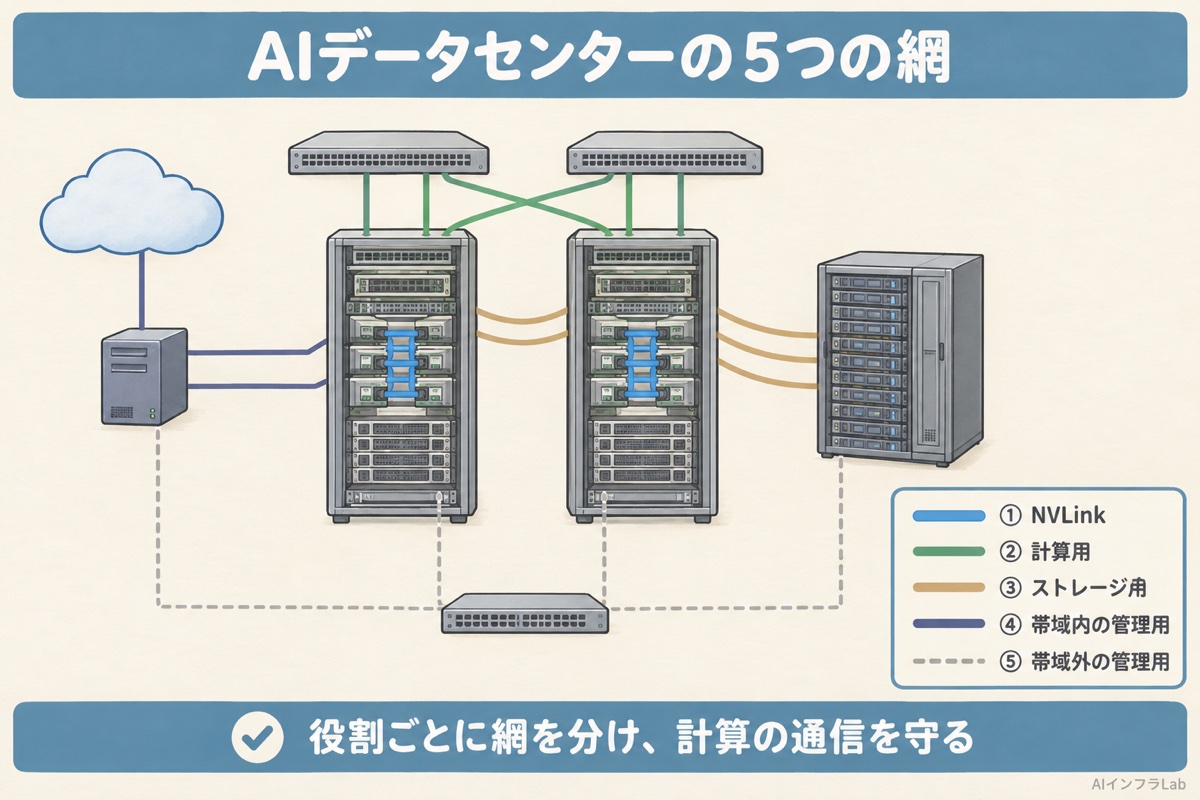
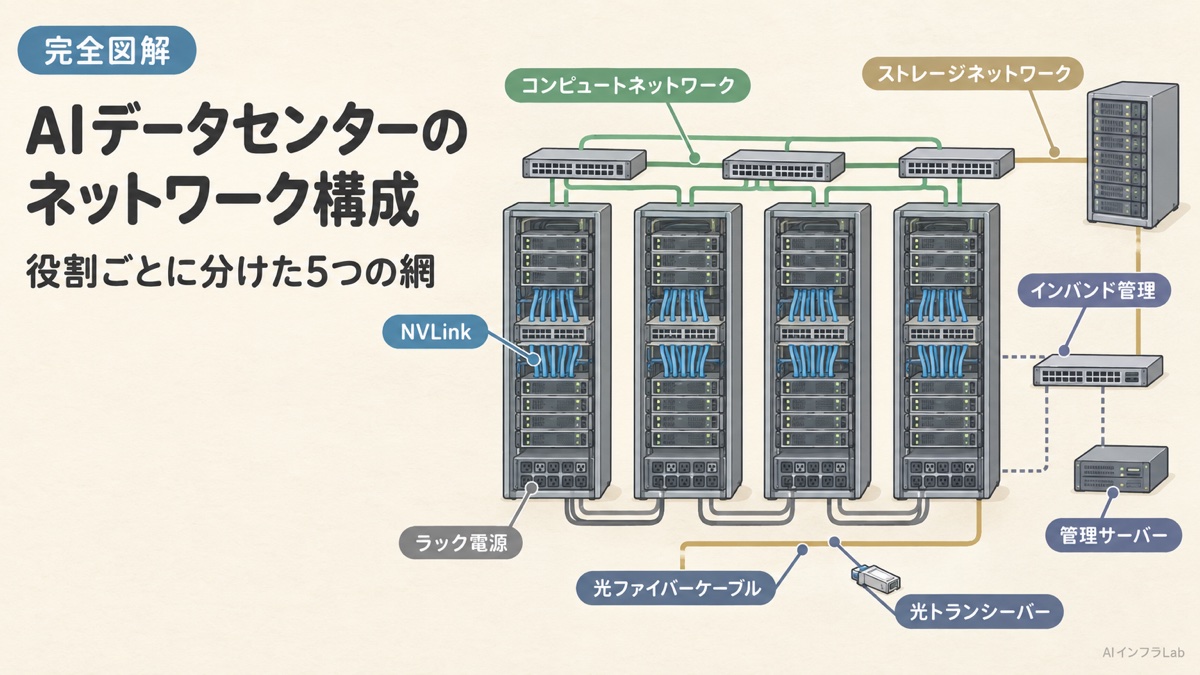
AIデータセンターのネットワーク構成は、1本の網ではありません。ラックの中でGPUをつなぐ NVLink(エヌブイリンク)、ラックの外のGPUどうしをつなぐ計算用の網、データを読み書きするストレージ用の網、管理用の網、機械の管理ポートだけをつなぐ帯域外の管理用の網。役割ごとの5つの網で考えます。
InfiniBand(インフィニバンド)や Ethernet の名前を聞いても、どの網の話かが分からないと迷います。NVIDIA(エヌビディア)の参照設計をもとに、5つの網を1枚の地図にしました。
先に見たい節 5つの網の地図/計算用の網のレール/ストレージ用・管理用の網
あなたが今いる場所:AIデータセンター > ネットワーク > 全体の構成
AIデータセンターの中身
GPUサーバー
ネットワーク ←ココ
ストレージ
電力
冷却
ネットワークの技術
NVLink
InfiniBand・Ethernet
光スイッチ(OCS)
光トランシーバー
AIデータセンターのネットワーク構成
先に結論
AIデータセンターのネットワークは、役割ごとに分けた5つの網で考えるとわかりやすくなります。ラックの中でGPUを1台の巨大なGPUのようにつなぐNVLink、ラックの外のGPUどうしをつなぐ計算用の網、学習データを読み書きするストレージ用の網、利用者や管理のサービスにつなぐ帯域内の管理用の網、機械の管理ポートだけをつなぐ帯域外の管理用の網です。
NVIDIAの参照設計(DGX SuperPOD)でも、ラックの外の網は計算用・ストレージ用・帯域内の管理用・帯域外の管理用の4つに分けています。いちばん速さが求められる計算用の網にはInfiniBandや高速のEthernetを、管理用の網にはふつうのEthernetを使います。
用語メモ:帯域内・帯域外
帯域内(イン・バンド)は、ふだんのデータと同じ網で管理もすること。帯域外(アウト・オブ・バンド)は、機械の電源や状態を見るための管理専用の別の網のことです。
5つの網を1枚の地図で見る
| 網 |
つなぐもの |
主な技術 |
求められること |
| ① NVLink(スケールアップ) | ラックの中のGPUどうし | NVLink と NVLink スイッチ | とにかく速く、遅れなく |
| ② 計算用の網(バックエンド) | ラックの外のGPUサーバーどうし | InfiniBand、高速の Ethernet | 速さ・遅れの少なさ・混雑に強いこと |
| ③ ストレージ用の網 | GPUサーバーとストレージ | InfiniBand や Ethernet | 大量のデータを読み書きできること |
| ④ 帯域内の管理用の網(フロントエンド) | 管理のサービス・利用者・外のネット | Ethernet | 使う人や外とつながること |
| ⑤ 帯域外の管理用の網 | 機械の管理ポート(サーバー・スイッチ・電源) | Ethernet | ほかの網が止まっても機械を見られること |
網を分けるのは、役割によって求められることが違うからです。GPUどうしの計算のやり取りは、ほんの少しの遅れでも全体の計算が待たされます。そこに、データの読み書きや管理の通信がまざると混雑して遅くなります。だから、いちばん大事な計算の通信には専用の網を用意します。
たとえるなら
AIデータセンターは「大きな工場」です。NVLinkは同じ作業台の上でのやり取り、計算用の網は作業台どうしを結ぶ専用のベルトコンベア、ストレージ用の網は倉庫からの搬入路、帯域内の管理用の網は事務所と外への道、帯域外の管理用の網は、停電でも使える非常用の連絡線です。
あわせて読みたい
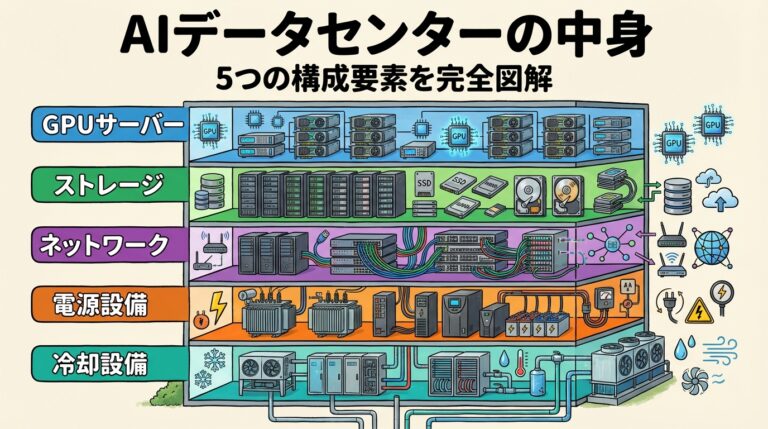
【完全図解】AIデータセンターの構成と仕組み|5つの構成要素を1枚の地図で理解する
AIデータセンターの中身を、5つの構成要素で
ラックの中はNVLink、ラックの外は計算用の網
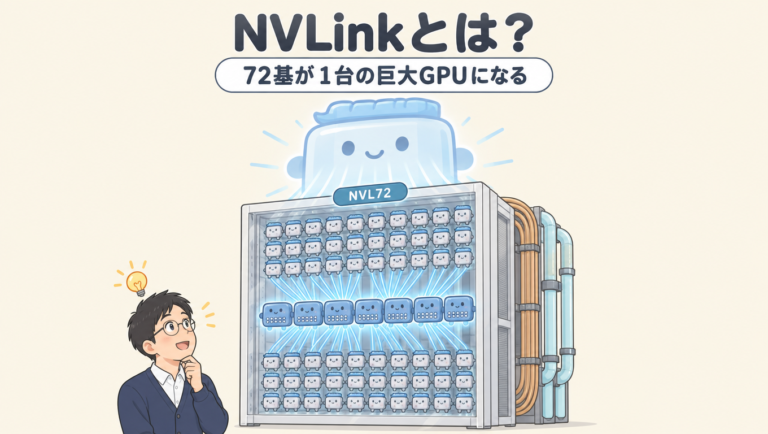
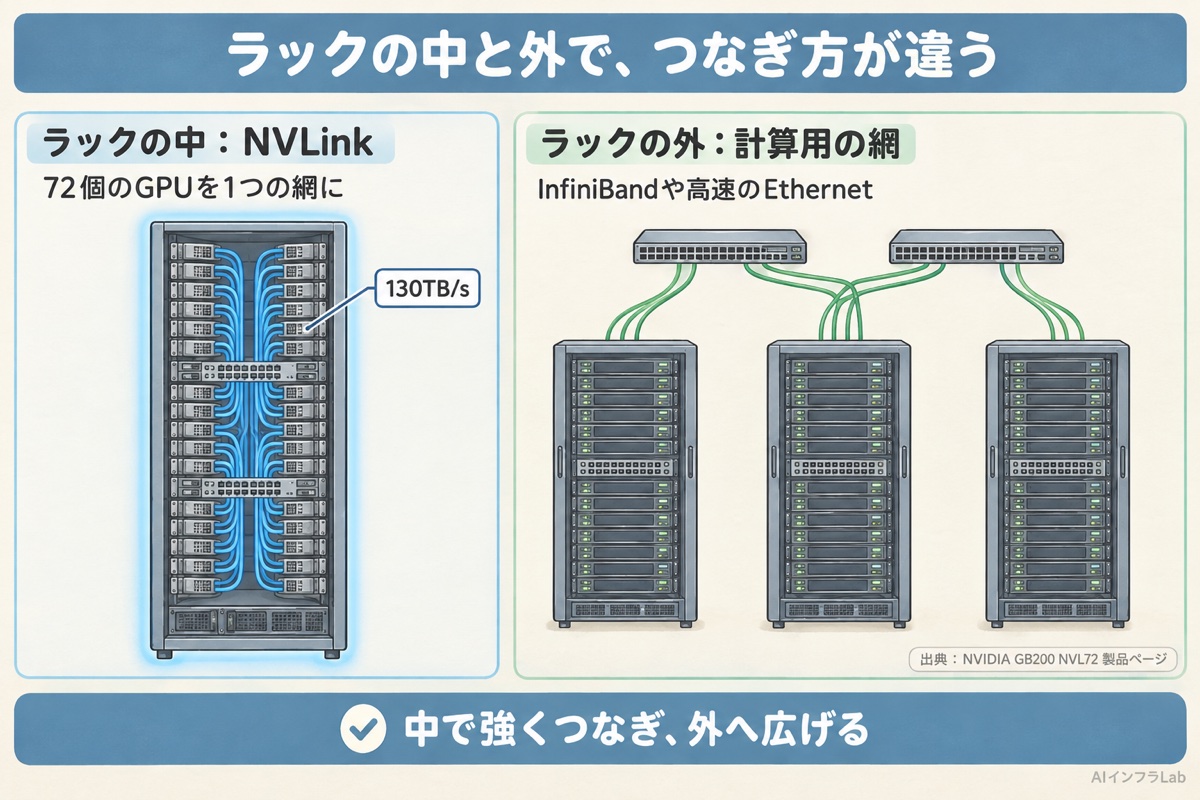
GPUどうしの通信は、ラックの中と外で使う網が分かれます。NVIDIAのGB200 NVL72では、72個のGPUを1つのNVLinkの網(ドメイン)でつなぎ、1台の巨大なGPUのように動かします。NVLinkのスイッチ全体で130TB/s、GPU 1個あたり1.8TB/sです。
ラックの外のGPUとは、計算用の網でつなぎます。GB200 NVL72の製品ページでは、Quantum-X800のInfiniBandと、Spectrum-X800のEthernetを挙げています。ラックの中で足りない分を、ラックの外へ広げてつなぐ役目です。この「ラックの中で強くつなぐ(スケールアップ)」と「ラックの外へ広げる(スケールアウト)」の違いは、NVLinkの記事で詳しく説明しています。
72個
GB200 NVL72 で1つのNVLinkの網につなぐGPUの数
出典:NVIDIA 製品ページ
130TB/s
GB200 NVL72 のNVLinkスイッチ全体の通信の速さ
出典:NVIDIA 製品ページ
1.8TB/s
第5世代NVLinkのGPU 1個あたりの速さ
出典:NVIDIA 製品ページ
あわせて読みたい
【完全図解】NVLinkとは?「1台の巨大GPU」を作る技術とスケールアップ/スケールアウトの違い
1台の巨大GPUを作るNVLinkと、スケールアップ/スケールアウト
計算用の網はGPUごとのレール
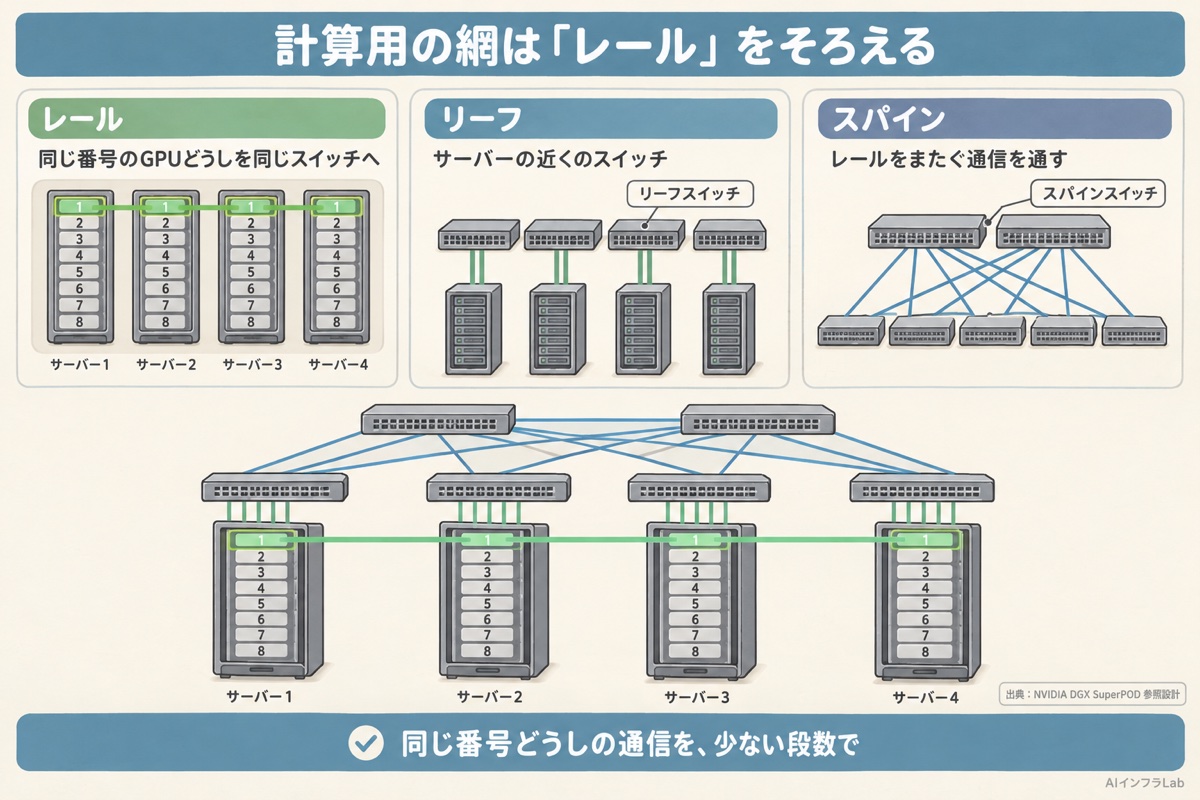
計算用の網は、GPUサーバーの中の8つのGPUそれぞれに、外へつながる口を持たせます。NVIDIAの参照設計では、32台のサーバーごとに、同じ番号のGPUどうしを同じスイッチにつなぐ「レールをそろえた」形にしています。同じ番号のGPUどうしの通信が、少ないスイッチの段数で済むようにするためです。
レール
サーバーの1番のGPUどうし、2番のGPUどうし…を、それぞれ同じスイッチにまとめた通り道。
リーフとスパイン
サーバーの近くのスイッチ(リーフ)と、リーフどうしを結ぶ上のスイッチ(スパイン)の2段。レールをまたぐ通信はスパインを通ります。
技術の選び方
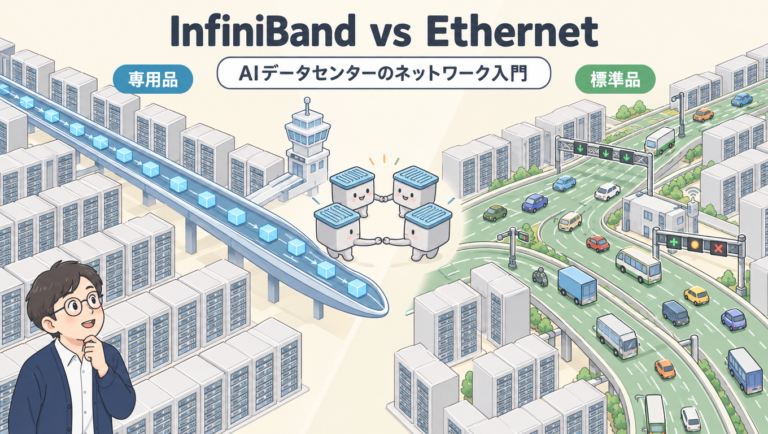
InfiniBand は遅れが少なく混雑に強い専用の技術。Ethernet は広く使われ、AI向けに混雑の制御を強めた製品も出ています。
あわせて読みたい
【完全図解】InfiniBandとEthernetの違いとは?AIデータセンターのネットワークを1から理解する
InfiniBandとEthernetは何が違う?計算用の網の2つの技術
ストレージ用・管理用・帯域外の管理用の網
| 網 |
役割 |
参照設計(DGX H100)の技術 |
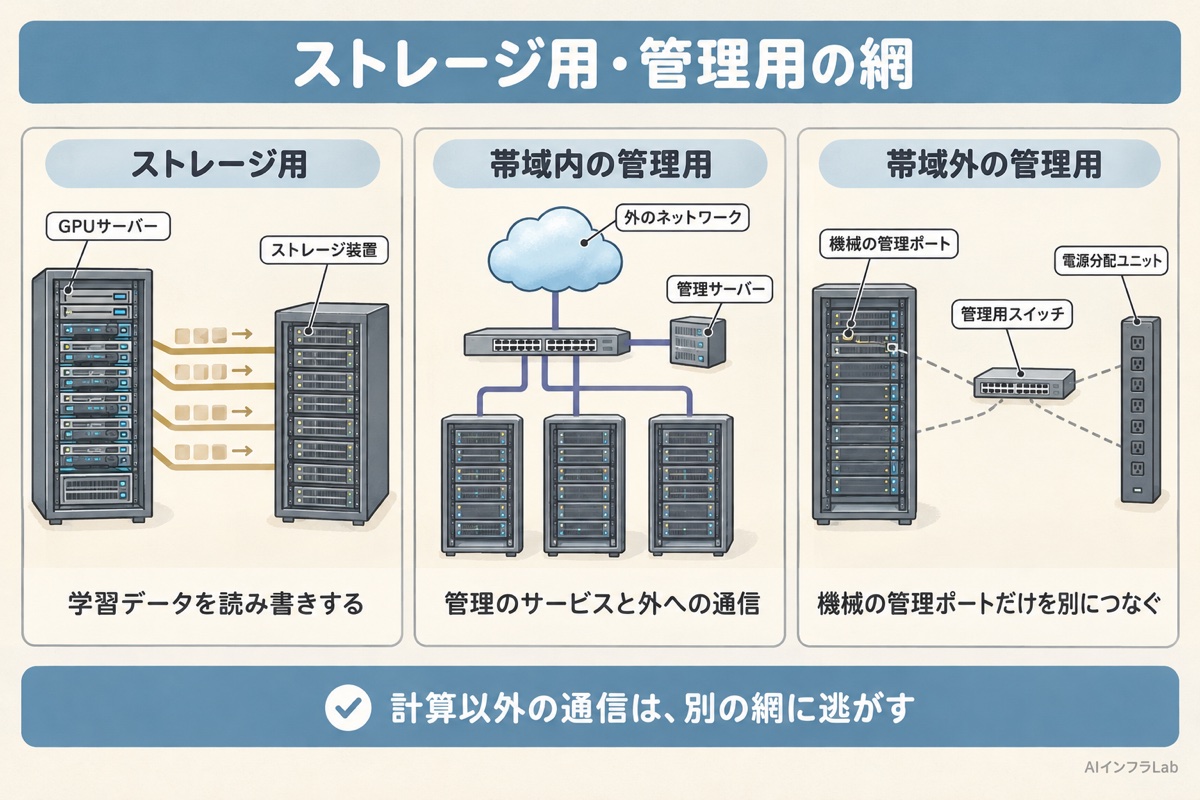
| ストレージ用 | 学習データやチェックポイントを、GPUサーバーとストレージの間で読み書きする | InfiniBand |
| 帯域内の管理用 | クラスタを管理するサービスをつなぎ、ホームのファイルや外への通信も通す | Ethernet |
| 帯域外の管理用 | サーバー・管理サーバー・ストレージ・スイッチ・ラックの電源(PDU)の管理ポートをつなぐ | Ethernet |
ストレージ用の網は、学習のあいだ大量のデータを読み込み、途中経過(チェックポイント)を書き出すための道です。帯域外の管理用の網は、ほかの網に問題が起きても、機械の電源や状態を確かめられるように、管理の口だけを別につなぎます。
注意:網に使う技術は、世代や設計によって変わります。NVIDIAの新しい世代の参照設計では、ストレージ用と帯域内の網をEthernetにまとめる形も出てきています。
この記事の「5つの網」は、筆者が決めた分け方ではありません。NVIDIA の DGX GB200 の参照設計を読むと、網は5つと書かれ、それを4つの物理的な網で運ぶとありました。ストレージ用と帯域内の管理用は、GB200 の世代から1つの Ethernet の網に相乗りしています。H100 の参照設計では、ストレージ用は InfiniBand でした。網の数は同じでも、ケーブルの数え方は世代で変わります。
電源の設計者の目でいちばん身近なのは、帯域外の管理用の網です。ラックの電源(PDU)の状態は、本番の網が止まったときにこそ見たい。電源の監視を本番と同じ網に載せると、障害のときに肝心の電源が見えなくなります。管理の口だけを別の網に出すのは、この理由です。
網をつなぐのは、ほとんどが光
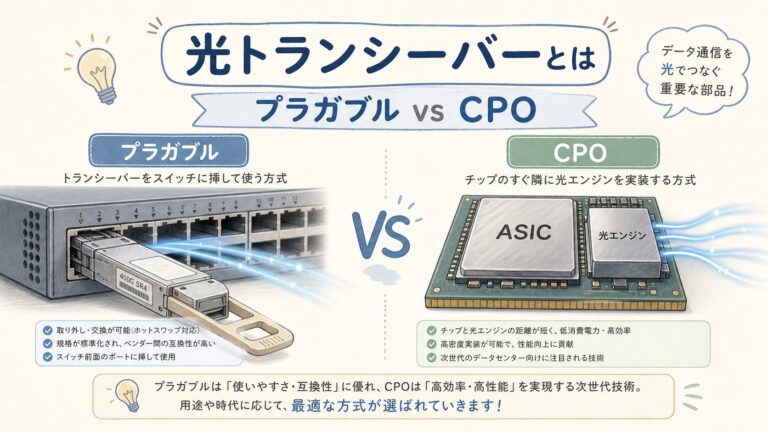
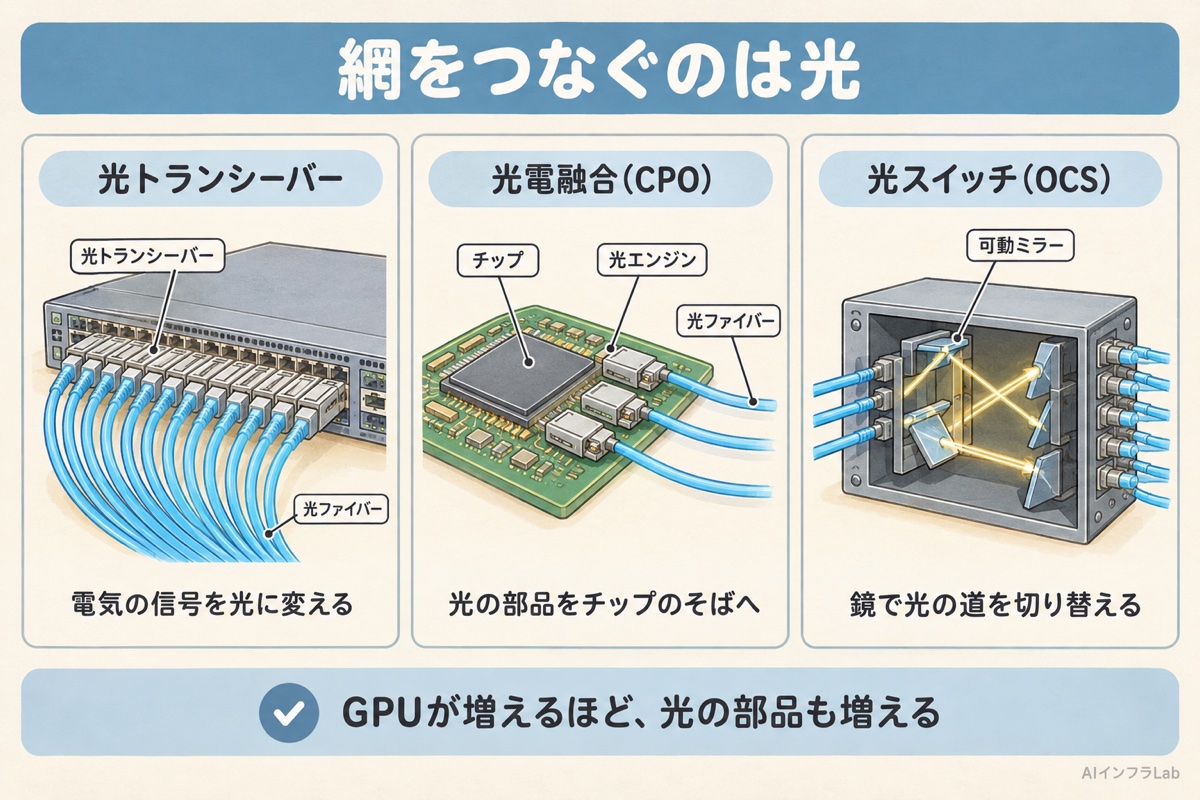
ラックの外の網は距離が長く、速さも求められるため、ケーブルの多くは光ファイバーです。GPUサーバーやスイッチの口には、電気の信号を光に変える光トランシーバーを挿します。GPUの数が増えるほど、光トランシーバーとケーブルの数も増え、その電力も無視できなくなります。
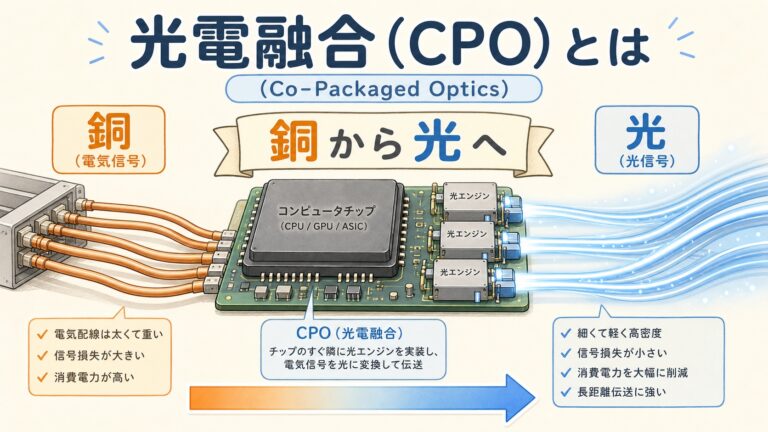
そこで、光の部品をスイッチのチップのすぐそばに置く光電融合(CPO)や、鏡で光の通り道を切り替える光スイッチ(OCS)が注目されています。網の構成が変わると、使う光の部品も変わります。
あわせて読みたい
プラガブルとは?光トランシーバーの意味・仕組みとCPOとの違いを図解
光トランシーバーとは?プラガブルとCPOの違い
ネットワークの構成を知ると、何が見えてくるか
あなたにとっての意味
仕事で関わる方へ:設備・サーバー・ネットワークの仕事では、どの網の話をしているのかを最初にそろえるだけで、会議の行き違いが減ります。「速い網」の話をしているのか、「管理の網」の話をしているのかで、必要な機器も配線も変わります。
投資家の方へ:AIのネットワークの需要は、NVLink・計算用の網・光の部品と、網ごとに受け手の会社が違います。ニュースがどの網の話かを見分けると、恩恵を受ける会社の見当がつきます。
学生・就活中の方へ:ネットワークは、ソフト(通信の約束事)とハード(スイッチ・光の部品)の両方が関わる分野です。AIの計算を速くする裏方として、情報・電気・光のどの学生にも入口があります。
よくある誤解
誤解1:AIデータセンターのネットワークは1つの網
役割ごとに5つの網に分けて考えます。いちばん大事な計算の通信には、専用の網を用意します。
誤解2:NVLinkとInfiniBandは、同じことをする競合の技術
NVLinkはラックの中のGPUどうし、InfiniBandなどの計算用の網はラックの外のGPUどうしをつなぎます。役割が違います。
誤解3:管理用の網はおまけ
帯域外の管理用の網は、ほかの網が止まったときに機械を見に行くための大事な道です。
まとめ
- AIデータセンターのネットワークは、役割ごとに5つの網で考える
- ラックの中はNVLink(GB200 NVL72は72GPUを1つの網に)
- ラックの外のGPUどうしは計算用の網(InfiniBandや高速のEthernet)
- ほかにストレージ用・帯域内の管理用・帯域外の管理用の網がある
- 網をつなぐのはほとんどが光で、光電融合や光スイッチが次の焦点
よくある質問
Q. AIデータセンターのネットワーク構成は?
A. NVLink・計算用・ストレージ用・帯域内の管理用・帯域外の管理用の5つの網に分けて考えるとわかりやすくなります。
Q. バックエンドとフロントエンドのネットワークの違いは?
A. 一般に、GPUどうしの計算の通信を運ぶ網をバックエンド、利用者や管理のサービス、外のネットにつながる網をフロントエンドと呼びます。
Q. なぜネットワークを分けるのですか?
A. 計算の通信は少しの遅れでも全体が待たされるので、データの読み書きや管理の通信と混ざらないよう、専用の網を用意します。
Q. NVLinkとInfiniBandの違いは?
A. NVLinkはラックの中のGPUどうしを、InfiniBandはラックの外のGPUサーバーどうしをつなぐのが主な役目です。
この記事のテーマを、本でもっと深くPR(アフィリエイト広告)
ネットワークの両端にあるGPUの側から、理解を深めたい方に。本書(技術評論社)は、GPUの超並列処理の仕組みやデバイスメモリ、CPUとGPU間のデータ伝送を解説した技術書で、RoCE(Remote DMA on Converged Ethernet)のコラムも収めています。
楽天ブックス
¥3,608 (2026/11/01 08:16時点 | 楽天市場調べ)
 ポチップ
S
シラス
電験三種・QC検定1級 / メーカーでパワエレ設計・品質保証 実務10年
メーカーで回路設計と生産技術(品質改善)に携わってきた経験をもとに、AIインフラを支える半導体・電力・冷却の仕組みを、図解でやさしく解説しています。
テーマ別に、もっと深く学ぶ
気になるところから読んでも大丈夫です。どの記事も、はじめての方にもわかるように図解で書いています。
AIデータセンターをもっと深く
つまずきやすい「違い」を解決
あわせて知りたい、隣のテーマ



コメント