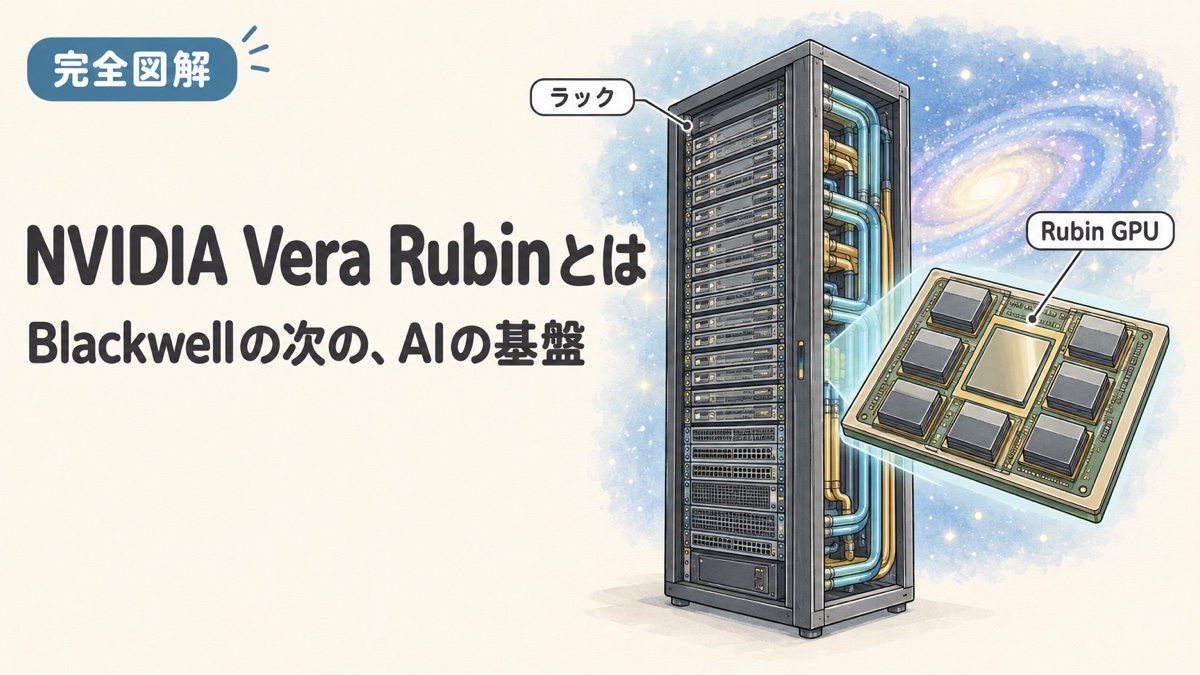
NVIDIA(エヌビディア)の Vera Rubin(ベラ・ルービン)とは、いまの主役 Blackwell(ブラックウェル)の次の世代の、AIデータセンター向けの基盤です。GPU の名前ではなく、GPU・CPU・通信の6つのチップと、それをまとめたラックの一式を指します。
この記事は、NVIDIA の2026年1月の発表と技術ブログ、2026年8月の決算発表の中身から整理しました。電源と冷却への影響まで追っています。
先に読みたい節 6つのチップ/Vera Rubin NVL72 のラックの中身/電源と冷却への影響
あなたが今いる場所:AIインフラ > AIデータセンター入門 > NVIDIA Vera Rubinとは
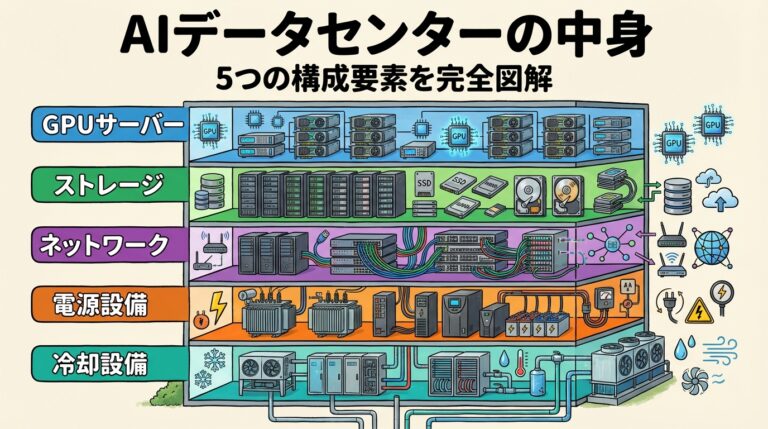
AIデータセンターの5つの構成要素
計算(GPUサーバー) ←ココ
記憶(ストレージ)
通信(ネットワーク)
電力供給
排熱処理(冷却)
NVIDIA のデータセンター向けの世代
Hopper→Blackwell→Vera Rubin ←ココ→Rubin Ultra
NVIDIA Vera Rubinとは
先に結論
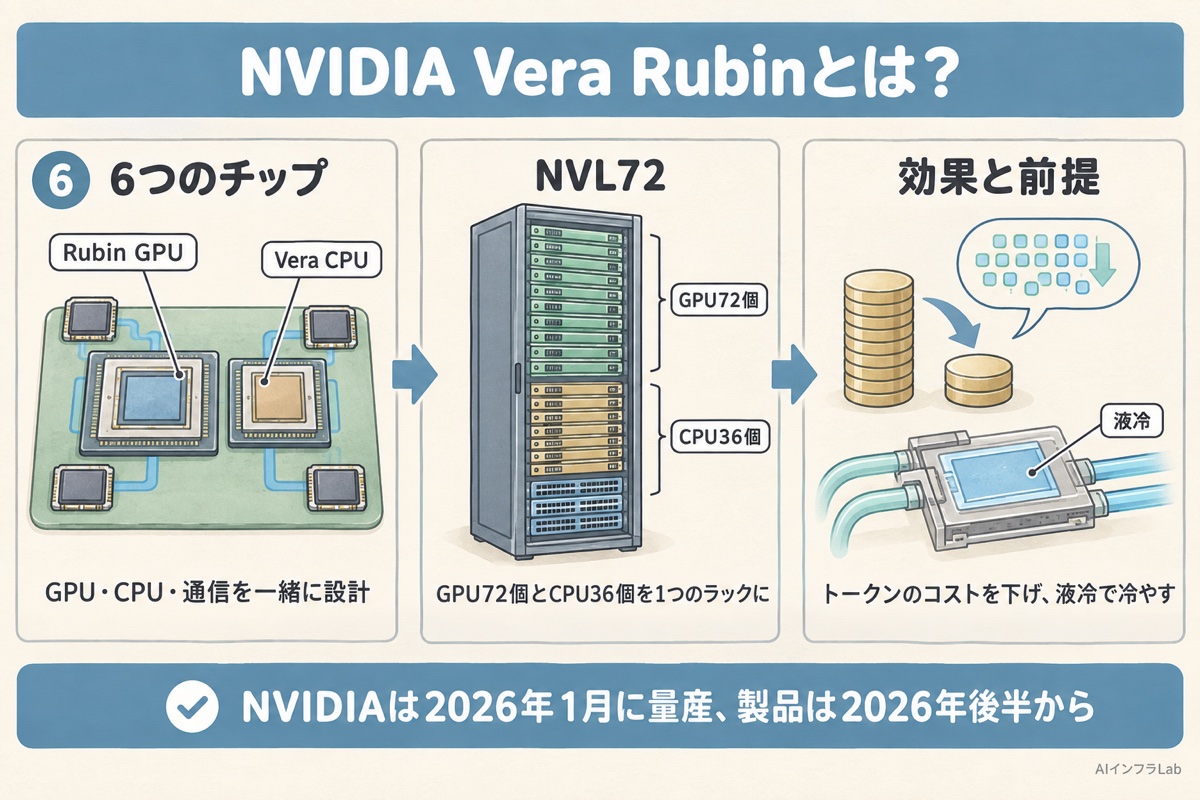
NVIDIA Vera Rubinとは、Rubin という名前のGPUと、Vera という名前のCPUを中心に、通信やネットワークのチップまで含めた6つのチップを一緒に設計した、AIデータセンター向けの基盤(プラットフォーム)です。Blackwell の次の世代にあたります。
代表的な製品は、72個のGPUと36個のCPUを1つのラックにまとめた「Vera Rubin NVL72」です。NVIDIA は、Blackwell と比べて、AIが答えを作るときのコスト(トークンのコスト)を最大10分の1にできると発表しています。GPUのそばのメモリは HBM4 になり、計算と通信のトレイは完全に液冷です。NVIDIA は2026年1月に量産に入ったとし、2026年8月には、パートナーのデータセンターでラックが動き始めたと発表しています。
用語メモ:プラットフォーム
GPUだけでなく、CPU・通信のチップ・ラックまでをまとめた、データセンター向けの一式。NVIDIA は世代ごとに一式で設計しています。
用語メモ:トークン
AIが文章を読み書きするときの単位。言葉の切れはしのようなもので、AIの答えはトークンを1つずつ作って組み立てられます。
名前と位置づけ:Hopper・Blackwell の次
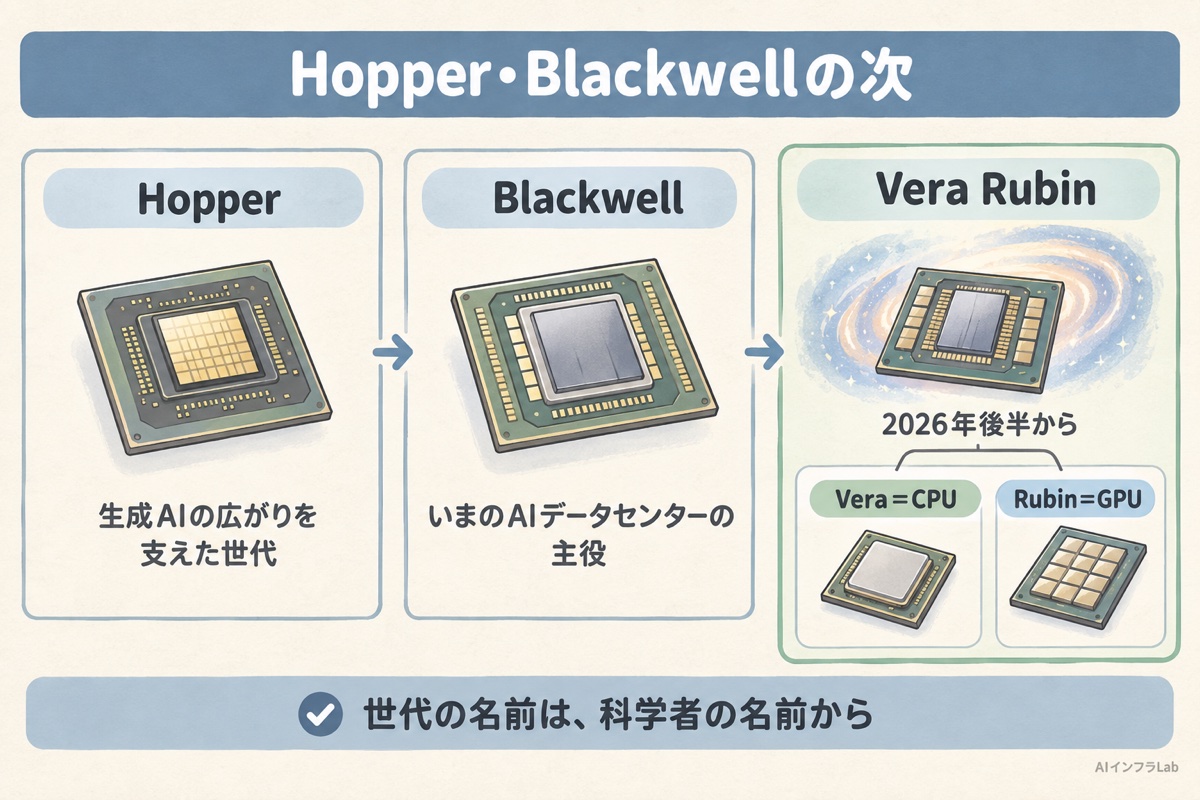
NVIDIA は、データセンター向けの世代に、科学者の名前をつけてきました。Vera Rubin は、銀河の回転から「見えない物質(暗黒物質)」の存在を示した天文学者の名前です。
| 世代 |
主なGPU |
位置づけ |
| Hopper | H100・H200 | 生成AIの広がりを支えた世代 |
| Blackwell | B200・B300(GB200・GB300) | いまのAIデータセンターの主役 |
| Vera Rubin | Rubin(Vera Rubin NVL72) | 2026年後半から導入が始まった。この記事の主役 |
「Vera」はCPUの名前、「Rubin」はGPUの名前で、2つを合わせて基盤全体を「Vera Rubin」と呼びます。Blackwell の世代で、GPUとCPUを組み合わせた製品を「GB200」と呼んでいたのと同じ考え方です。
あわせて読みたい
NVIDIA GB300(B300)とは?仕様・価格・B200との違いを図解|Blackwell Ultra
Blackwell の最新形、GB300(Blackwell Ultra)の中身
Vera Rubin を構成する6つのチップ
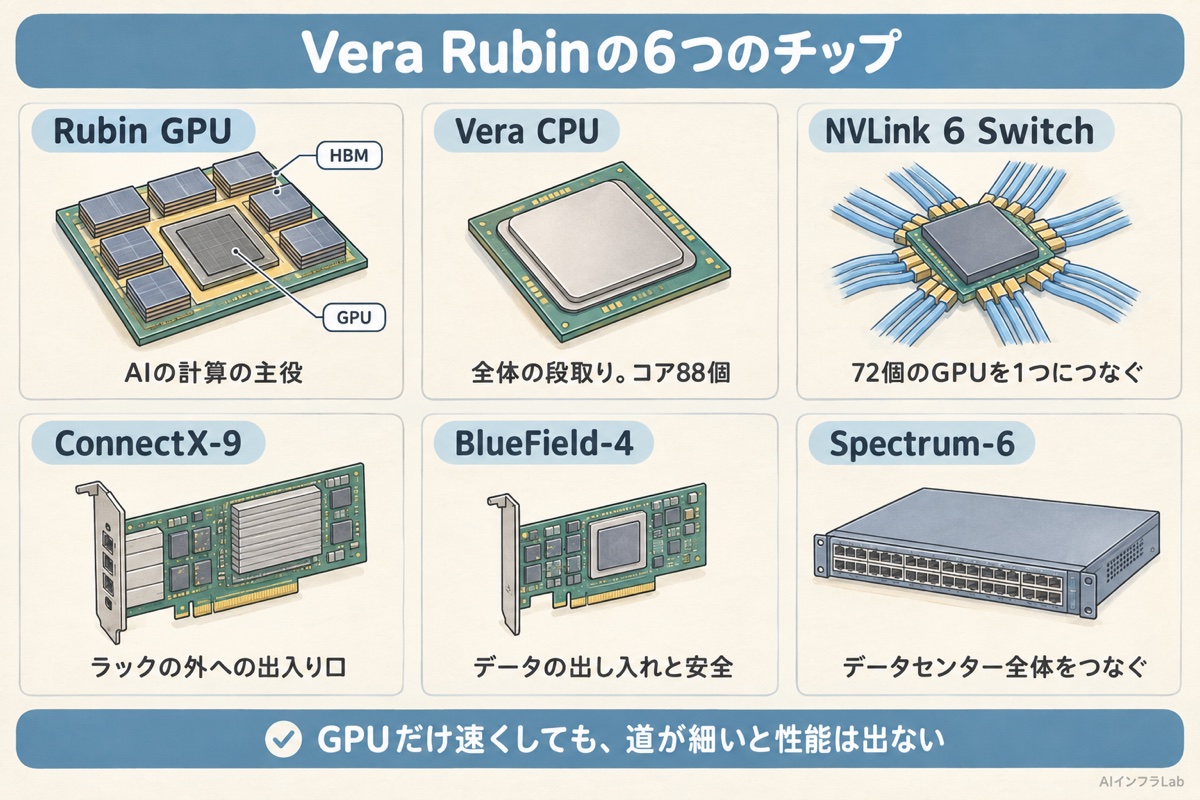
NVIDIA は、Rubin を「6種類のチップを一緒に設計した」基盤だと説明しています。GPUだけを速くしても、データを運ぶ道が細いと性能が出ないためです。
| チップ |
役割 |
| Rubin GPU | AIの計算の主役。GPUのそばに HBM4 を置く |
| Vera CPU | 全体の段取りをとるCPU。NVIDIA が自社で設計したコアが88個 |
| NVLink 6 Switch | ラックの中の72個のGPUを、1つの巨大なGPUのようにつなぐ |
| ConnectX-9 SuperNIC | ラックとラックをつなぐ、ネットワークの出入り口 |
| BlueField-4 DPU | データの出し入れや安全の管理を、CPUの代わりに受け持つ |
| Spectrum-6 Ethernet Switch | データセンター全体をつなぐ、ネットワークのスイッチ |
あわせて読みたい
【図解】GPUとCPUの違いとは?AIの計算にGPUが使われる理由を7つの視点で比較
GPUとCPUの違い。AIの計算にGPUが使われる理由
Vera Rubin NVL72:ラックの中身
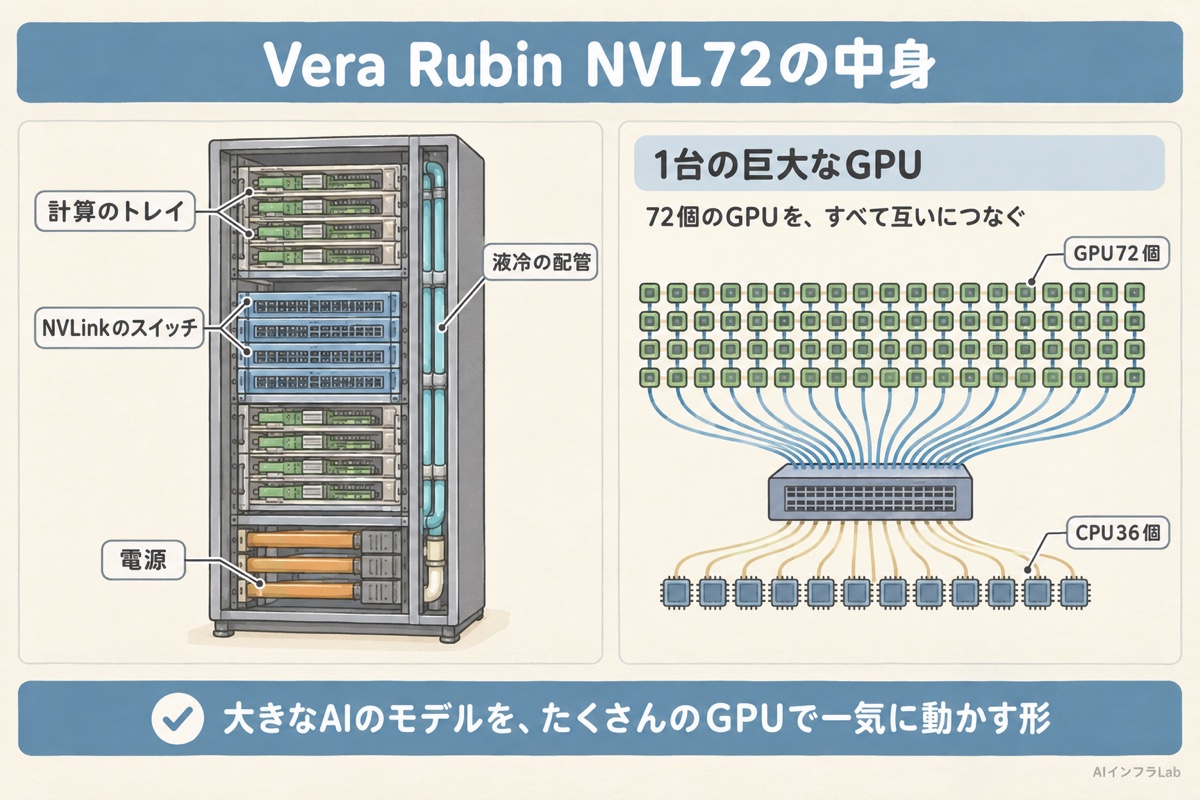
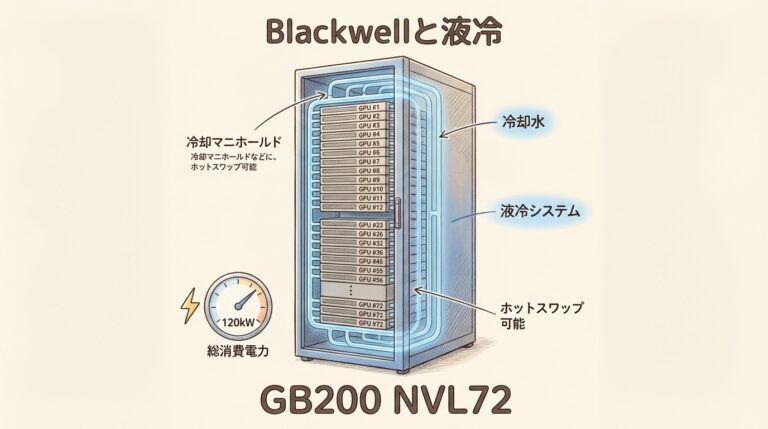
Vera Rubin の代表的な製品は、1つのラックに72個のGPUを入れた「Vera Rubin NVL72」です。
72個
Vera Rubin NVL72 の Rubin GPU の数(Vera CPU は36個)
出典:NVIDIA Newsroom(2026年1月5日)
3TB/s
NVLink 6 の GPU 1個あたりの双方向の帯域
出典:NVIDIA Technical Blog
| 中身 |
やること |
| 計算のトレイ | Rubin GPU と Vera CPU を載せた板。ラックに何枚も差し込む |
| NVLink のスイッチのトレイ | 72個のGPUを、すべて互いに高速でつなぐ |
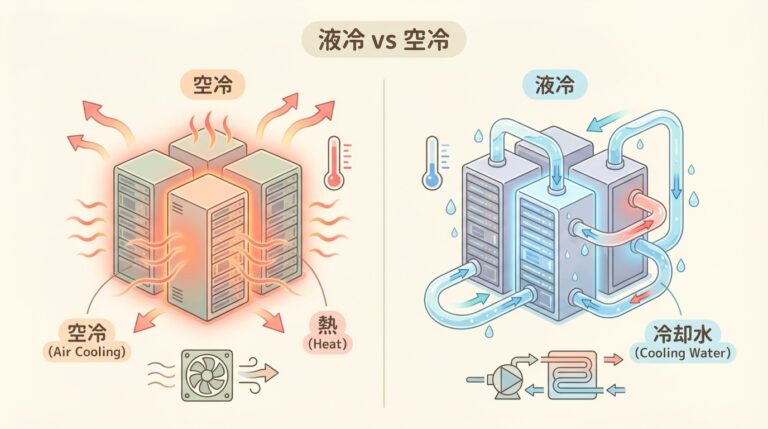
| 液冷の配管 | 計算と通信のトレイを、すべて液体で冷やす |
| 電源 | ラック全体に大きな電力を配る |
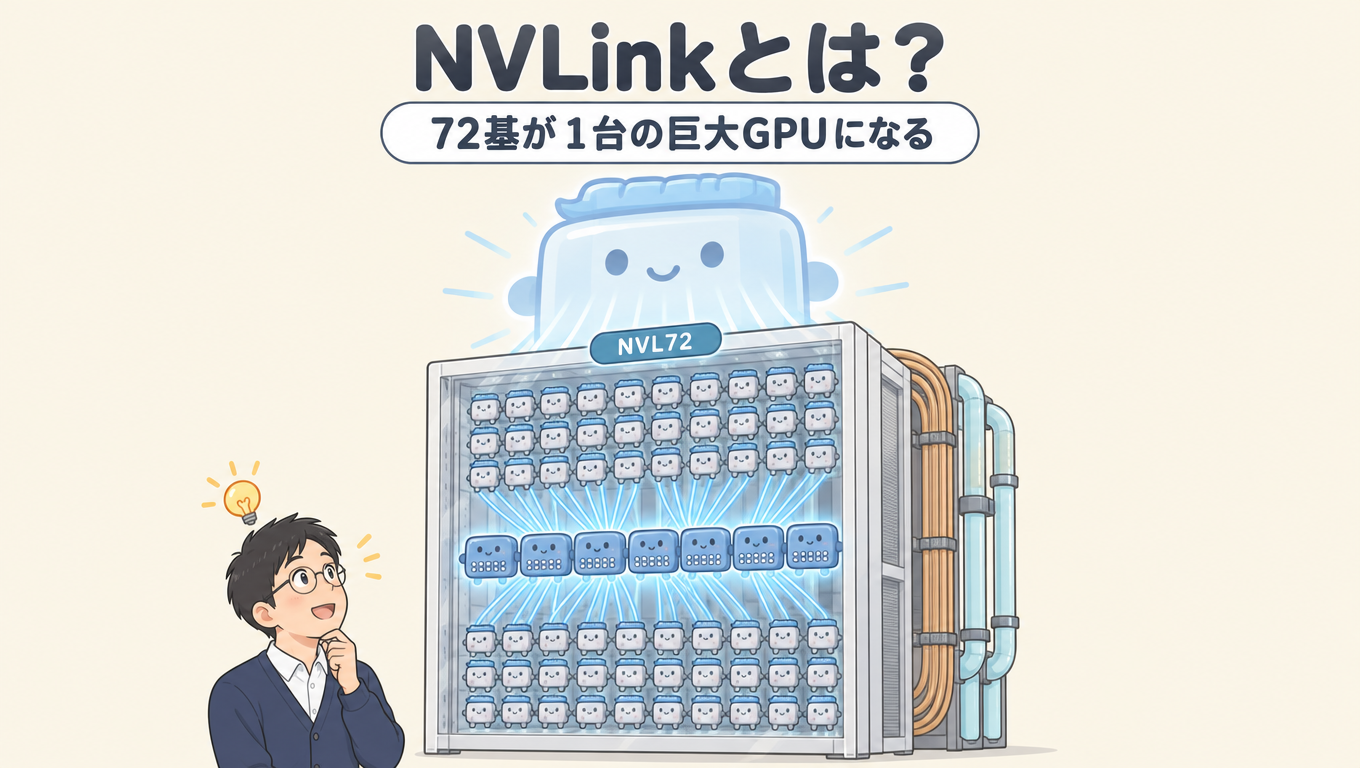
72個のGPUを NVLink でつなぐことで、ラック全体を「1台の巨大なGPU」のように使えます。大きなAIのモデルを、たくさんのGPUに分けて一気に動かすための形です。
あわせて読みたい
【完全図解】NVLinkとは?「1台の巨大GPU」を作る技術とスケールアップ/スケールアウトの違い
「1台の巨大GPU」を作る技術、NVLink の仕組み
Blackwell と比べて、何が良くなるのか
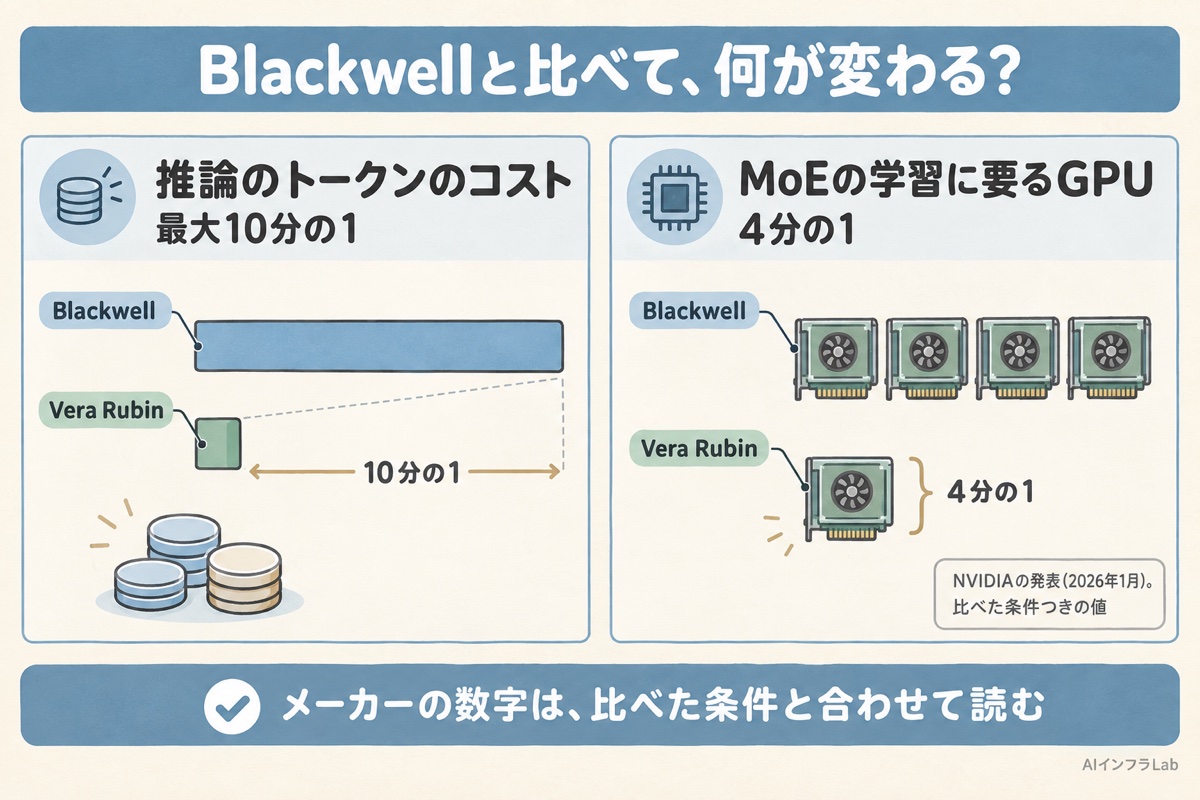
NVIDIA の発表では、Rubin GPU 1個の性能と、ラック全体での効果は次のとおりです。
| 項目 |
NVIDIA の発表 |
| 推論の計算(NVFP4) | GPU 1個あたり50PFLOPS |
| 学習の計算(NVFP4) | GPU 1個あたり35PFLOPS |
| 推論のトークンのコスト | Blackwell と比べて最大10分の1 |
| MoE モデルの学習に要るGPUの数 | Blackwell と比べて4分の1 |
注意:「最大10分の1」は、NVIDIA が特定の条件で比べた値です。実際のコストは、モデルの種類や使い方、電気代などで変わります。メーカーの発表の数字は、比べた条件と合わせて読む必要があります。
用語メモ:NVFP4
4ビットの細かさで数を表す、NVIDIA の数の形式。計算を軽くして、同じ電力でより多くの計算ができるようにします。
GPUのそばのメモリは HBM4 に
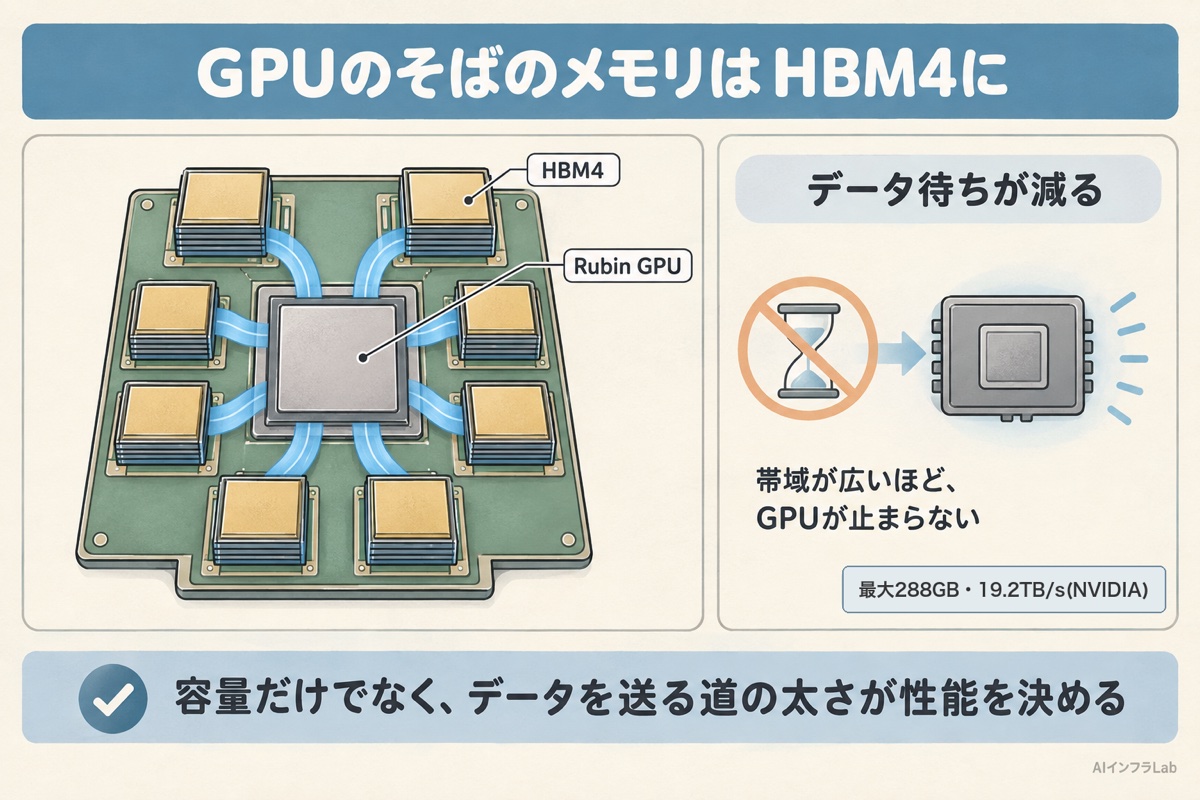
Rubin GPU は、GPUのそばのメモリに、新しい世代の HBM4 を使います。
19.2TB/s
Rubin GPU の HBM4 の帯域(最大。容量は最大288GB)
出典:NVIDIA Technical Blog
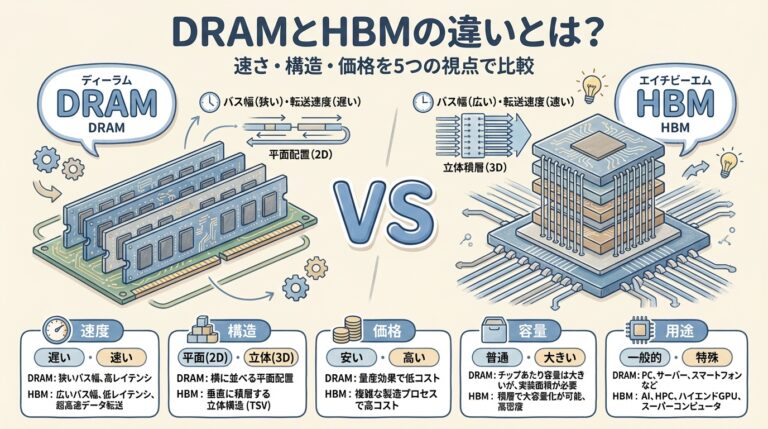
容量は、Blackwell Ultra(GB300)と同じ288GBですが、HBM4 になってデータを送る道(帯域)が大きく広がります。AIの推論では、モデルの重みや途中の計算結果を、GPUがメモリから休みなく読み出します。帯域が広いほど、GPUが「データ待ち」で止まる時間が減ります。
NVIDIAは2026年8月まで、Rubin GPUのHBM4の帯域を22TB/s、NVLinkを3.6TB/sと示していましたが、9月に製品ページの値を19.2TB/sと3TB/sへ書き直しました(発表はなし。容量の288GBは同じ)。何が変わり、なぜ大事かはHBM4Eの記事の「Vera RubinのHBM4帯域が下がった件」で図にしています。
あわせて読みたい
【完全図解】HBM4とは?HBM3Eとの違い・2048bitの仕組みと3社の量産状況
次世代のAIメモリ HBM4 は、何が変わるのか
製品ページでHBM4の帯域が22から19.2TB/sに変わった件を、容量は同じで「運ぶ速さ」が変わった話として1枚の図で見せるショート動画です。
データセンターの電源と冷却への影響
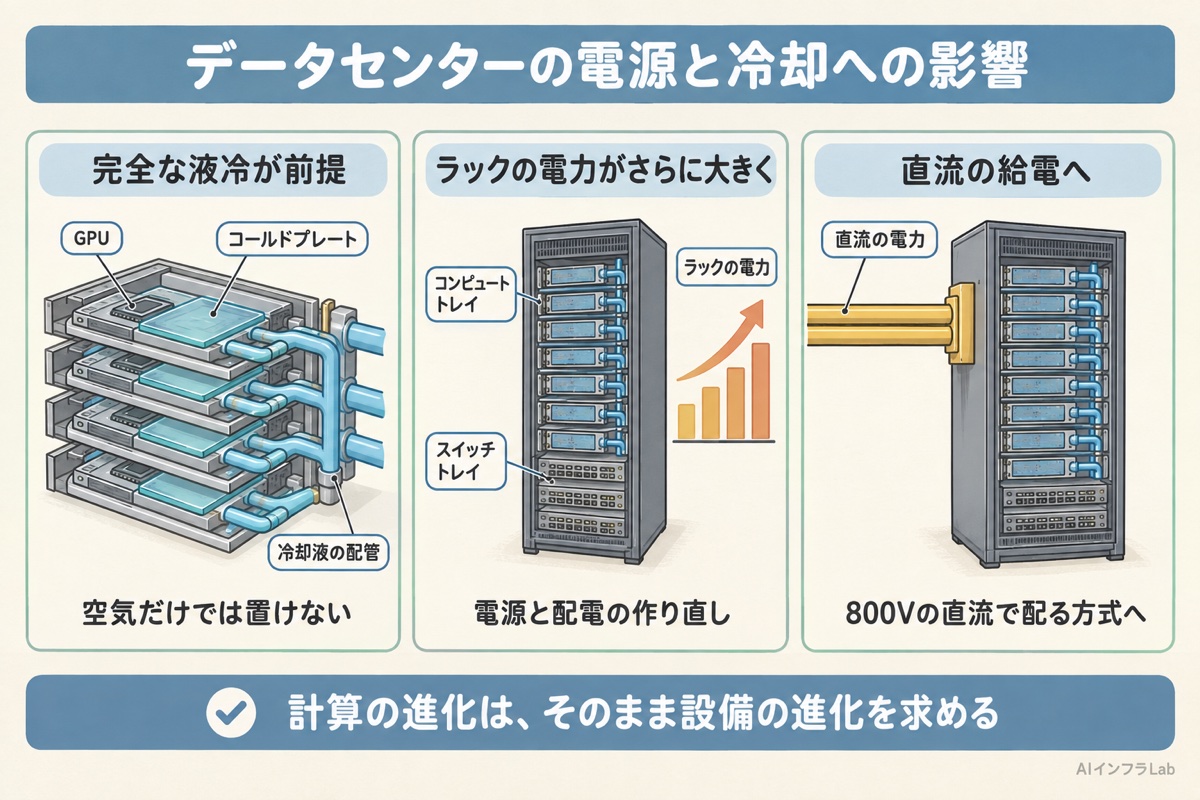
完全な液冷が前提
NVIDIA は、計算と通信のトレイを完全に液冷にしています。空気だけで冷やすデータセンターでは、そのままでは置けません。
ラックの電力がさらに大きく
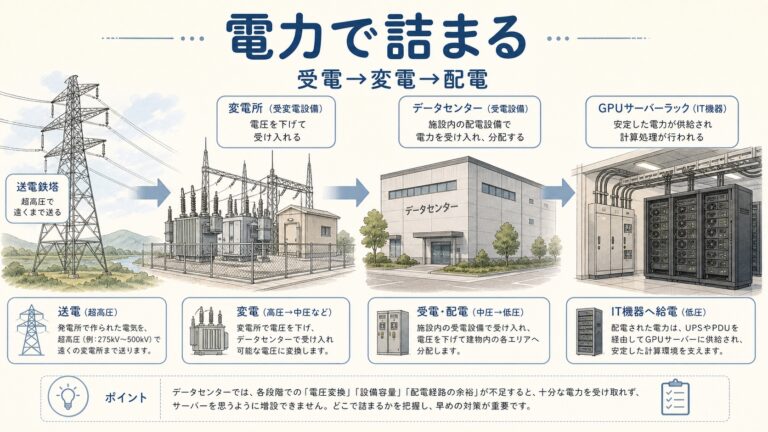
1つのラックに入る計算が増えるほど、ラックが使う電力も大きくなります。電源設備と配電の作り直しが必要になります。
直流の給電へ
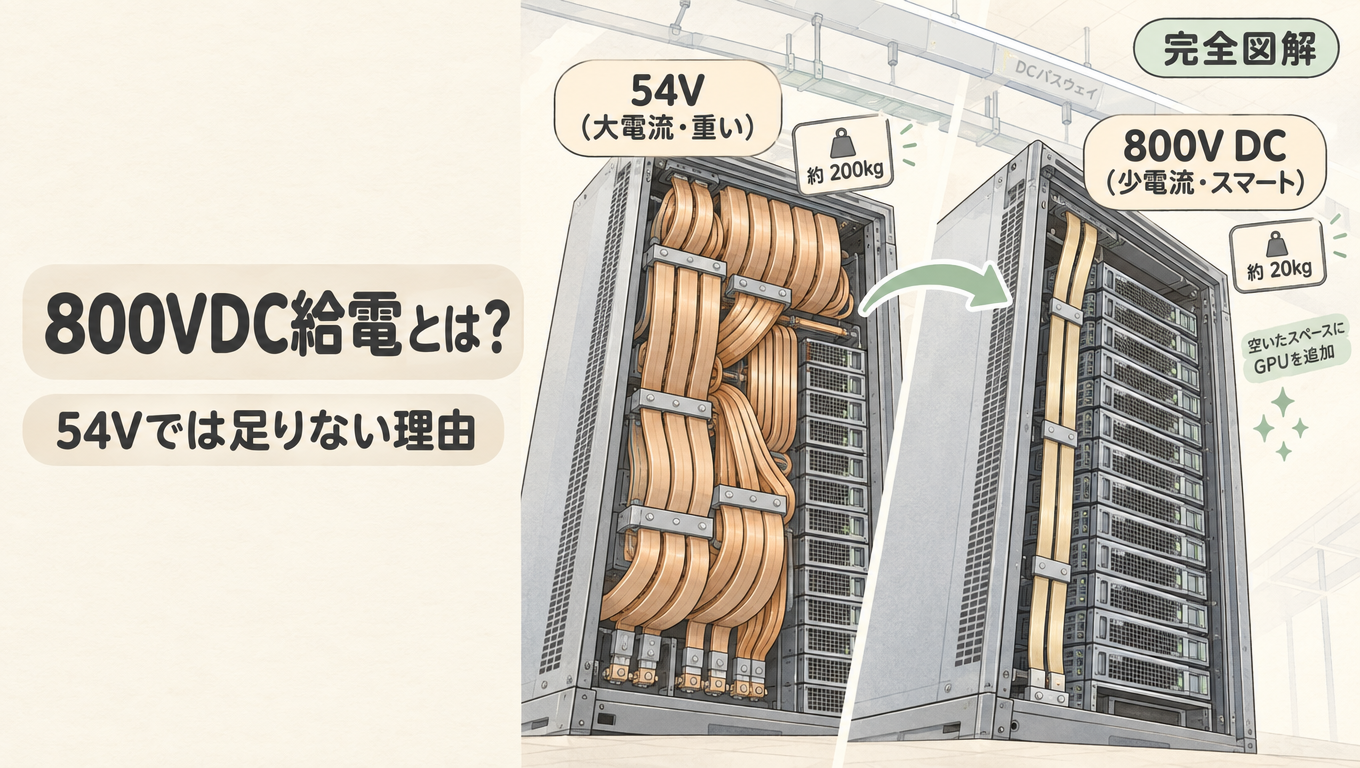
NVIDIA は、さらに先の世代に向けて、ラックへ800Vの直流で電気を配る方式への移行を進めています。
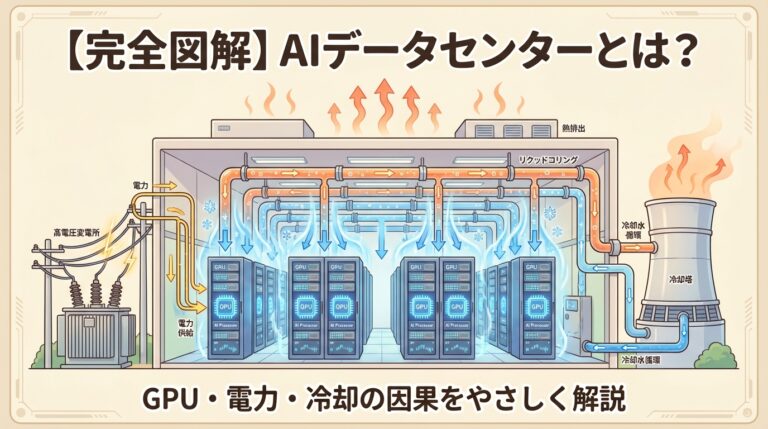
Vera Rubin のような新しい世代が出るたびに、データセンターは「計算」だけでなく「電力」と「冷却」も作り直すことになります。AIの計算の進化は、そのまま設備の進化を求めます。
もっと深く知りたい方へ:4つのボトルネック別ガイド
AIデータセンターは「計算・電力・冷却・通信」の4つで詰まります。気になるところから進んでください。
Vera Rubin のこれから
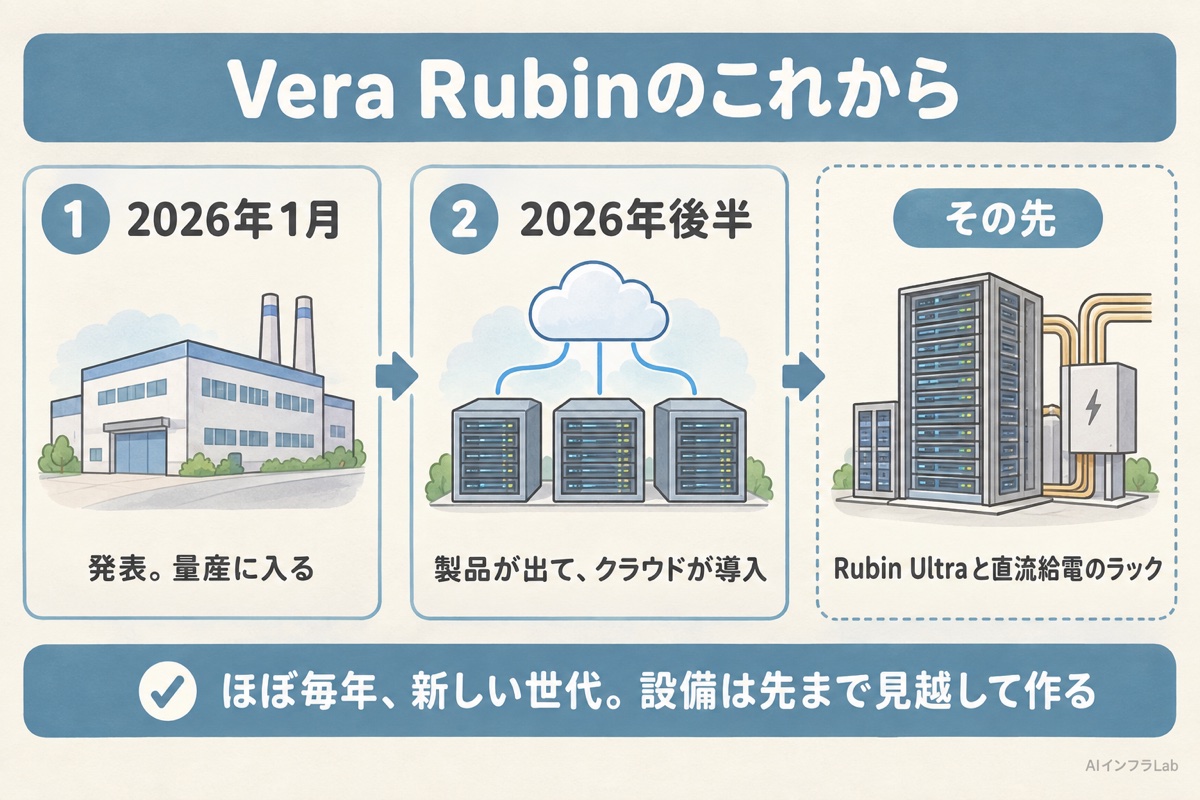
NVIDIA は2026年1月に、Rubin が量産に入り、AWS・Google Cloud・Microsoft・OCI などのクラウドが2026年後半から導入すると発表しました。2026年8月26日の決算発表では、Vera Rubin が本格的な量産に向かっており、CoreWeave・Google Cloud・Microsoft Azure・Oracle Cloud Infrastructure・Nebius でラックが動いているとしています(2026年10月時点の公開情報)。その先には、さらに大きな構成の Rubin Ultra が控えています。
| 時期(NVIDIA の発表) |
出来事 |
| 2026年1月 | Rubin プラットフォームを発表。量産に入る |
| 2026年後半 | パートナーのデータセンターでラックが動き始める(2026年8月の決算発表) |
| その先 | Rubin Ultra と、800Vの直流で給電する新しいラックへ |
NVIDIA は、ほぼ毎年のように新しい世代を出しています。データセンターを作る側にとっては、建物が完成するころには次の世代が出ている、という速さです。電源と冷却を、先の世代まで見越して設計することが大事になっています。
あわせて読みたい
【完全図解】800VDC給電とは?NVIDIAがラック直流化に踏み切った理由と、54Vでは足りなくなった構造
NVIDIA がラックの直流化に踏み切った理由、800VDC給電
Vera Rubin を知ると、何が見えてくるか
あなたにとっての意味
仕事で関わる方へ:データセンターの電気・冷却・ネットワークのどの担当でも、新しい世代のGPUは「液冷が前提」「ラックの電力がさらに増える」ことを意味すると知っておくと、設備の計画の話が具体的になります。
投資家の方へ:Vera Rubin の立ち上がりは、HBM4・先端パッケージ・液冷・電源・光の通信など、まわりの部品と設備の需要にもつながります。NVIDIA の発表の数字は、比べた条件とあわせて読むのが安全です。
学生・就活中の方へ:Vera Rubin は、チップ・メモリ・通信・冷却・電源を一緒に設計した、システム全体の工学の例です。情報系・電気電子・機械系の学生にとって、分野をまたいだ設計の考え方を学ぶよい題材です。
よくある誤解
誤解1:Vera Rubin は1つのGPUの名前
Rubin がGPU、Vera がCPUの名前で、Vera Rubin は6つのチップをまとめた基盤全体の名前です。
誤解2:性能が上がるので、データセンターの電気は減る
同じ計算あたりの効率は上がりますが、1つのラックに入る計算が増えるため、ラックの電力は大きくなります。
誤解3:発表された性能が、そのまま使える
「最大10分の1」などは NVIDIA が特定の条件で比べた値です。実際の効果は、使い方や設備で変わります。
まとめ
- Vera Rubin は、Rubin GPU と Vera CPU を中心にした、6つのチップのAI基盤
- Vera Rubin NVL72 は、72個のGPUと36個のCPUを1つのラックにまとめる
- NVIDIA は、Blackwell と比べて推論のトークンのコストを最大10分の1と発表
- GPUのそばのメモリは HBM4 になり、帯域が大きく広がる
- 完全な液冷が前提で、電源と冷却の作り直しを求める
よくある質問
Q. NVIDIA Vera Rubin とは何ですか?
A. Rubin GPU と Vera CPU を中心に、通信のチップまで含めた6つのチップで作る、Blackwell の次の世代のAI基盤です。
Q. Vera Rubin NVL72 とは何ですか?
A. 72個の Rubin GPU と36個の Vera CPU を1つのラックにまとめ、NVLink でつないだ製品です。
Q. Vera Rubin はいつ使われ始めますか?
A. NVIDIA は2026年1月に量産に入ったとし、2026年8月の決算発表では、CoreWeave・Google Cloud・Microsoft Azure などのデータセンターでラックが動いているとしています。
Q. Vera Rubin のメモリは何ですか?
A. GPUのそばのメモリは HBM4 です。NVIDIA の製品ページでは、容量288GB・帯域19.2TB/sです(2026年8月までは22TB/sと示していました)。
この記事のテーマを、本でもっと深くPR(アフィリエイト広告)
Vera Rubin のような新しい世代を毎年出し続ける NVIDIA という会社を知りたい方に。本書(ダイヤモンド社)は、ジェンスン・フアンの生い立ちと創業から、瀕死の経験、CUDAの開発、AI革命への適応までをたどり、同社の長期戦略や経営思想を描いたノンフィクションです。
¥2,640 (2026/10/05 21:04時点 | Amazon調べ)
 ポチップ
S
シラス
電験三種・QC検定1級 / メーカーでパワエレ設計・品質保証 実務10年
メーカーで回路設計と生産技術(品質改善)に携わってきた経験をもとに、AIインフラを支える半導体・電力・冷却の仕組みを、図解でやさしく解説しています。
テーマ別に、もっと深く学ぶ
気になるところから読んでも大丈夫です。どの記事も、はじめての方にもわかるように図解で書いています。
AIデータセンターをもっと深く
つまずきやすい「違い」を解決
あわせて知りたい、隣のテーマ



コメント