「DRAMとHBMって、どう違うの?」——そんなふうに感じていませんか?
こんな疑問はありませんか?
HBMはDRAMの一種って聞いたけど、どこが違うの?
「帯域幅が広い」って具体的にどれくらい速いの?
HBMのほうがすべてにおいて優れているの?
なぜAIにはHBMが必要で、普通のDRAMではダメなの?
この記事でわかること
DRAMとHBMの5つの比較視点(構造・帯域幅・消費電力・価格・用途)
「帯域幅が24倍」がどれだけすごいのか、たとえ話で理解
HBMが優れている場面とDRAMで十分な場面の違い
学生・技術者それぞれにとっての意味
先に結論
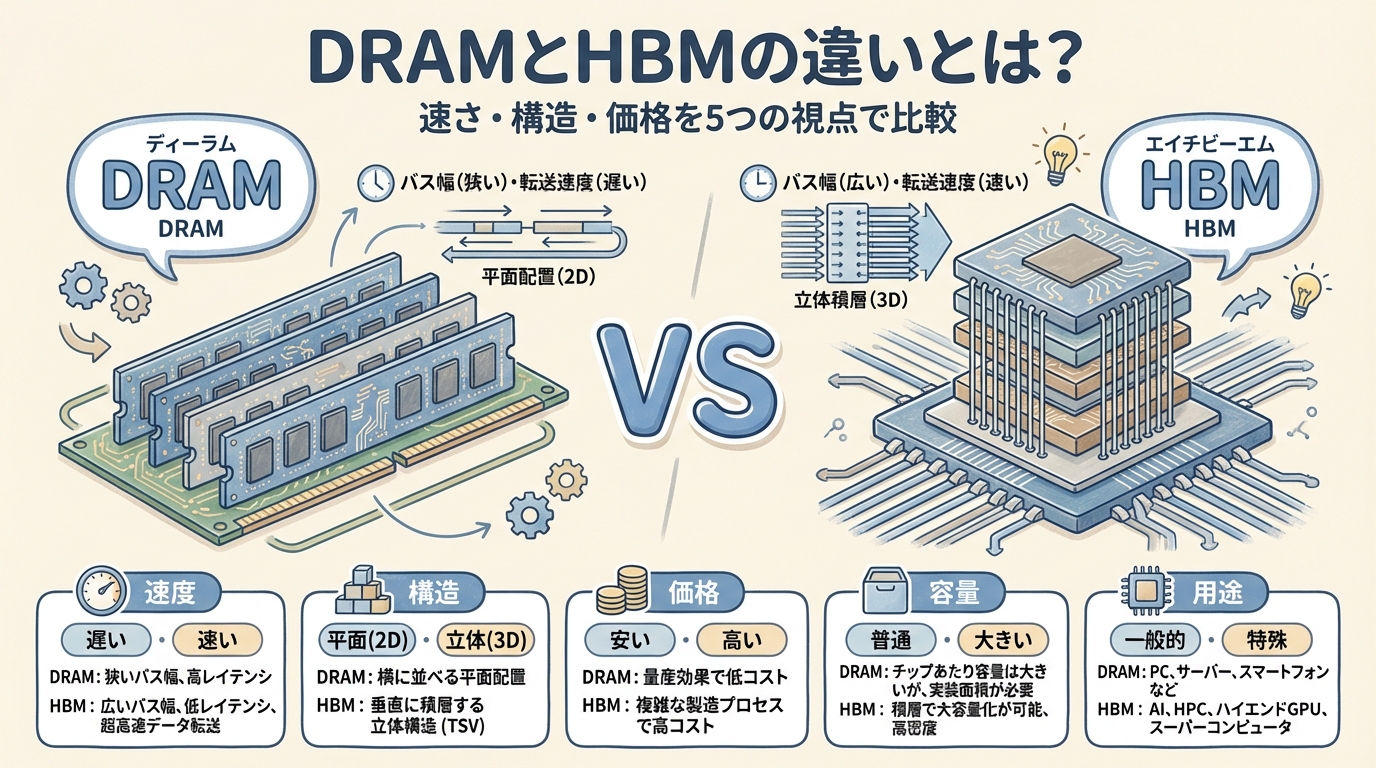
HBMはDRAMの「上位互換」ではありません。DRAMは安くて汎用的、HBMはAI専用の超高速・超高価なメモリです。両者の最大の違いは「構造」 :DRAMが平面に並ぶのに対し、HBMは縦に積み重ねます。この差が帯域幅・電力・価格すべての違いを生んでいます。「どちらが優れているか」は用途によります ——普通のPCにはDRAMで十分、AIアクセラレータにはHBM一択です。
HBMとは(30秒で)
HBM(エイチ・ビー・エム、High Bandwidth Memory)は、DRAMのチップを何枚も縦に積み、TSV(シリコン貫通電極)という細い電極で上下をつないだメモリです。GPUのすぐ隣に置き、非常に広い幅(1スタックで1,024ビット)でデータをやり取りします。つまり「HBMとDRAMの違い」は、素材の違いではなく
積み方とつなぎ方、置き場所の違い です。HBMそのものの仕組みは
HBMとは で解説しています。
まず「DRAM」とは何か? 1分で理解する
DRAM = コンピュータが「今使うデータ」を置く作業台
DRAMとは Dynamic Random Access Memory(ダイナミック・ランダム・アクセス・メモリ) の略です。CPUやGPUが処理するデータを一時的に保存する「作業台」のようなものです。
たとえるなら…
DRAMは「料理人の手元にある調理台」です。冷蔵庫(ストレージ)から食材を取り出して置き、包丁(CPU/GPU)で切ります。調理台が広いほど一度に多くの食材を並べられる。DRAMはこの「調理台」の役割を担います。
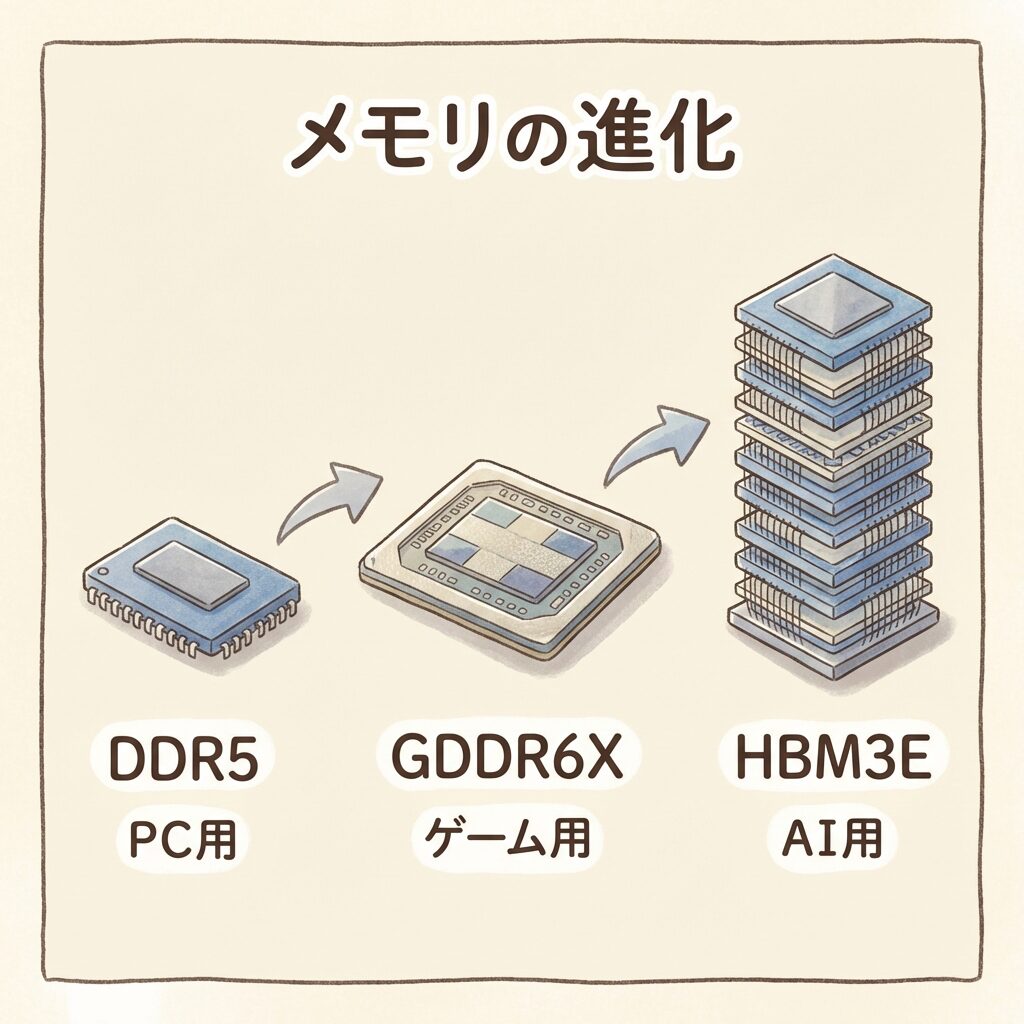
DRAMにはいくつかの種類があります。用途によって使い分けられています。
DDR4 / DDR5
PCやサーバーのCPU向け。最も普及しているDRAM。
GDDR6 / GDDR6X
ゲーム向けGPU専用。DDRより速く、GeForce系に採用。
HBM(High Bandwidth Memory)
AI向けGPU専用。技術的にはDRAMの一種だが、構造が根本的に異なる。
ポイント:HBMは「DRAMファミリー」の一員 技術的には、HBMもDRAMを素材として使っています。しかし構造・用途・価格がまったく異なるため、業界では事実上「別物」として扱われます。この記事では「普通のDRAM(DDR/GDDR)」とHBMを比較します。
2026年時点の補足:ゲーム用GPUはGDDR7へ
GeForce RTX 50シリーズからは、GDDR6Xの次の世代のGDDR7が使われています。たとえばRTX 5090は32GBのGDDR7を512ビットの幅で載せています。HBMとの違い(チップを並べるか、積むか)は変わりません。
DRAMとHBMを比較する「5つの視点」
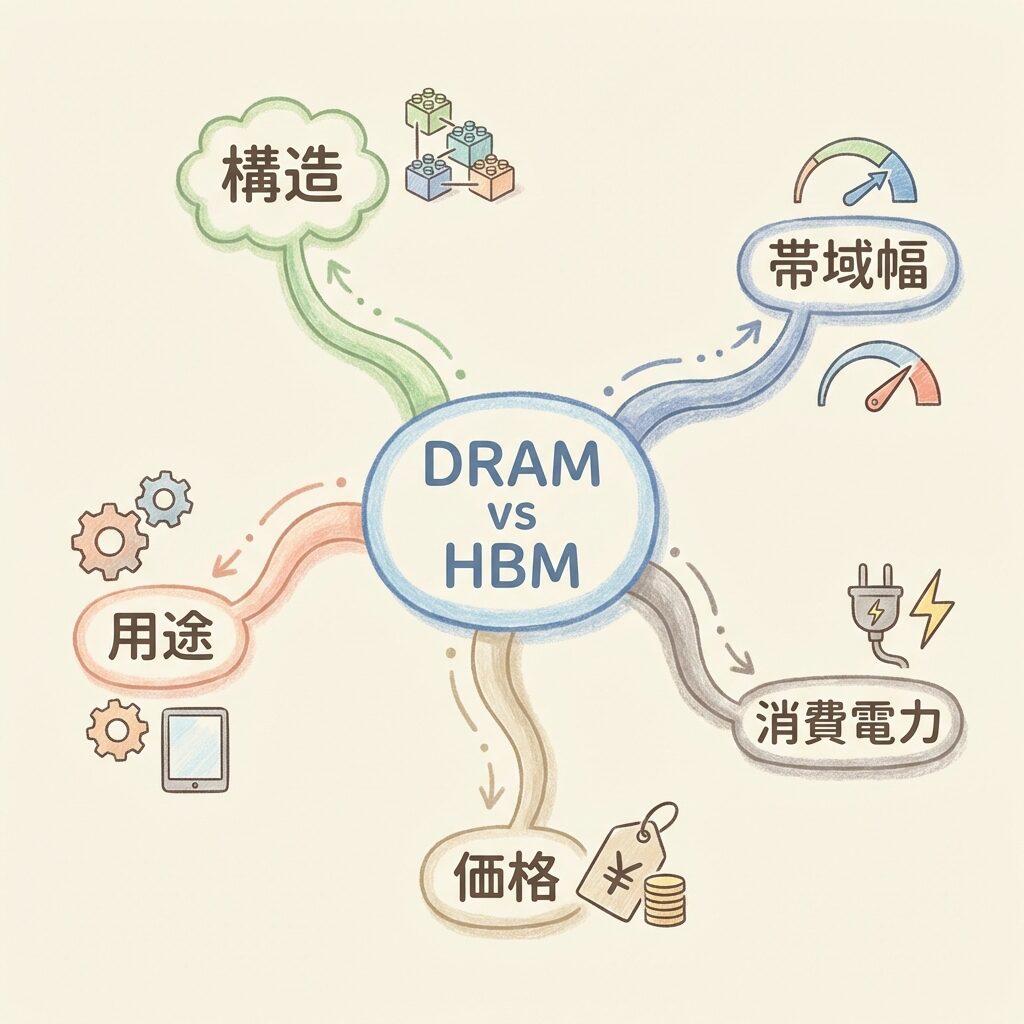
比較する前に「全体地図」を確認しよう
DRAMとHBMは、以下の5つの視点で比較するとその違いがはっきりと見えてきます。この地図を頭に入れてから各比較を読むと、より理解しやすくなります。
比較① 構造:「平屋」vs「超高層マンション」
たとえるなら…
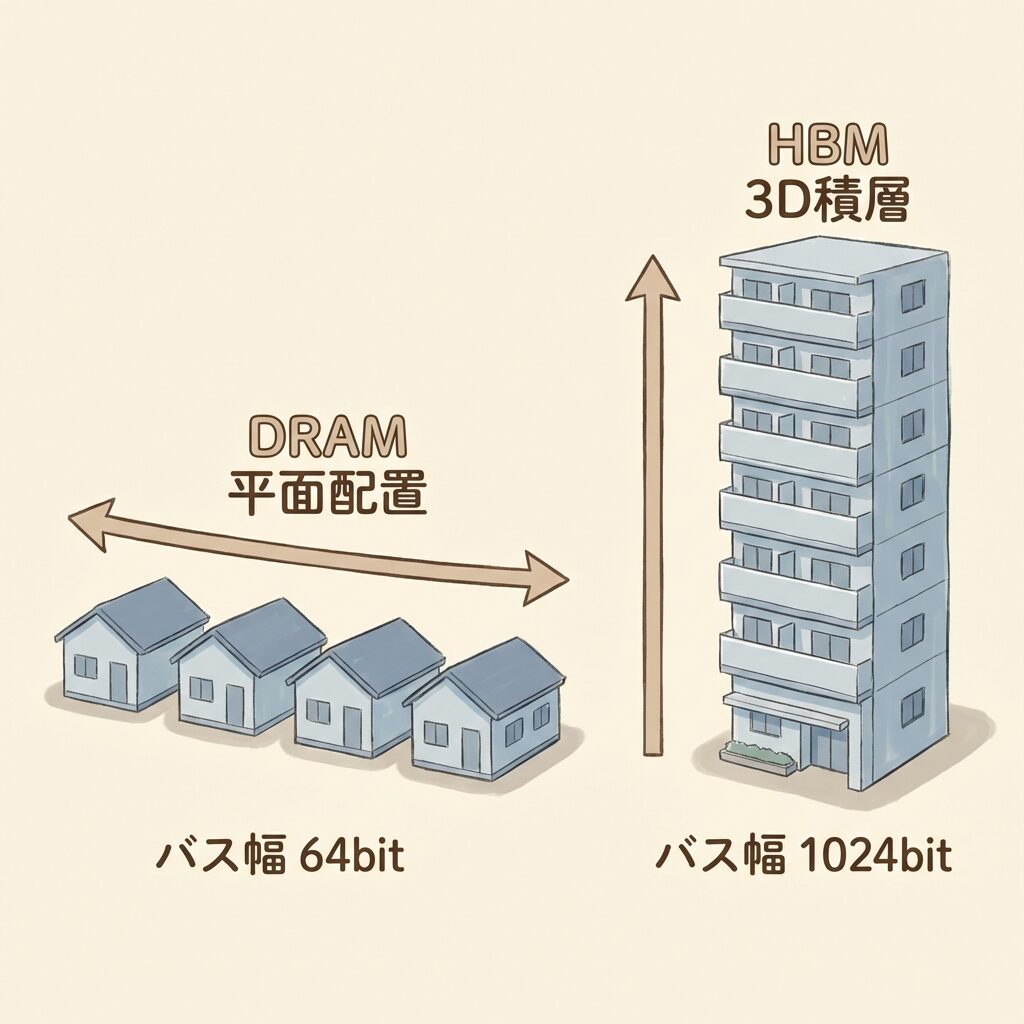
普通のDRAMは「平屋の家を横に並べた住宅地」です。土地(基板面積)をたくさん使います。HBMは「超高層マンション」。同じ土地に何十倍もの部屋(記憶容量)を詰め込めます。しかも、各階を縦に直接つなぐ「エレベーター(TSV)」があるので、データのやりとりが超高速です。
普通のDRAM(DDR/GDDR)
▭ ▭ ▭ ▭
・チップを横(平面) に並べる
HBM(3D積層)
▭
・チップを縦(3D) に積み重ねる
HBM3Eのバス幅
1,024 bit
(×スタック数)
用語メモ:バス幅
データが一度に通れる「車線数」のこと。64bitは1車線、1024bitは16車線のイメージ。車線が多いほど同じ時間に多くのデータを運べる。
比較② 帯域幅:DDR5の「24倍」の速さとは?
数字で見ると、差の大きさが一目でわかる
HBM3E
1,200
GB/s(1.2 TB/s)
「24倍」を体感するたとえ
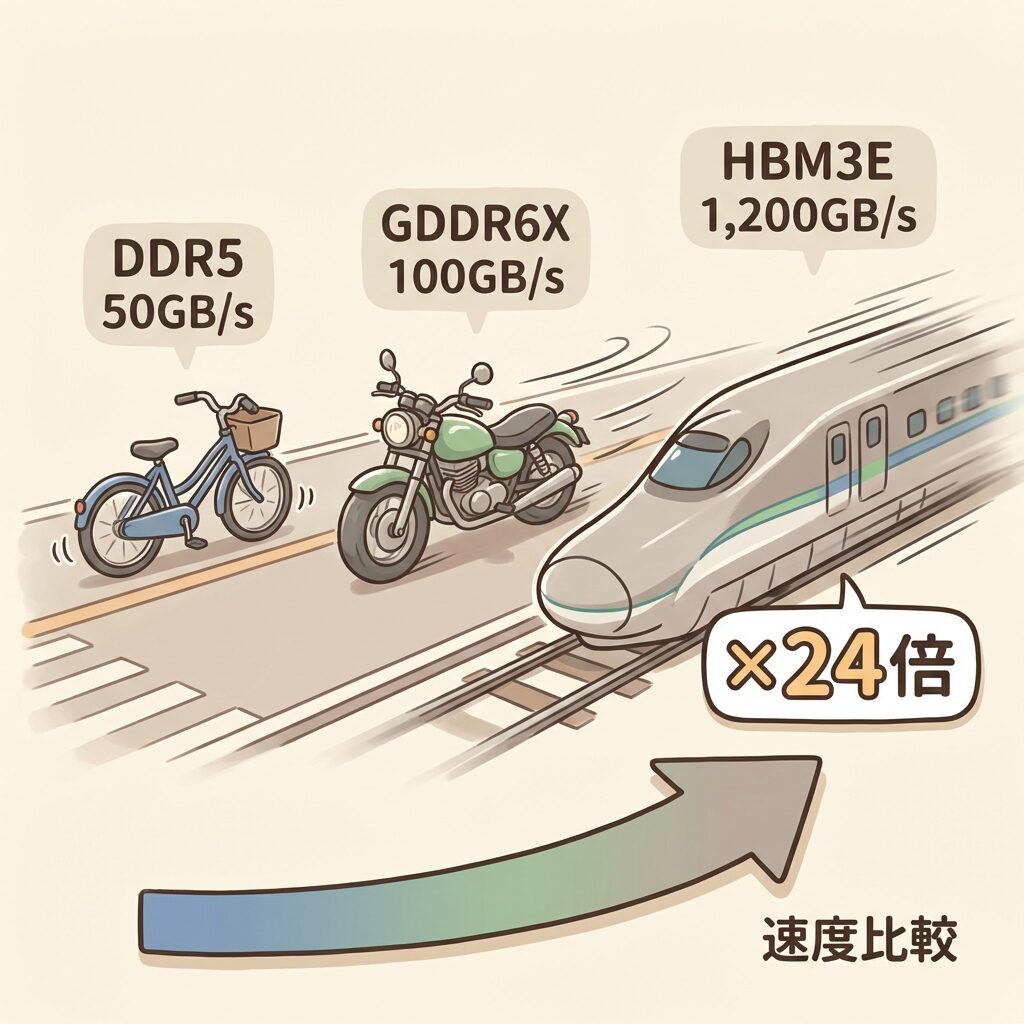
DDR5が「自転車(時速20km)」で荷物を運ぶとしたら、HBM3Eは「新幹線(時速480km)」です。同じ1時間でも、運べる荷物の量がまったく違います。AIが大量のデータを処理するには、この「新幹線」級のスピードが必要なのです。
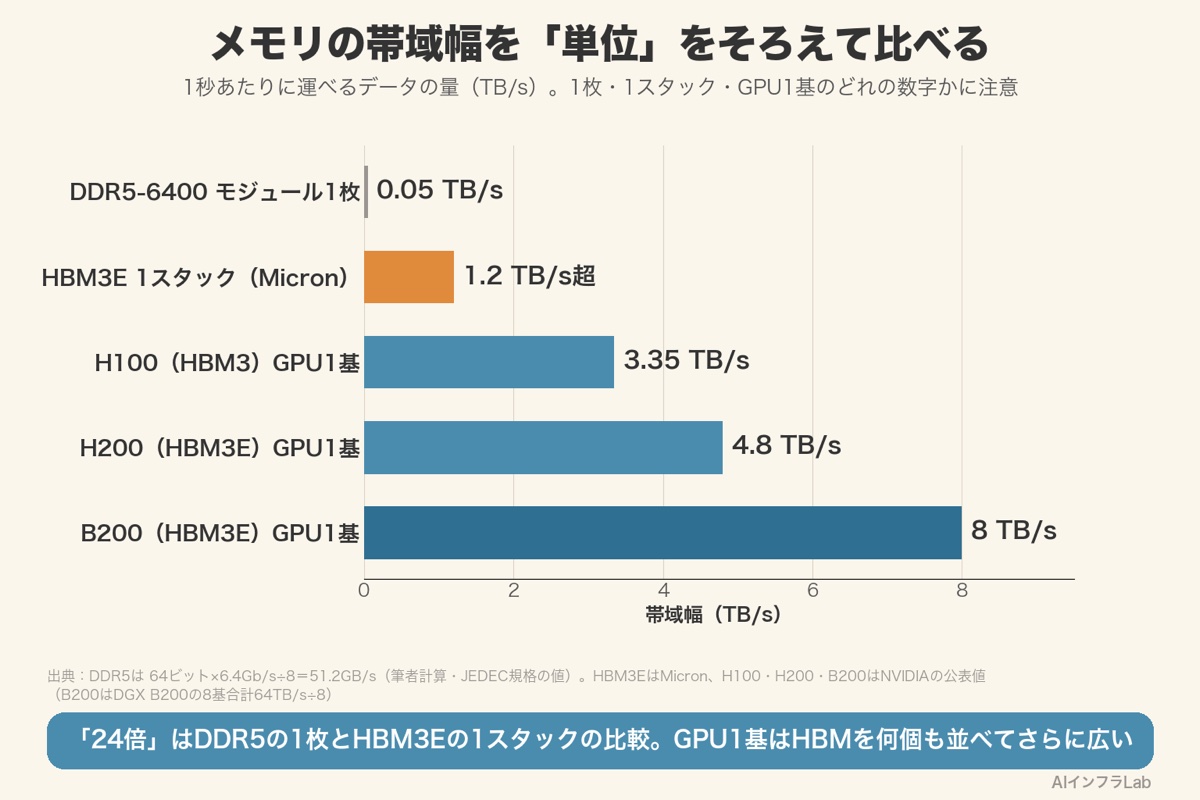
帯域幅は「1枚・1スタック・GPU1基」のどれの数字かで大きく変わる 数字の「単位」に注意:1枚・1チップ・1スタック・GPU1基
上の「24倍」は、DDR5の
モジュール1枚 (約50GB/s)とHBM3Eの
1スタック (約1.2TB/s)を比べたものです。GDDR6Xの約100GB/sは
チップ1個 の目安です。実際のGPUは、メモリを何個も並べて使います。GPU1基あたりで比べると、次のようになります。
比べる単位 メモリ 帯域幅
DDR5-6400 モジュール1枚 DDR5 51.2GB/s(64ビット×6.4Gb/s÷8) HBM3E 1スタック HBM3E 1.2TB/s超(Micron) H200 GPU1基 HBM3E 141GB 4.8TB/s B200 GPU1基 HBM3E 8TB/s(DGX B200の8基合計64TB/s÷8)
「HBMはDRAMの何倍速いか」は、どの単位で比べるかで大きく変わります。数字を見るときは、1枚か1スタックかGPU1基かを確かめてください。
比較③④⑤:消費電力・価格・用途の違い
消費電力:HBMは「効率がいい」が「トータルは大きい」
普通のDRAM(GDDR6など)
GPU本体から離れた場所に配置
信号の伝送距離が長い → 消費電力大
1GB/sあたりの消費電力:比較的高い
HBM
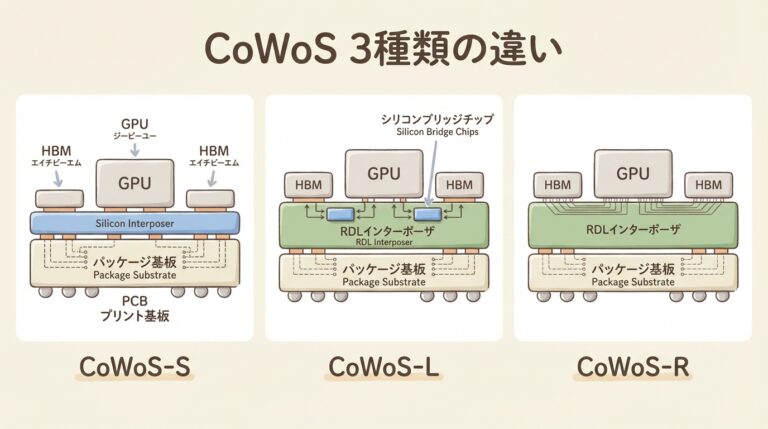
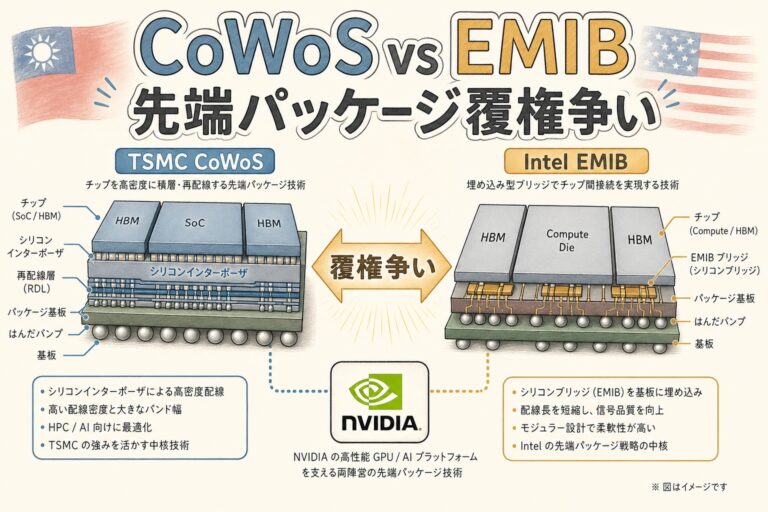
GPUの隣に直接配置(インターポーザー)
信号の伝送距離が極めて短い → 効率的
1GB/sあたりの消費電力:GDDRより低い
注意:「効率的」と「トータル消費電力が小さい」は別の話 HBMは「単位帯域幅あたりの消費電力」が少ない(効率的)ですが、HBMを搭載するH100/H200は1枚あたり700W以上の電力を消費します。これはHBMが効率的でも、GPU全体の演算量が桁違いに大きいためです。
価格:HBMはDDR5の「数十倍」
用途:「何に使うか」がすべてを決める
DDR5の出番
PC・サーバー・ノートPC。日常の計算処理。コスパ最優先の用途。
GDDRの出番
ゲーミングGPU(GeForce・Radeon)。グラフィック描画特化。
HBMの出番
AIアクセラレータ(H100/H200)・スパコン。巨大データの超高速処理。
HBMとDDR5・GDDRの違い──同じDRAMセルなのに、なぜ速さがけた違いなのか
DDR5・GDDR・HBMは、どれも「DRAM」です。記憶する1マス(セル)はトランジスタ1個とコンデンサ1個という同じ作りで、違うのはセルをどう束ねて外とつなぐか 。帯域幅は「ビット幅 × 1ピンの速さ」で決まるので、JEDEC(半導体の標準化団体)の規格の数字でその2つを並べると、違いが一目でわかります。
規格で比べる:DDR5・GDDR7・HBM3・HBM4
比較項目
DDR5(PC・サーバー)
GDDR7(ゲームGPU)
HBM3(AI GPU)
HBM4(次世代)
規格(公開)
JESD79-5C(2024年4月) JESD239(2024年3月) JESD238(2022年1月) JESD270-4(2025年4月)
1ピンの速さ
最大8,800MT/s
初期製品で32Gbps(Samsungのコメント)
最大6.4Gb/s
最大8Gb/s
ビット幅
モジュール1枚で64ビット(比較①)
チップを並べて束ねる(比較①の例は384ビット)
1,024ビット/スタック
2,048ビット/スタック
帯域幅
モジュール1枚で〜50GB/s(比較②)
チップ1個で最大192GB/s
819GB/s/スタック
2TB/s/スタック
容量
—
チップ1個で16〜32Gbit
4〜64GB/スタック(4〜12段、16段は将来)
最大64GB/スタック(32Gb×16段)
載せ方
DIMM(差し替え可)
GPUの基板に直付け
インターポーザー上でGPUの隣(2.5D)
同左
※ HBM3E(量産中のAI GPU向け)は規格の改訂版で、Micronは1ピン9.2Gbps超・1スタック1.2TB/s超・容量24GB(8段)/36GB(12段)と公表しています(出典:Micron HBM3E )。GDDR7のビット幅と容量はJEDECの発表、DDR5の64ビット・〜50GB/sはこの記事の比較①②の値です。
計算してみる:帯域幅 = ビット幅 × 1ピンの速さ ÷ 8
HBM3は 1,024ビット × 6.4Gb/s ÷ 8 = 819GB/s 。JEDECが発表した「819GB/s」と一致します。HBM4は 2,048ビット × 8Gb/s ÷ 8 = 2,048GB/s ≒ 2TB/s 。DDR5はモジュール1枚で 64ビット × 8.8Gb/s ÷ 8 = 70.4GB/s が規格上の上限で、サーバーで多い6,400MT/sなら51.2GB/s(比較②の「〜50GB/s」)です。つまり、HBMが速いのは1ピンが速いからではありません。DDR5の16倍(HBM3)〜32倍(HBM4)のビット幅 を、チップを縦に積んでTSVで束ねることで実現しているのです。GDDRは1ピンの速さで稼ぐ方式で、チップ1個が32Gbpsなら192GB/sに届くのはビット幅が狭いからです。
この節のポイント
DDR5は「差し替えられる汎用品」、GDDRは「1ピンを速くしてゲーム用GPUの基板に直付け」、HBMは「ビット幅を桁違いに広げてGPUの隣に積む専用品」。同じDRAMセルでも、束ね方と置き場所で役割が分かれます。ノートPC向けのLPDDRやサーバー向けのSOCAMMとの使い分けはHBM・LPDDR・SOCAMMの使い分け で解説しています。
このブロックの参照データ
6.4Gb/s=819GB/s、16チャネル、4〜64GB
8Gb/s×2048ビット=2TB/s、4〜16段、64GB
HBM3 は1024ビット幅(64ビット×16チャネル)
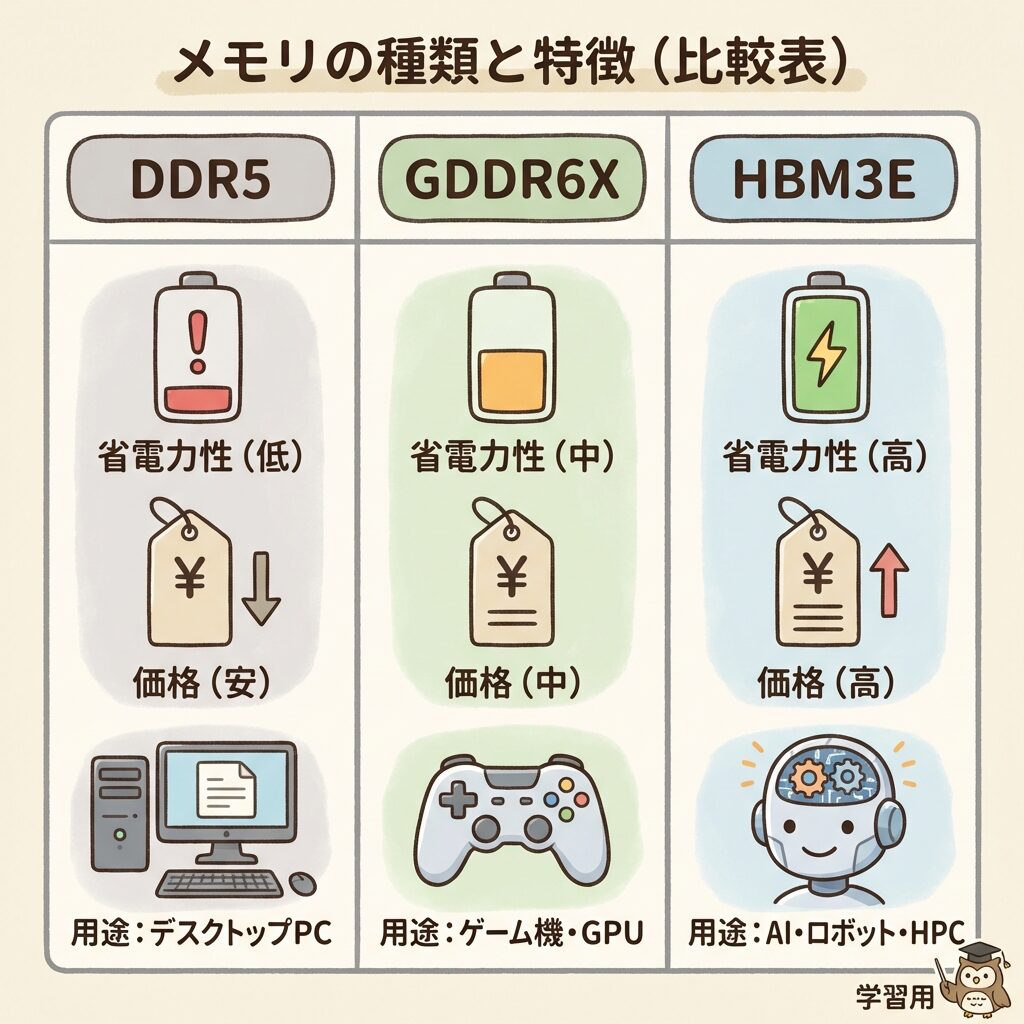
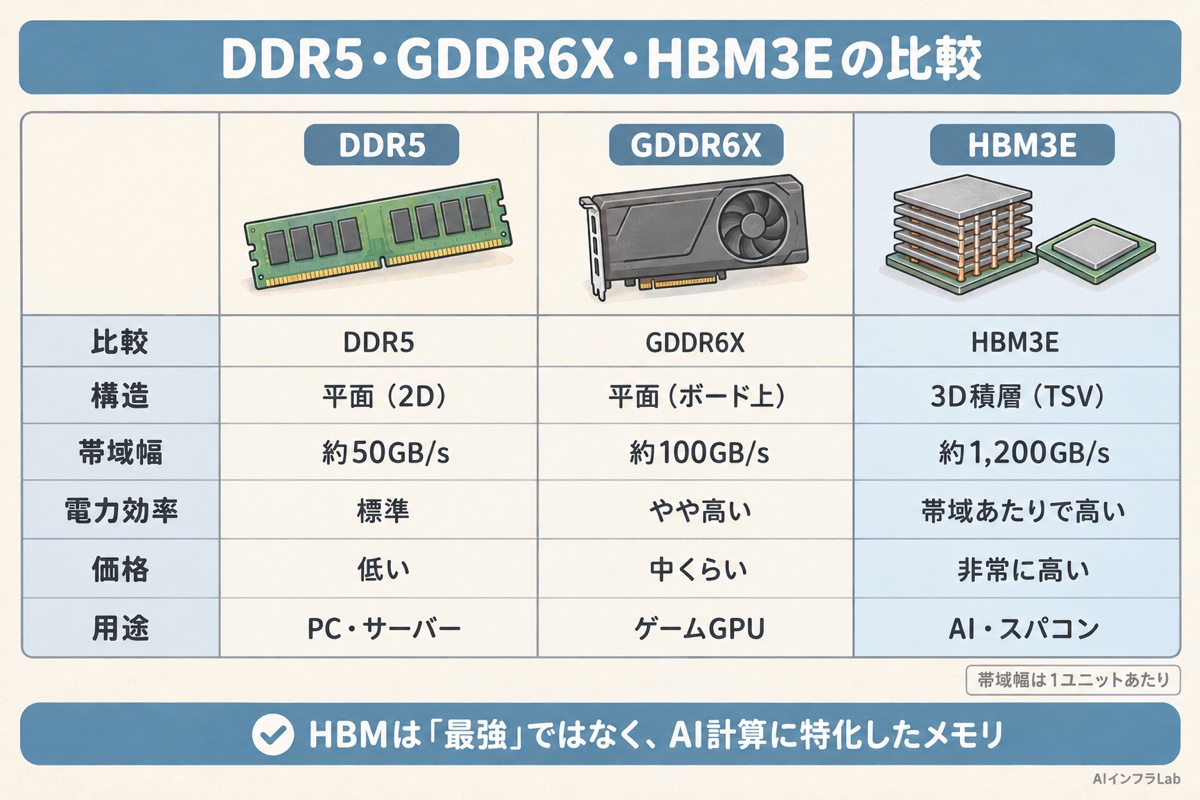
【保存版】5視点の全比較を一枚の表でまとめる
ここまで比較してきた5つの視点を、一枚の表に集約します。「DRAMとHBMの違いを人に説明したい」というときに役立ててください。
比較視点
DDR5(PCメモリ)
GDDR6X(ゲームGPU)
HBM3E(AI GPU)
① 構造
平面(2D)
平面(2D)
3D積層(TSV)
② 帯域幅
〜50 GB/s
〜100 GB/s
〜1,200 GB/s(DDR5の約24倍)
③ 消費電力効率
標準的
やや高い
帯域幅あたりの
④ 価格
低(数千円〜)
中(数万円〜)
非常に高(数万〜数十万円/スタック)
⑤ 用途
PC・サーバー全般
ゲーミングGPU
AIアクセラレータ
製造難度
低〜中
中
極めて高(世界3社のみ量産可能)
この表のポイント HBMは帯域幅で圧倒的に勝りますが、価格・製造難度でも圧倒的に高い。「HBMが最強」ではなく、「AI計算という超特定の用途に最適化された特殊メモリ」です。普通のPCにHBMを載せても意味はありません。
「どちらが優れているか」——答えは「用途による」
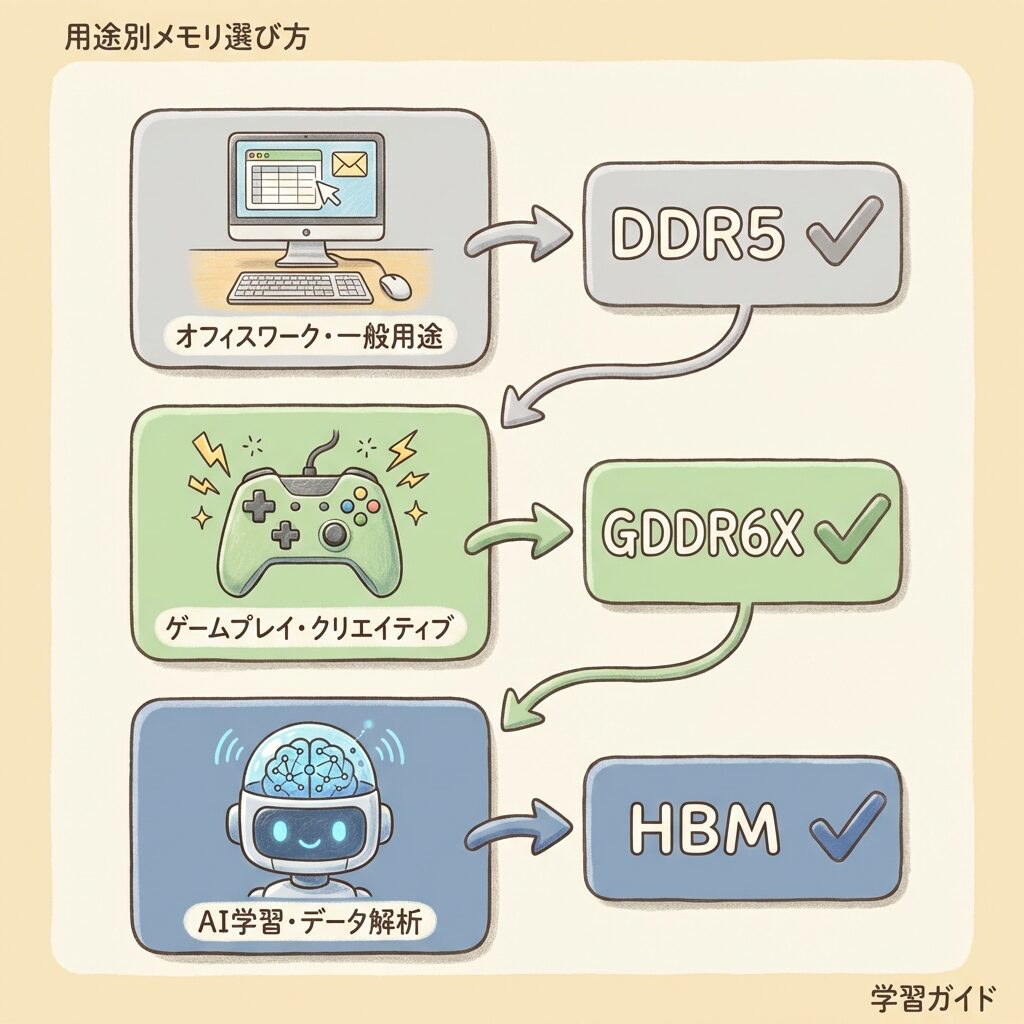
場面別:どのメモリを選ぶべきか
普通のPC・サーバー作業
文書作成・Webブラウズ・
DDR5で十分
ゲーム・CGレンダリング
グラフィック処理・
GDDR6が最適
AI学習・推論・スパコン
LLMトレーニング・
HBM一択
よくある誤解:「HBMはすべてにおいて最強」ではない HBMを普通のPCに載せても意味はありません。DRAMとHBMは「競合」ではなく「役割分担」です。DDR5は日常PCに最適、HBMはAI計算に特化——それぞれが「正しい場所で正しく使われる」ものです。高価なHBMをゲームPCに使っても、GDDR6Xと大差はありません。
学生・技術者にとって、この比較はどう役立つか
あなたにとっての意味
学生: 「なぜDRAMを縦に積むと速くなるのか」という問いは、半導体物理・材料・製造プロセス・システム設計が交差する教育的な問いです。TSV・インターポーザー・2.5D/3D実装は、今後の半導体エンジニアが必ず直面する技術領域です。情報系だけでなく、電気・材料・機械系の学生にとってもキャリアに直結します。「DRAMとHBMの違いを説明できる」だけで、面接・研究発表での差別化になります。技術者: AIシステムの設計・評価をするとき、「このタスクはメモリ帯域がボトルネックか、演算がボトルネックか」という視点が重要です。HBMの帯域幅(H100: 3.35TB/s、H200: 4.8TB/s)を知っていると、モデルのメモリ使用量と推論速度の関係を定量的に考えられます。「GPUを増やせば速くなる」という単純な発想から抜け出すための基礎知識です。
よくある質問(FAQ)
Q. HBMはDRAMの一種なのに、なぜ別物として扱われるの?
A. HBMはDRAMチップを素材に使いますが、構造(3D積層)・製造方法(TSV)・実装方式(インターポーザー) がまったく異なります。普通のDRAMは「単体のチップをスロットに挿す」のに対し、HBMは「複数チップを縦積みにしてGPUの隣に直接配置」します。性能・価格・用途の差が大きすぎるため、業界では実質的に別物として扱われています。
Q. 帯域幅が24倍もあるなら、なぜHBMをPCに使わないの?
A. 主に2つの理由があります。①価格 :HBMはDDR5の数十倍以上の価格。PCに搭載すると本体価格が数十万円以上になります。②実装の難しさ :HBMはインターポーザーという特殊な中間基板が必要で、普通のマザーボードには搭載できません。また、普通のPCの処理では帯域幅のボトルネックは発生しにくく、HBMの性能を活かしきれません。
Q. HBMが普及したら、将来はPCにも使われるようになる?
A. 短期的には難しいでしょう。HBMは製造できる企業が世界3社のみで、生産量もAI向け需要で逼迫しています。ただし、HBMの技術(3D積層・TSV)は将来のPC向けメモリ設計にも影響を与えており、長期的にはPC向けにコストダウンされた派生規格が登場する可能性はあります 。現時点では「AI専用」と考えてください。
この記事のテーマを、本でもっと深く PR(アフィリエイト広告)
DRAMとHBMの違いの前提になる、半導体の基本から押さえたい方に。本書(SBクリエイティブ)は、半導体の基本とニュース、産業構造、製造のしくみ、最新動向までを、図解で体系的に解説しています。
¥1,980 (2026/10/05 21:02時点 | Amazon調べ)
ポチップ
S
シラス
電験三種・QC検定1級 / メーカーでパワエレ設計・品質保証 実務10年
メーカーで回路設計と生産技術(品質改善)に携わってきた経験をもとに、AIインフラを支える半導体・電力・冷却の仕組みを、図解でやさしく解説しています。
テーマ別に、もっと深く学ぶ 気になるところから読んでも大丈夫です。どの記事も、はじめての方にもわかるように図解で書いています。
HBM・先端パッケージをもっと深く
つまずきやすい「違い」を解決
あわせて知りたい、隣のテーマ
記事の更新情報を受け取りたい方へ
新しい記事が公開されたら、Xアカウント @shirasusolo でお知らせします。AIインフラの構造を一緒に学んでいきましょう。




コメント